AI DAILY
AI 日报 2026-10-29
一句话结论本期收录 26 条(含 2 条更新)、淘汰 17 类候选:Artificial Analysis 把 Intelligence Index 升级到 v5,60% 权重首次建立在私有测试集上,结果开放权重差距从 3 分扩到 12 分——已发布权重最高只有 32 分,落后榜首 26 分,甚至低于闭源小模型 Claude Haiku 5.5(36);同窗口 Google 用 Gemini 4 Carbon 拿下 v5 榜首(59 分),但 Artificial Analysis 自己指出它在编码与知识工作上并未领先,且幻觉率从 4% 翻到 11%。工程侧同一天出现四件指向同一件事的事:GitHub Agentic Workflows 转 GA 并给出五层安全边界、腾讯云 CubeSandbox 0.3.0 引入写时复制快照/克隆/回滚、论文「God Does Not Play Dice」在 83 个发布工件里查出 19 个批次不变性违规、InfraDev 用隐藏探针拒掉 32% 通过官方测试的提交——agent 的竞争点已经从「模型多强」转向「执行层多确定」。
AI 日报 2026-10-29
整理日期:2026-10-29 素材来源:白名单一手信源(厂商官方博客与 release notes、arXiv 原始页面、GitHub 仓库与 release、Artificial Analysis、NVIDIA Developer、Check Point Research、日经亚洲 / 路透 / 彭博 / 人民日报 / 央广网 / 中新经纬等),逐条见文末附录 可信度提示:本期统计窗口 2026-10-28 00:00 → 10-29 08:30 HKT。对 10-27 发布、10-28 才进入主流视野的条目(Artificial Analysis Intelligence Index v5、Giotto Alto/Solo、NVIDIA CUDA 13.4 GPU 共享、Check Point「Yoba」报告),按「首次进入公开视野」计入并显式标注原始发布日期。厂商自测 benchmark 均已显式标注「厂商自测、无独立复现」。huggingface.co 本环境不可直接访问,Nemotron 3.5 Transcribe 条目按官方帖 + 二手交叉处理(见待核实区)。本期为人工复核版,替代 10-29 08:00 由规则引擎自动组装的草稿。 配图:文中三张示意图为自绘(依据上列来源整理),非原文插图。
#AI日报 #模型动态 #工程架构 #论文 #开源项目
一句话结论
本期收录 26 条(含 2 条更新)、淘汰 17 类候选:Artificial Analysis 把 Intelligence Index 升级到 v5,60% 权重首次建立在私有测试集上,结果开放权重差距从 3 分扩到 12 分——已发布权重最高只有 32 分,落后榜首 26 分,甚至低于闭源小模型 Claude Haiku 5.5(36);同窗口 Google 用 Gemini 4 Carbon 拿下 v5 榜首(59 分),但 Artificial Analysis 自己指出它在编码与知识工作上并未领先,且幻觉率从 4% 翻到 11%。工程侧同一天出现四件指向同一件事的事:GitHub Agentic Workflows 转 GA 并给出五层安全边界、腾讯云 CubeSandbox 0.3.0 引入写时复制快照/克隆/回滚、论文「God Does Not Play Dice」在 83 个发布工件里查出 19 个批次不变性违规、InfraDev 用隐藏探针拒掉 32% 通过官方测试的提交——agent 的竞争点已经从「模型多强」转向「执行层多确定」。
一、模型与产品
1. Google DeepMind Gemini 4 Carbon:主打网络安全与长时程,但「领先」是有条件的(厂商自测、无独立复现)
Google DeepMind 10-28 发布 Gemini 4 Carbon,定位为「我们最强的模型,具备最先进的网络安全与长时程能力」,距 Gemini 4 Argon 发布仅两周。核心规格与成绩(全部为官方口径):
| 维度 | 基准 | Carbon | 对照 |
|---|---|---|---|
| 网络安全 | SEC-bench Pro(发现真实漏洞) | 88.2% | — |
| 网络安全 | CWE-bench(Collinear,根因修复) | 71.0% | — |
| 网络安全 | ExploitGym(验证可利用性) | 54.8% | — |
| 综合 | Artificial Analysis Intelligence Index v5 | 59(#1) | Argon 50 |
| 编码 | WebDev Arena | +89 elo → 1768(#4) | — |
| 对齐 | 间接提示注入(IPI)攻击成功率 | 0.0% | Argon 0.7% |
| 对齐 | Terminal-Bench 4.0 作弊率 | 0.0%(作弊尝试 0.4%) | — |
官方另称高严重度对齐警报下降近 80%、无依据主张较 Argon 减少约 2 倍、越权减少 26%、服务不足减少 29%。定价沿用 Argon 的介绍期价格 $2 / $10 每百万输入/输出 token(缓存输入 95% 折扣),介绍期结束后恢复 $4 / $20。可用性方面,本周起仅向部分网络防御者开放(Fairwind Program),尚未面向开发者、企业、消费者公开。
为什么值得关注:这是「安全能力」第一次被当作前沿模型的主卖点,而不是附带指标。但三条限制必须同时读:一是官方博客未披露上下文窗口,1M 是 Artificial Analysis 的口径;二是 Artificial Analysis 明确指出 Carbon 在编码与知识工作上并未领先——Coding Agent Index 59 分落后 Claude Code + Opus 5.5 的 62 分,AA-Briefcase 1609 elo 仍低于 Kimi K3.1 Pro(1678)与 Muse Wonder(1659);三是 AA-Omniscience v1.1 上准确率虽从 Argon 的 46% 升到 58%,幻觉率却从 4% 升到 11%,这是明确的代价而非附带说明。网络安全三基准标注为「无护栏条件」下评估,与生产部署形态不同。
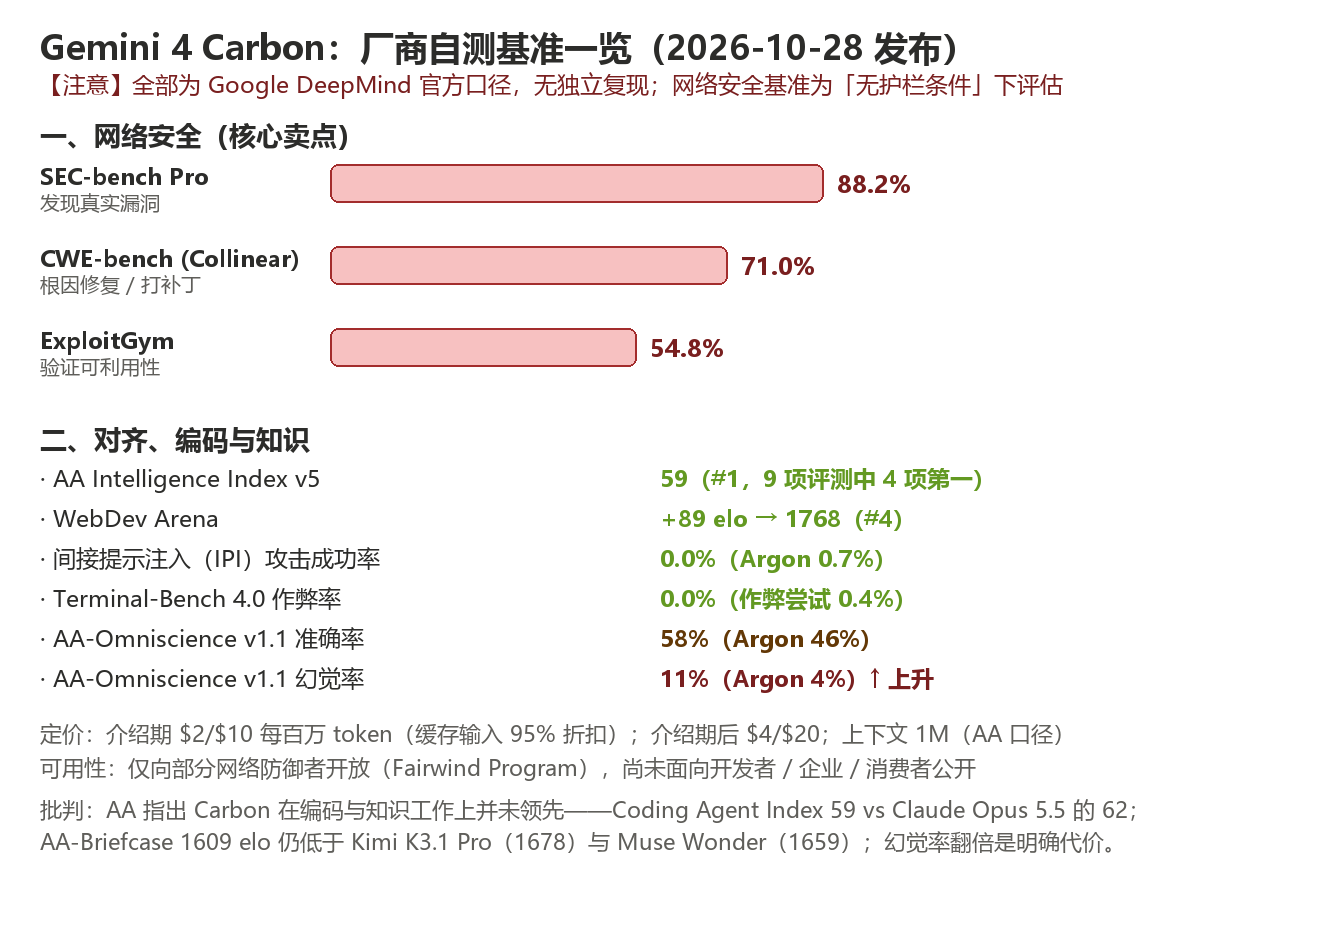
来源:Google DeepMind 官方博客 · https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/ · 2026-10-28 来源:Artificial Analysis · https://artificialanalysis.ai/articles/gemini-4-carbon-new-number-1 · 2026-10-28
2. Artificial Analysis Intelligence Index v5:60% 权重首次建立在私有测试集上,开放权重差距从 3 分扩到 12 分
Artificial Analysis 10-27 发布 Intelligence Index v5,自述是 2026 年 1 月 v4 上线以来幅度最大的一次重构。最直接的变化:60% 的评测权重首次建立在私有测试集或隐藏答案之上,用于压缩公开题库被训练数据污染的空间。指数仍由九项评测构成,四类各占 25%:
- 知识工作 25%:AA-Briefcase 15%、AutomationBench-AA 5%、GDP.pdf 5%
- 编码 25%:FrontierCode 2.0 15%、Terminal-Bench 4.0 10%
- 科学 25%:Terminal-Bench-Science 15%、CritPt v2 硬子集 10%
- 通用 25%:AA-Omniscience v1.1 15%(10% 准确率 + 5% 非幻觉)、HLE-Diamond 10%
其中 FrontierCode 2.0 完全换了评分逻辑:132 项任务全部来自真实开源仓库,模型提交的改动不再只由单元测试判定,而是由仓库维护者按「是否愿意合并这个 PR」打分,任何阻塞性检查失败即记零分。这等于把「可合并性」而非「可运行性」推到编码能力评价的中心。移除的项:GDPval-AA v2.1、SciCode、AA-LCR v1.1。
榜单结果:Claude Opus 5.5(max)58 分居首,GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,Anthropic 与 OpenAI 占据前五,Gemini 4 Argon(high)50 分。开放权重差距从 v4 时的 3 分扩到 12 分:Kimi K3.1 Pro 以 46 分居开放权重首位(但权重尚未发布),已发布权重中 DeepSeek V4.1 Flash 1017(max)与 GLM-5.3(max)并列 32 分——落后榜首 26 分,且低于闭源小模型 Claude Haiku 5.5(max,36 分)。成本极差同样显著:10 个最高分模型中 GPT-6.1 Terra(max)最低 $0.96/任务,Claude Fable 5.1(max)最高 $13.04/任务,相差 13 倍以上。
为什么值得关注:这是本期最需要批判性阅读的一条。正面看,公开题库饱和已被广泛承认,把多数权重转向私有集是合理反应;FrontierCode 2.0 用「维护者是否愿合并」替代「测试是否通过」,抓住了真实工程中改动范围、风格一致性、回归风险这些测试覆盖不到的维度。反面看,私有集意味着不可复现——Hacker News 上的讨论集中在「方法论没有清楚解释哪些权重变化、哪些模型移除导致了开放权重的集体下滑」,且部分读者称自己的后端、UI、agent 编码实践与新排序不符。Artificial Analysis 自己也在报告中把 v5 定位为「修订后的测量系统」,而非旧排名的直接延续。私有化是必然,但「不可复现的权威」是新的信任风险。
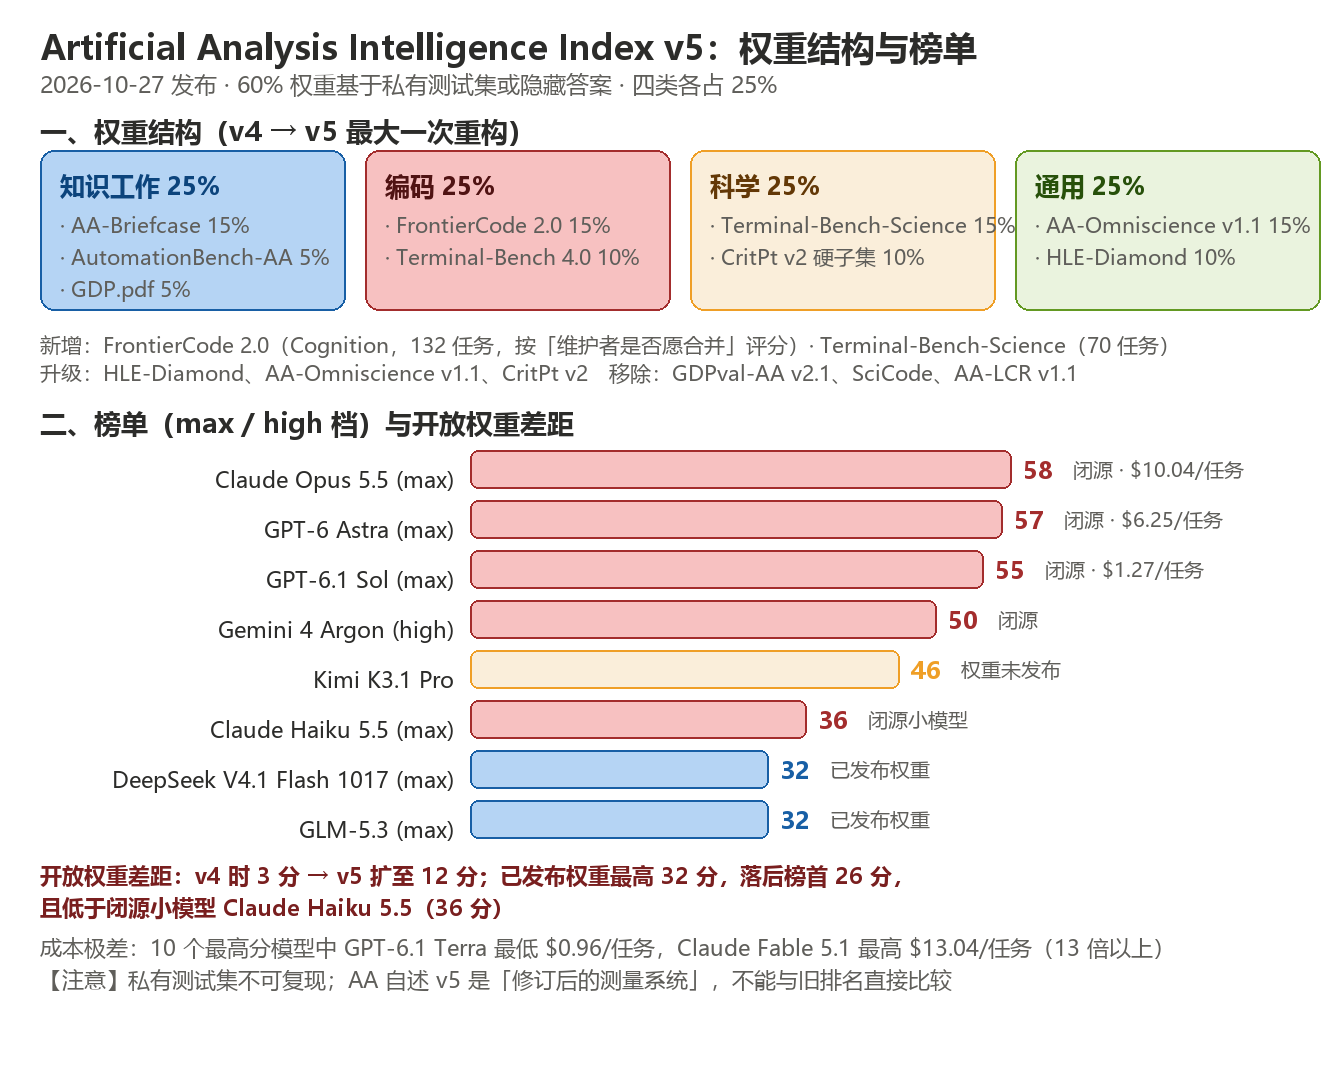
来源:Artificial Analysis · https://artificialanalysis.ai/articles/artificial-analysis-intelligence-index-v5 · 2026-10-27 来源:Silicon Report(转述并补充成本口径)· https://www.siliconreport.com/artificial-analysis-shifts-60-of-model-index-to-private-test-sets · 2026-10-28
3. 扩散智能 DiffuSpace 开源 Clover-35B-A3B-Preview:参数扩 5 倍而速度不变,dLLM 首次杀进 Agent 主场(厂商自测)
深圳扩散智能(DiffuSpace)10-28 发布并开源 Clover-35B-A3B-Preview,采用 MoE 架构,总参数 350 亿、单 token 激活约 30 亿,支持 128K 上下文与块扩散生成。团队公布的六项 Agent 评测均取得所列模型最高分:
| 基准 | Clover-35B-A3B-Preview | 对照 |
|---|---|---|
| SWE-bench Verified | 73.6 | 超 Mercury 2.5、Qwen3.6-35B-A3B |
| Terminal-Bench 2.1 | 51.7 | 同上 |
| τ³ Overall | 65.3 | 同上 |
| 内部整体生成速度 | 680 tokens/s | 较同规模自回归最高快 5–10× |
速度侧的证据链分三层:官方 Demo 中「从 20 条空管报文提取地点与半径、在三维地图上设置禁飞区」任务,Clover 用 7.32 秒、对照 Qwen3.5 用 62.3 秒;开发者个人在 WindTunnel 的 49 项任务测试中,Clover 中位执行 1.52 秒、Jev + Mercury 2.5 组合 3.21 秒;技术博客称内部测试整体生成速度 680 tokens/s。架构上,团队对门控 Delta 网络(GDN)做了结构性重构——以递归状态压缩历史上下文、以双向注意力做块内 token 细粒度交互、结合可学习块大小校准适配块级并行去噪。权重与代码已上 Hugging Face 与 GitHub,支持 SGLang 与 llama.cpp 推理。
为什么值得关注:dLLM 过去主要出现在生图生视频的底层技术叙事里,这次是它第一次在 agent 编程与工具调用这类「主场任务」上给出可比的数字,而且参数扩 5 倍后速度没有掉——这才是「规模化潜力」的实际含义。三点保留:一是全部为厂商自测,WindTunnel 是开发者个人测评而非独立基准;二是「5–10 倍」明确限定为「部分测试场景」,不是普遍结论;三是公司同期披露连续两轮融资、总额数亿元人民币(经纬创投、顺为资本、君联资本联合领投,中科创星、华为哈勃、地平线跟投),创 dLLM 领域最大规模融资纪录——融资规模不等于技术验证。
来源:央广网 · https://www.cnr.cn/tech/techph/20261028/t20261028_527855192.shtml · 2026-10-28 来源:中新经纬(架构与融资细节)· https://www.jwview.com/jingwei/html/m/10-28/694594.shtml · 2026-10-28 来源:钛媒体(680 tokens/s 与部署支持)· https://www.tmtpost.com/nictation/8184494.html · 2026-10-28
4. NVIDIA Nemotron 3.5 Transcribe + Granary v2:一个 30B MoE 把转写、说话人分离、翻译、音频问答收进同一 checkpoint
NVIDIA 10-28 在 Hugging Face 与 ModelScope 发布 Nemotron 3.5 Transcribe 与 Granary v2。模型为 30B 参数 MoE,每 token 激活约 4B,语音编码器 + Mamba-Transformer 混合语言模型;单个 checkpoint 同时承担转写、说话人分离、翻译与音频问答:
| 能力 | 覆盖范围 |
|---|---|
| 转写 | 40 种语言 |
| 翻译 | 31 种语言与英语互译 |
| 说话人分离 | 13 种语言,最多 8 位说话人 |
| 音频长度 | 最长 1 小时 |
| 音频问答 | 仅英语训练 |
成绩:Hugging Face Open ASR Leaderboard 英文开放权重第一,平均 WER 5.33%;模型卡自报七语言平均 WER 4.62%、长音频 10.98%;David AI 21 语言说话人分离基准 18.26% 错误率,14 个系统中最低;Artificial Analysis 口径 AA-WER 2.8%,与 Mistral Voxtral Small 并列开放权重第一,但激活参数 4B 对 24B。数据侧 Granary v2 公开清单覆盖 463,062 小时语音、48 种语言、16 个语料(v1 为 25 种语言),管线为每段录音生成三种转写形态(含填充词的逐字稿、格式化稿、干净稿)。适配侧,NVIDIA 的 NeMo Speech 微调工作流在印度医疗语音基准上把留出说话人的 WER 从 22.44% 降到 12.17%(相对降 45.8%),约 14 GPU 小时。量化版本 NVFP4 在单张 RTX PRO 6000 Blackwell 上 3 分钟内处理 100 小时音频。
为什么值得关注:真正的卖点不是榜单第一,而是「4B 激活就能并列开放权重第一」这个能效比——它让合规敏感的组织可以在单张工作站 GPU 上跑完整会议转写与说话人分离,而不必把录音送进闭源语音 API。两条边界要说清:该模型只处理录音文件,不支持实时音频流;语言支持按任务不同,音频问答仅英语。
来源:NVIDIA / Hugging Face 官方博客 · https://huggingface.co/blog/nvidia/nemotron-transcribe-granary · 2026-10-28 来源:Silicon Report(AA-WER 与能效口径)· https://www.siliconreport.com/nvidia-releases-nemotron-3-5-transcribe-for-speech-in-40-languages · 2026-10-28
5. 瑞士 Giotto 发布 Alto / Solo:单卡到八卡 B300 的「主权推理模型」,但许可证禁止独立基准测试(厂商自测)
瑞士洛桑的 Giotto.ai(2017 年由 EPFL 数学系校友创立,2024 年 ARC-AGI 竞赛第 11 名、2025 年第 2 名,约 1,500 支队伍中)10-27 发布 Giotto Alto 与 Giotto Solo,主打「欧洲主权 AI」:Solo 设计为单张 GPU 运行,Alto 为旗舰、跑在八张 B300 上;三种部署形态(欧洲共享云、瑞士或欧洲其他地区的专用云、通过集成商本地部署),官方强调不依赖美国云基础设施。共享云免费,API 为固定费用不限量(限 1 并发),多并发走 token 包。
厂商自测成绩:AIME 2026 100.0%(与 GPT-5.5 xhigh、Claude Opus 4.8 max 并列)、GPQA-Diamond 91.9%、HLE 52.0%、Math-500 99.80%。
为什么值得关注:这是「主权 AI」叙事第一次给出双尺寸产品形态(单卡 / 八卡),把「效率即主权」作为可操作的采购论据——对数据合规敏感的政府与金融、医疗机构确实需要「模型在自己手里」这个选项。但必须指出三个问题:一是未发现开放权重,自托管与设备形态的定价也未公布;二是所有基准分数均为公司自测,未找到第三方复现;三是有报道称其许可证禁止独立性能基准测试——如果属实,那么「性能可验证性」这个前提本身就不成立。这条应作为「主权 AI 供给侧的样本」记录,而不是作为能力结论引用。
来源:Giotto.ai SA 官方公告(Ad Hoc News 转发)· https://www.ad-hoc-news.de/boerse/news/corporate-news/giotto-launches-sovereign-ai-family-to-make-ai-public-infrastructure/70419755 · 2026-10-27 来源:ExplainX(基准表与「claimed vs verified」逐项核对)· https://explainx.ai/blog/giotto-alto-solo-swiss-sovereign-ai-models-benchmarks-claimed-vs-verified-2026 · 2026-10-28
二、工程与架构
1. GitHub Agentic Workflows(gh-aw)转 GA:Markdown 写 agent,编译成受约束的 Actions job
GitHub 10-28 宣布开源项目 GitHub Agentic Workflows(gh-aw) 正式可用。维护者用 Markdown + YAML frontmatter 描述任务(issue 分类、CI 失败分析、文档维护、写测试、代码审查),gh aw 把它编译成标准 GitHub Actions YAML——因此复用既有的 runner group、权限模型与审计面。支持的编码引擎包括 GitHub Copilot CLI、Claude Code、OpenAI Codex、Google Gemini、Pi,各自使用自己的认证与计费。
安全设计是这条的核心,共五层:agent 访问 GitHub 内容受 integrity filter 约束、默认只读权限、在 Agent Workflow Firewall 后的沙箱容器内执行、变更经 safe outputs 校验后才落地、落地前由独立的威胁检测 job 扫描。GA 新增:Actions Runner Controller(ARC)与 Docker-in-Docker 自托管 runner、gh aw forecast 转正(含威胁检测额度与月度区间)、按任务类型与难度路由模型、Cloud Hypervisor / NVX micro-VM 隔离与跨仓 enclave。可用范围为 GitHub Free / Team / Enterprise;默认 Copilot CLI 引擎需 Copilot 许可。仓库已有 v1.0.1 release(10-27)。
为什么值得关注:它把「agent 自动化」从自定义 runner 拉回了 Actions 的既有治理体系——这是一次工程上的收敛而非扩张。文档明确警告不要随意使用 pull_request_target(它在基仓库的提权上下文执行),也要求把生成的 .lock.yml 与 Markdown 源一并提交审查。GitHub 引用的 Accenture 数据(每周省 29 小时、velocity 翻倍、AI 撰写 91% 提交、日生产错误 11,000 → 1,000)为厂商口径转述的客户自报,不是独立基准。
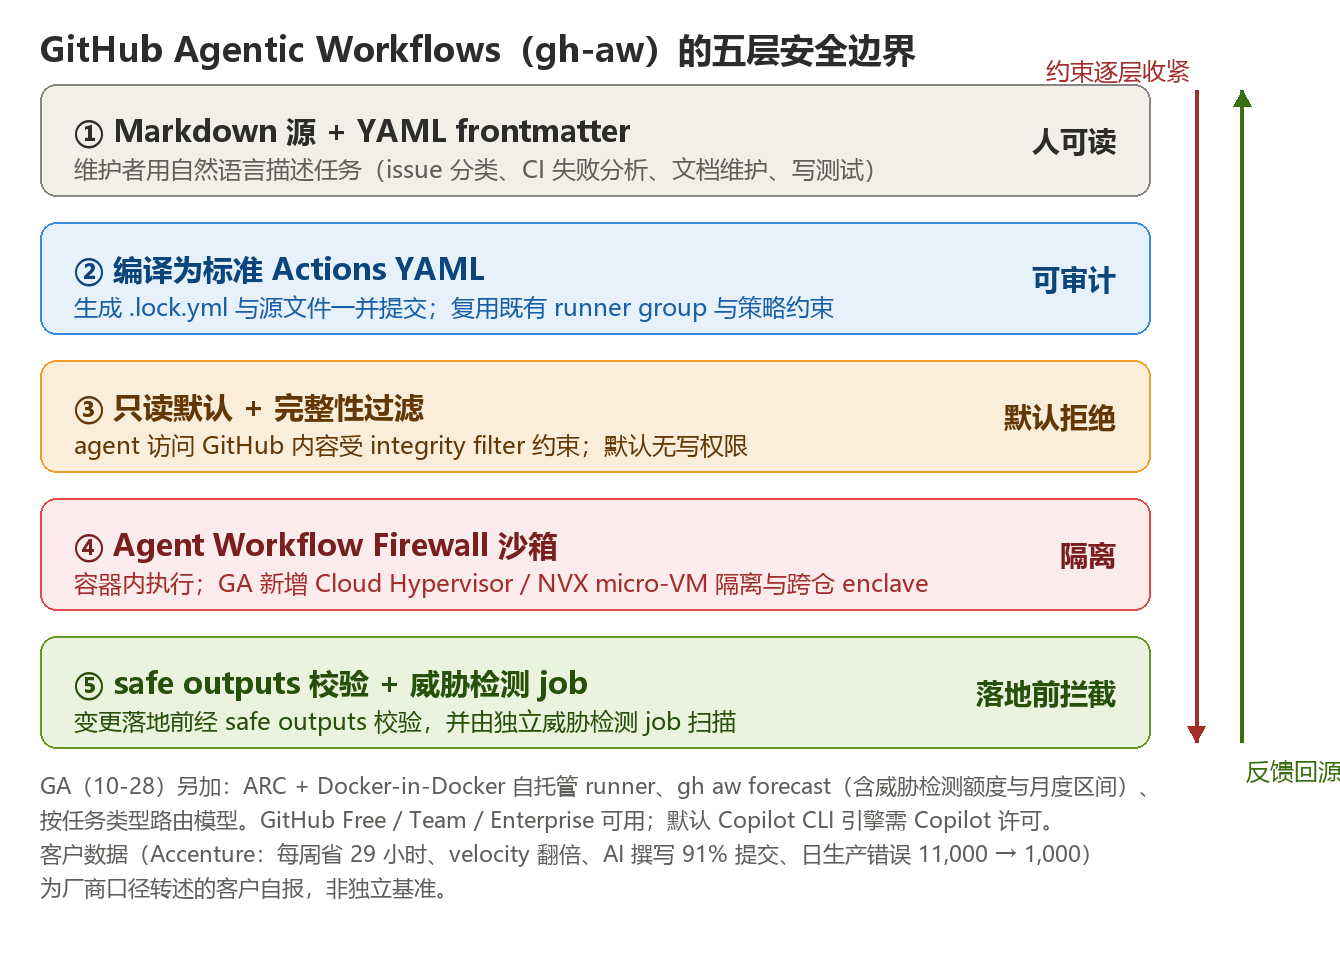
来源:GitHub Blog(经 worldprogramming / CloudScoop / vibehacker 转述,github.blog 本环境不可直接访问)· https://www.worldprogramming.org/posts/github-agentic-workflows-generally-available-zpv2ja · 2026-10-28 来源:Beyond the News(GA 增量与安全层逐项核对)· https://beyondthe.news/dossiers/github-agentic-workflows-ga-markdown-actions-safe-outputs-october-2026 · 2026-10-29
2. llama.cpp 发布 v0.8.0 与 b11972:LFM3 家族 + 实时音频端点,两条根因级越界写修复(更新,首报 10-04)
llama.cpp 10-28 发布 v0.8.0(12:47 UTC),同日 b11972(22:50 UTC)。v0.8.0 是一次大版本:
- 模型:LFM3 家族(LFM3-1.7B 文本、LFM3-VL-2B 视觉、LFM3-Audio-2B、LFM3-Omni-2B,含流式音频输入输出);新架构落地 DeepSeek V4.1 Flash、SenseNova U1、Beam、Kolibri-1、Flint、Muse Spark、Granite Switch Decision,以及 LiquidAI / 百度 / NVIDIA 的决策与嵌入模型。
- 服务端:新增
/v1/realtime(实现 OpenAI realtime 协议的对话与转写)与/tts;router 内存管理与工具调用改进;UI 可直接从 HF Hub 浏览下载模型、搜索与压缩会话。 - 内核:稀疏注意力(QSA/DSA)重构到融合 masking op;面向 host-resident MoE 专家的 50/50 SLRU 缓存;
no_alloc内存处理清理;ggml升至 v0.28.0(新增GGML_OP_TOP_K_MASK、-1专家索引语义,以及 CUDA chunked graph launch、SYCL graph replay、OpenCL Q2_K/Q3_K、Hexagon HTP 重做、KleidiAI SVE kernel)。
b11972 是根因级正确性/安全修复,两条都属越界写:一是 control vector 的层索引从张量名解析时无上界检查,缓冲区大小与写偏移用 int 计算,大索引使两者同时溢出,累积写入落到缓冲区起始之前——修复方式是把模型层数传给 loader、像既有零索引检查一样拒绝越界索引,并用 size_t 计算尺寸;二是 mtmd 中 Qwen-VL、GLM、PaddleOCR、Qwen2.5-VL 编码器的 M-RoPE 位置循环把 2×2 merge 硬编码在 n_merge 步长内,patch grid 不是 merge 倍数时会写出位置缓冲区——修复为按整 merge tile 迭代,并对 PaddleOCR 要求在构图时使用 merge 对齐的图像。
为什么值得关注:v0.8.0 说明本地推理栈正在把「实时语音」当作一等能力(/v1/realtime + /tts + LFM3-Audio/Omni),而不只是文本补全;b11972 则是典型的「静默越界」——两条都不会报错,只会产出错误结果或破坏内存,属于最难排查的一类缺陷。
来源:llama.cpp GitHub Release · https://github.com/ggml-org/llama.cpp/releases/tag/v0.8.0 · 2026-10-28 来源:llama.cpp GitHub Release · https://github.com/ggml-org/llama.cpp/releases/tag/b11972 · 2026-10-28
3. Ollama v0.40.13-rc1:修 LFM3 GGUF 并接入 llama-server 语音(更新,首报 10-07)
Ollama 10-28 19:55 UTC 发布 v0.40.13-rc1,两项改动:修复 LFM3 的 GGUF 处理,以及接入 llama-server 的语音能力;内置 llama.cpp 升至 b11963。上一正式版 v0.40.12(10-27)已把 LFM3 全家族(lfm3 / lfm3-vl / lfm3-audio / lfm3-omni)与 d1 决策模型 2B 档上架,并注明该版本仅 Apple 硬件支持 lfm3 与 d1 2B,Linux/Windows 支持「即将到来」。
为什么值得关注:LFM3 上架后立刻出现 GGUF 修复,说明端侧多模态模型的量化路径仍在磨合;把 llama-server 的语音能力接进 Ollama 则是把「本地语音」补齐到与本地文本同一入口。
来源:Ollama GitHub Release · https://github.com/ollama/ollama/releases/tag/v0.40.13-rc1 · 2026-10-28
4. NVIDIA CUDA 13.4:在 Kubernetes 里强制 GPU 显存边界,把「共享」从约定变成硬约束
NVIDIA 10-27 发布技术博客,介绍 CUDA 13.4 的显存强制 GPU 共享:通过 GPU Fractioning Operator 与 KAI Scheduler v0.18.0 的 NvFractions 组合,在 Kubernetes 上把单张 GPU 切成多个带显存边界强制的份额。此前的 GPU 共享方案多依赖 MPS / MIG 或调度器层的软约定,显存超用只能靠事后观测;CUDA 13.4 把边界下沉到驱动层,使超用被直接拒绝。
为什么值得关注:多租户推理集群里最常见的事故不是算力争抢,而是显存超用拖垮同卡邻居。把边界做成硬约束,是让「按份额卖 GPU」在 SLA 层面站得住的前提;对自建推理平台而言,这条比任何模型发布都更直接影响可用性。
来源:NVIDIA Developer Blog · https://developer.nvidia.com/blog/memory-enforced-gpu-sharing-in-kubernetes-with-nvidia-cuda-13-4/ · 2026-10-27
5. Check Point 披露「Yoba」活动:用 OpenAI / Anthropic 的签名二进制给恶意 DLL 做掩护
Check Point Research 10-27 发布报告,披露其跟踪约两个月的恶意软件活动 Yoba(更早变体 6 月初伪装成 Cursor 编码 agent)。攻击链:在 GitHub 建仓库 + GitHub Pages 落地页,伪装成 GPT-5.6 Sol、GPT-6 Astra、Claude Opus 等 AI 桌面应用,部分仓库出现在 Google 搜索结果前列(报告判断为 SEO 投毒);安装包内是真实的 OpenAI / Anthropic 签名 Setup.exe 搭配恶意 winmm.dll,靠 DLL 旁加载把恶意组件载入可信进程。恶意 DLL(YobaDropper)会检查宿主进程名、管理员权限、键盘布局(避开除乌克兰外的独联体地区),并用约 12 天的延迟规避自动化分析;随后在 ProgramData 下建目录、复制合法 Windows 可执行文件、以伪装成 Microsoft 任务、以 Local System 身份在开机后 3 分钟运行的计划任务实现持久化。二阶段 YobaLoader 不使用专用 C2:从 Telegram 频道取图生成域名(DGA),再向 Google 的 DoH 服务查询 DNS TXT 记录中的加密指令,最后从 Catbox 取载荷。观测到的最终载荷是 XMRig 挖矿程序,但报告强调 YobaLoader 是通用加载器,后续可投递其他可执行文件或 PowerShell 脚本。恶意 release 的上传时间为 8-30、8-31、9-4;报告称有俄罗斯来源迹象但未点名组织。
为什么值得关注:它把「签名即可信」这个普遍假设直接打掉——有效数字签名只证明某个可执行文件本身完整,不证明它加载的东西或它所在的安装包可信。对工程团队的直接影响是两条:DLL 旁加载行为与 ProgramData 下以 Local System 运行的计划任务应作为检测项;以及「禁止安装外部 AI 客户端」这类禁令会把员工推向非官方渠道,反而放大风险——更有效的做法是把批准的 AI 工具做成容易获取的。
来源:Check Point Research(经 Security Intel Hub / OSINT Sights / AI Sec Watch 转述)· https://securityintelhub.com/article/fake-chatgpt-claude-apps-spread-malware-via-signed-ai-binaries · 2026-10-28
三、行业与发展
1. 微软向约 6 万名员工开出自愿离职方案,同期 2026 年资本开支指引 1750 亿美元
微软 10-26 宣布推出自愿离职方案(Voluntary Exit Offer,VEO),约 6 万名员工符合申请资格,约占其全球 22.3 万名全职员工的 27%。范围覆盖美国、加拿大、英国、印度指定参与团队中职级 70 级及以下的员工,含部分副总裁级管理者,不含企业副总裁;不设年龄与工龄门槛,绩效也不作为申请条件。在列团队包括 AI 体验、Copilot、财务、人力资源、Xbox、Windows 与设备;不在列的是销售、网络安全、量子计算、营销与部分数据中心岗位。补偿对标公司标准裁员方案(现金按职级与工龄、已授予股票继续归属、医保、职业转型服务),未额外加码;符合条件的员工需在 12 月初前决定,接受者 12-31 离职。
为什么值得关注:关键不是「裁员 6 万」,而是6 万是合资格人数,不是实际离职人数——微软未公布预计离职数,按其他大厂同类项目 3%–5% 的接受率推算,实际规模约在 1,800–3,000 人之间,与「27%」差一个数量级。真正的信号是两条账单被放在同一窗口:2026 年资本开支指引 1750 亿美元(2026 财年 Q4 单季 410 亿、同比增七成,下季预计升至 500 亿),以及年内第三轮人员调整(4 月自愿退休 8,750 人、超 30% 接受;7 月裁 4,800 人;9 月数百人)。微软否认自愿离职直接源于 AI 替代员工,称是为适应业务需求变化——但把「人力成本」换成「算力成本」的方向是清楚的。
来源:路透社 / 环球时报(经环球网转述)· https://3w.huanqiu.com/a/c36dc8/4TnKB2C2ox4 · 2026-10-28 来源:中国经济网(补偿细则与年内三轮调整)· http://intl.ce.cn/sjjj/qy/202610/t20261029_3275145.shtml · 2026-10-29
2. 荷兰拟用 AI 裁撤 2.5 万公务员岗位,十年目标约 20%
荷兰公共广播 NOS 10-26 首报、路透社同日、彭博社 10-27 跟进:荷兰内阁计划在未来十年逐步裁撤约 2.5 万个中央政府公务员岗位(约占中央政府员工总数 15%–16%),目标自 2035 年起每年节省 35 亿欧元;配套手段包括借助 AI 把政府生产力提高 20%、每年废除或简化 500 项规章制度、推动 IT 系统标准化、出售闲置办公楼,甚至要求两名员工共用一张办公桌。警察与国防系统不在裁减范围;各部委、监察机构与执行机构可能面临更大幅度缩减,有报道称部分部门裁减比例或高达 60%。截至 2025 年底荷兰中央政府工作人员 16 万人,比 2018 年增长 41%。彭博社按比例换算:该规模相当于美国的 15 万人、英国的 7.5 万人、法国的 5 万余人。
为什么值得关注:这是迄今把「AI 提效」直接写进政府编制与预算科目的最激进计划——过去「AI 替代岗位」多停留在企业 HR 措辞里,荷兰是第一个把它换算成国家预算的西方国家。三个现实约束必须同时读:政务流程的第一特征是「不能错」(福利发放、许可审批的容错率远低于企业场景),AI 大规模上岗的前提是流程重构与问责体系重建而非模型替换;警察与国防被排除在外,说明政府自己清楚哪些环节 AI 还碰不得;计划需经议会博弈,十年周期内政府可能更迭,岗位削减与 AI 部署的因果关系在实际预算中未必一一对应。莱顿大学教授梅尔批评以预设人数与金额为起点裁员是「一刀切」,指出许多公共部门基层岗位仍严重缺人。
来源:彭博社(经 IT之家 / 腾讯新闻转述)· https://news.qq.com/rain/a/20261027A0C9U000 · 2026-10-27 来源:环球时报(学界质疑与彭博社换算)· https://www.163.com/dy/article/LACV6IT50514R9OJ.html · 2026-10-29
3. 国家数据集团完成工商登记:注册资本 300 亿元,六家央企 + 雄安集团出资
天眼查显示 国家数据集团有限公司已完成工商登记,成立于 2026 年 9 月,法定代表人简勤(原中国联通党组副书记、总经理),注册资本 300 亿元人民币,注册地河北雄安新区。股东结构:国务院国资委持股 20%(认缴 60 亿元)、中国联通 / 中国移动 / 中国电信各 15%(各 45 亿元)、国家电网 / 南方电网各 12.5%(各 37.5 亿元)、中国雄安集团 10%(30 亿元)。10-20 国务院国资委公告经国务院批准组建,同日成立大会在雄安举行(国务院副总理丁薛祥揭牌),10-21 官网上线。经营范围含大数据服务、数据处理与存储支持、人工智能应用软件开发、人工智能公共数据平台、人工智能基础资源与技术平台等。总经理陈荣辉原为国家数据局党组成员、副局长。
为什么值得关注:定位上,国家数据局负责数据基础制度与政策设计,国家数据集团负责数据资源的市场化开发运营——这是把「数据要素」从制度层落到运营主体的动作。对 AI 产业的直接含义是数据基础设施将走向互联互通,更多市场主体能以更低门槛接入高价值数据资源;同时也意味着数据授权、定价与合规的规则将由一个央企主体来承接,这会影响所有依赖公共数据训练或做行业模型的公司。
来源:天眼查工商信息(经每日经济新闻 / 大河财立方转述)· https://www.nbd.com.cn/articles/2026-10-27/4620418.html · 2026-10-27 来源:大河财立方(股东结构与人事)· https://www.toutiao.com/article/7701177805563888182/ · 2026-10-27
4. 惠普、华硕、宏碁把部分 PC 产能迁回中国:AI 推高存储成本,「中国 +1」出现逆转
《日经亚洲》10-28 援引消息人士:包括惠普、华硕、宏碁在内的 PC 厂商正把部分生产线从泰国、越南迁回中国,并转向立讯精密、华勤技术、龙旗科技等新一代中国代工厂;戴尔(全球第三大 PC 厂商)也在评估类似调整。动因是 AI 需求导致内存与存储芯片严重短缺、整机物料成本上涨。规模更大的老牌代工厂(广达、仁宝、英业达、富士康)正把产能转向利润率更高的 AI 数据中心服务器——广达 2026 年 Q2 服务器业务占其营收超 80%,有报道称其 9 月因零部件成本争议暂停 HP 笔记本生产约一周。TrendForce 数据:CPU + DRAM + SSD 占主流笔记本 BOM 的比重从 2025 年 Q1 的 45% 升至 2026 年 Q3 的约 68%;中国以外的全球笔记本产能占比预计从 2025 年约 24% 降至 2026 年 21%,2027 年可能低于 20%。Tom's Hardware 转述内存价格 12 个月内上涨约 500%。中国代工厂的卖点之一是更稳妥地获取国产存储芯片(如长鑫)。
为什么值得关注:这是「中国 +1」战略的一次实质性逆转,而驱动力不是政策而是成本——AI 基建对内存的挤占,正在反向重塑消费电子的供应链地理。需要注意证据强度:报道基于日经的消息人士,惠普、戴尔、华硕均未置评,宏碁仅表示「动态调整供应链运营」;「内存涨 500%」为转述口径。另一个被忽视的代价是东南亚新建产能:有零部件供应商称「为 PC 客户在泰国建了两条新产线,现在订单大量回流中国,这两条线还没盈利」。
来源:日经亚洲(经 TrendForce 转述)· https://www.trendforce.com/news/2026/10/28/news-ai-driven-component-costs-reportedly-push-hp-asus-acer-to-shift-some-pc-production-back-to-china/ · 2026-10-28 来源:Tom's Hardware(BOM 占比与内存涨幅)· https://www.tomshardware.com/tech-industry/manufacturing/ai-component-hikes-force-the-worlds-largest-pc-makers-to-return-manufacturing-capacity-to-china-brands-to-seek-lower-production-costs-and-efficiency-in-established-supply-chain · 2026-10-28
5. 存算一体 AI 芯片公司微纳核芯完成超 10 亿元 C2 轮,三颗芯片已投片
杭州微纳核芯电子科技 10-28 宣布完成超 10 亿元 C2 轮融资,建投投资领投,杭州资本、凯泰资本、晓池资本、烟台财金、盛堃投资、国投泰康、领阳基金等跟投,多名老股东加码。叠加 9 月 C1 轮,两个月内完成超 20 亿元,半年累计 30 亿元。公司 2021 年成立,孵化于浙江省北大信息技术高等研究院,创始人兼董事长叶乐为北京大学博士、北大集成电路学院副教授。技术路线为三维存算一体 3D-CIM(3D 近存计算 + SRAM 存算一体 + RISC-V 异构存算),声称依托国产成熟工艺达成先进制程等效算力,面向云、边、端大模型推理。第一代 LP-CIM 与 PCIe-CIM 系列共三颗芯片已于近期全部投片,预计 2027 年初客户送测并启动批量供货;端侧已与多家手机平台、ODM 厂商、具身智能公司做算法适配与方案开发,部分项目进入深度联合调试。
为什么值得关注:这条的价值不在融资金额,而在「三颗芯片已投片 + 2027 初送测」这个可验证的里程碑,以及「用国产成熟工艺做等效算力」这个绕开先进制程限制的具体路径。保留意见:全部为厂商口径,无第三方能效或带宽实测数据;「先进制程等效算力」的对照基准未公布。
来源:科创板日报(经腾讯新闻 / 网易转述)· https://news.qq.com/rain/a/20261028A0CFRK00 · 2026-10-28 来源:投资界(三颗芯片投片与客户进展)· https://app.myzaker.com/news/article.php?pk=6ae1a6828e9f093f4b3e82ed · 2026-10-28
四、论文与开源
1. Memory Tax(arXiv 2610.34073):11 个 agent 记忆系统里 90/99 个结果不如朴素 RAG,代价却高三个数量级
UIUC 主导(合作方含清华、人大、滑铁卢大学、Verdent.ai;作者含 Jiawei Han、ChengXiang Zhai)的论文 《Memory Tax: Dissecting the Net Value of Agent Memory》 把 11 个开源 agent 记忆系统与最朴素的 RAG 基线(对原始历史做分块检索,不做任何记忆处理,含一轮与两轮变体)放在同一舞台上比较。三基准:LongMemEval-s(500 题)、PersonaMem-v2(20% 子集,934 题)、MINT-Eval(10% 子集,1,557 题);三骨干:Qwen3.5-4B、Qwen3.6-27B、GPT-5.6 Luna;统一嵌入模型 Qwen3-Embedding-0.6B,评测由 Qwen3.6-27B 做 LLM judge;并用「检索范围」对齐各系统实际读取量,避免「记忆系统输在上下文给少了」这个反驳。
结果:在 LongMemEval-s 上,11 个系统在三个骨干上全部低于两轮 RAG——27B 骨干上两轮 RAG 得 81.4,最接近的 A-Mem 79.4、MemOS 76.6;4B 骨干上 LightMem 落后 14.6 分,OpenViking 落后整整 40.4 分。并非全面溃败:Memory-R2 在 PersonaMem-v2 上超 RAG 2.0 分,PlugMem 在 MINT-Eval 上超 3.3 分——这正是论文要解剖的部分。成本侧更刺眼:A-Mem 在 LongMemEval-s 上的离线构建耗时 117 小时,而 RAG 是 0.11 小时(三个数量级),LLM 调用 98.4K 次对 RAG 两轮变体的 200 次。论文把净价值拆成「记忆收益」与「记忆税」,并把税源归为三类:忠实性(原子事实从原始语料进入记忆单元时丢失——OpenViking 有 38% 的事实根本没有对应记忆单元,另有 13% 重大损失;对照 MAGMA 保留 93.6% 无损,说明损失是设计选择而非宿命)、可访问性(证据存活但不可达——被碎片化、稀释或改写,首轮检索召回低于 RAG)、鲁棒性(记忆固定、只换 QA 骨干时,许多记忆系统的波动大于原始 RAG)。论文也把部分账算到评测集头上:在一批长期记忆基准上,连无向量的 IDF 关键词匹配都能超过 50%,混合检索约 70%——任务本身偏检索友好,天花板低,税就显形了。作者提出的低成本修法是 src-aug:在检索记忆库的同时也检索原始历史并联合重排。代码与完整结果开源(MIT)。
为什么值得关注:这篇的真正贡献不是「记忆没用」,而是给了一套记账框架:看到任何记忆系统的成绩单,先问「朴素 RAG 得多少分、构建要多少小时」。对工程实践的直接结论是——如果负载主要是事实召回,先用两轮 RAG 就够了;记忆系统留给真正需要抽象与偏好蒸馏的任务。它同时提醒:把「记忆」当作默认动作是有成本的,而这个成本此前很少被计入对比。
来源:arXiv 原始页面 · https://arxiv.org/abs/2610.34073 · 2026-10-25 提交 来源:ExplainX(实验设置与成本表逐项核对)· https://explainx.ai/blog/memory-tax-agent-memory-systems-underperform-naive-rag-uiuc-paper-2026 · 2026-10-28
2. InfraDev(arXiv 2610.36589):六个前沿模型在真实 AI 基础设施 PR 上最高只解出 38.9%
爱丁堡大学与腾讯混元合作的 InfraDev 是一个面向 AI 基础设施开发的 agent 基准:从 Megatron-LM、vLLM、verl 在 2025 年 1 月至 2026 年 9 月间合并的 21,389 个 PR 中选出 36 个任务,每个都要求 agent 重实现一个跨多文件、且必须在多 GPU 上正确运行的改动。评分方式是该论文的重点:作者联合合成隐藏探针(强制原测试未覆盖的需求)与一份只声明探针所调用的全部接口、但不泄露解法的 prompt。结果:六个前沿模型中最好的只解出 38.9%;隐藏探针拒掉了 32% 通过全部官方测试的提交;用原始 PR 描述作 prompt 时,没有一个模型解出任何一个任务。失败分析显示结构性错误与状态错误占主导,且 agent 自己写的测试很少检查内存、时间或流量。作者另设计共享执行环境,在 Megatron-LM 与 vLLM 上省下 52%–57% 存储与 13%–14% 构建时间;把失败分析转成 agent skill 后,某前沿模型在 Megatron-LM 任务上的解决率提升 10.5%。
为什么值得关注:它同时给出两个结论——现有 agent 编码基准高估了能力(因为官方测试本身不充分),以及评测本身可以成为改进手段(把失败模式转成 skill 就涨 10.5%)。「32% 通过官方测试却被拒」这个数字,比任何模型排名都更能说明当前 agent 评测的失真程度。
来源:arXiv 原始页面 · https://arxiv.org/abs/2610.36589 · 2026-10-27 提交 来源:The AI Edge Briefing(摘要与口径核对)· http://aiedgebriefing.com/2026-10-28 · 2026-10-28
3. EAT: Evolving Agent Teams(arXiv 2610.36848):让 supervisor 诊断「局部最优」并重组 agent 团队,写出比生产 FlashInfer 更快的 CUDA kernel
论文发现现有编码 agent 在真实专家编写的 kernel(如 FlashInfer)上会收敛到局部最优,于是提出 Evolving Agent Teams:一个中央 supervisor 诊断每个局部最优并重组 agent 团队,配合一个持久文件系统(学习文档、演化历史、每团队工件)把累积经验作为重组的依据。结果:匹配 token 预算下持续优于强编码 agent 基线;扩展 token 预算下,从零写出一个 CUDA kernel,达到生产 FlashInfer MLA paged decode kernel 的 1.2× 平均加速,在 FlashInfer-Bench 的 47 个生产负载中赢下 36 个(其余 11 个为 0.86–0.99×)。其他任务:KDA prefill 在 AMD MI350X 上 3.01× vLLM、在 NVIDIA B200 上 3.44× FlashKDA;Apple silicon 上的 MoE 专家 offload 服务达 30.3 tokens/s decode(Qwen3.8-Flash-Next,MLX 4-bit,48 GB M4 Pro);RoboDojo 机器人操作 62.1(留出种子)对最佳榜 55.3。代码开源(Apache-2.0)。
为什么值得关注:这是「多 agent 编排」第一次在可硬核验证的指标(生产 kernel 加速比)上给出超过人类产物的结果,而不是在自建基准上刷分。方法上的关键点是 supervisor 的职责不是「分工」而是「诊断停滞并重组」——这比静态角色分工更接近真实团队的行为。
来源:arXiv 原始页面 · https://arxiv.org/abs/2610.36848 · 2026-10-27 提交 来源:GitHub 仓库 · https://github.com/caoshiyi/EAT · 2026-10-28 推送
4. God Does Not Play Dice(arXiv 2610.36623):83 个发布工件里 19 个批次不变性违规,加一道门禁把通过率从 67.6% 提到 91.9%
LLM 服务系统会动态批处理请求,同一个请求在不同运行中可能与不同请求同批。如果 GPU kernel 缺少批次不变性(Batch Invariance, BI),变化的批次上下文会改变同一输入的数值输出,破坏可复现性。论文发现83 个可批处理的已发布工件中有 19 个确认存在 BI 违规。作者提出一个工具,把契约引导的静态依赖分析与跨批次上下文的位级一致性动态验证结合,作为通用 kernel agent 的插件,在优化循环中充当连续的验收门禁——在性能基准测试之前就拒掉结构上有风险或动态上非不变的候选,并把反馈回传给 agent。三个 agent 框架、真实 LLM 服务任务上的实验显示,BI 通过率从 67.6% 提升到 91.9%,同时保留基线几何平均加速的 91.8%。
为什么值得关注:这是「agent 自动优化 kernel」这条线上被长期忽略的可靠性维度。正确性和速度之外,可复现性必须成为第三个优化目标——否则同一个 prompt 在不同负载下给出不同答案,任何依赖确定性的下游(评测、审计、缓存)都会失效。
来源:arXiv 原始页面 · https://arxiv.org/abs/2610.36623 · 2026-10-27 提交
5. RynnWorld-Latent(arXiv 2610.36791):用 3D 接地潜在动作做跨具身世界模型的共享条件接口
港大与阿里达摩院等合作的 RynnWorld-Latent 是一个跨具身视频世界模型,用 RynnLAM 提出的 3D 接地潜在动作作为共享条件接口——这样人机交互视频、机器人演示与仿真 rollout 可以联合预训练,而不需要统一的原生动作空间。模型基于预训练视频 transformer,把全局动作 token 与一条恒等初始化的局部通路(把动作与未来视频潜变量对齐)结合;预训练语料为 23 个数据集、约 5.535 亿帧,之后通过后训练适配到目标机器人。框架支持两条数据生成路线:数字遥操作(用目标机器人指令生成动作-视频演示)与潜在动作合成(把源运动迁移到编辑过的初始帧,并配上重定向的伪机器人动作)。实验显示在公开基准与两个真实机器人平台上视频预测指标改善,不同动作序列共享同一初始观测时具备定性动作跟随能力;合成数据的中期训练提升 LIBERO 与 LIBERO-Plus 上的策略成功率,两条生成路线在评估的真实场景中均优于仅用真实演示训练。
为什么值得关注:它把「寻找通用动作空间」的方向从底层机器人指令转向空间与视觉转移表示,这意味着世界模型可以先吸收大量异构视频再适配到具体机器人,降低平台专属标注成本。保留意见:潜在动作不等于可执行指令,伪动作与编辑环境可能与真实物理交互有偏差;论文材料未给出精确成功率数值,增益幅度需从全文与基线判断。
来源:arXiv 原始页面 · https://arxiv.org/abs/2610.36791 · 2026-10-27 提交
五、值得关注的趋势
1. 评测方法学集体转向私有测试集,但「不可复现的权威」成为新的信任风险
同一窗口内四个独立事件指向同一件事:Artificial Analysis 把 v5 的 60% 权重建立在私有测试集或隐藏答案上;Cognition 的 FrontierCode 2.0 用 132 个私有任务、按「维护者是否愿合并」评分;InfraDev 用隐藏探针拒掉 32% 通过官方测试的提交;「God Does Not Play Dice」把位级一致性作为新的验收门禁。共同前提是公开题库已被训练数据污染,评测必须私有化。
判断:私有化是必然,但代价被低估了。AA v5 的开放权重集体下滑(差距 3 分 → 12 分)在 Hacker News 上被大量质疑「方法论没有清楚解释哪些权重变化、哪些模型移除导致了变动」,且私有集不可复现意味着外部无法验证排序。更值得警惕的是「用私有集得出的结论被当作公共事实引用」这一模式——它把评测机构的公信力变成了唯一的信任锚点。可操作的应对是:引用任何私有集结论时,同时引用该机构对自身方法学的限制声明(AA 自己就把 v5 定位为「修订后的测量系统」而非旧排名的延续)。
2. Agent 竞争点从「模型多强」转向「执行层多确定」
本期工程侧的四个事件可以拼成一张图:GitHub Agentic Workflows 转 GA 并给出只读默认 + 完整性过滤 + 沙箱防火墙 + safe outputs 校验 + 威胁检测 job 的五层边界;腾讯云 CubeSandbox 0.3.0 引入 CubeCoW 写时复制快照引擎,支持事件级快照、即时克隆与回滚到任意历史状态(且回滚后 sandbox_id 不变、无需重连重建);「God Does Not Play Dice」在 83 个发布工件里查出 19 个批次不变性违规;InfraDev 用隐藏探针拒掉 32% 通过官方测试的提交。
判断:这四个事件解决的是同一类问题——agent 的每一次动作必须可回滚、可复现、可审计。当 agent 从「输出文本」变成「操作系统里真实发生的动作」时,模型能力的边际收益在下降,而执行层的确定性成为瓶颈。CubeSandbox 把「快照/克隆/回滚」称为「存档、分身、读档」,这个类比很准确:agent 的试错可以发生,但失败不能无限扩大。可以预期 2026 年 Q4 到 2027 年,agent 基础设施的差异化会集中在状态治理与可复现性,而不是再刷一轮工具调用准确率。
3. 扩散语言模型首次进入 Agent 主场,但「快」的验证仍是厂商口径
DiffuSpace 的 Clover-35B-A3B-Preview 把参数扩到 5 倍(350 亿总 / 30 亿激活)而速度保持不变,SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、τ³ Overall 65.3,权重与代码开源且支持 SGLang 与 llama.cpp;同期公司披露连续两轮融资共数亿元人民币,华为哈勃跟投。
判断:dLLM 此前主要活在「生图生视频的底层技术」叙事里,这次是它第一次在 agent 编程与工具调用这类主场任务上给出可比数字,而且参数扩 5 倍而速度不掉才是「规模化潜力」的实际含义。但三点必须保留:「5–10 倍」明确限定为部分测试场景;680 tokens/s 为内部测试;WindTunnel 是开发者个人测评而非独立基准。真正的检验不在单任务延迟,而在长程多步任务的稳定性——扩散解码的全局一致性优势能否在 20 步以上的 agent 循环里保持,目前没有数据。
4. AI 基建的账单开始外溢到供应链与编制预算
三条不同层面的新闻指向同一件事:惠普、华硕、宏碁把部分 PC 产能从泰国、越南迁回中国,因为 AI 挤占内存导致 CPU + DRAM + SSD 占主流笔记本 BOM 从 2025 年 Q1 的 45% 升到 2026 年 Q3 的约 68%,「中国 +1」出现实质逆转;微软向约 6 万名员工开出自愿离职方案,同期 2026 年资本开支指引 1750 亿美元;荷兰拟用 AI 裁撤 2.5 万公务员岗位、十年目标约 20%,以换取 2035 年起每年 35 亿欧元的节省。
判断:过去一年 AI 的成本讨论集中在「算力预算」内部(GPU 采购、电费、单位 token 成本)。本期三条新闻说明账单正在外溢:一是挤占消费电子的关键零部件,反向重塑供应链地理;二是把人力成本当作可腾挪项来给算力让路;三是把「AI 提效」直接换算成政府编制与预算科目。这三条的共同风险是因果关系被简化——内存涨价确实由 AI 需求驱动,但「裁员 6 万」是合资格人数而非实际离职数(按同类项目 3%–5% 接受率推算约 1,800–3,000 人),荷兰的岗位削减与 AI 部署在预算中未必一一对应。引用这类数字时,区分「计划规模」「合资格规模」与「实际发生」是必要的。
六、有趣的 AI 开源项目
1. TencentCloud/CubeSandbox:把 agent 沙箱从「安全执行」推进到「状态治理」
腾讯云开源的 AI Agent 沙箱(Go / Apache-2.0,13,074★,2026-04-10 创建,10-28 推送)。基于 RustVMM + KVM 做硬件级隔离:冷启动 < 60 ms、单实例内存开销 < 5 MB、单台 96 vCPU 物理机可运行 2,000+ 沙箱实例,可从单节点扩到集群(含 Kubernetes),并兼容 E2B SDK(换一个 URL 环境变量即可接入)。0.3.0 引入 CubeCoW 写时复制快照引擎,支持事件级快照、即时克隆与回滚到任意历史状态——回滚后 sandbox_id 不变、沙箱对象不变,无需重连重建。Web 控制台默认端口 12088。
为什么值得关注:它把「快照 / 克隆 / 回滚」做成 SDK 三件套,意味着 agent 的试错可以发生而失败不会无限扩大——这是 agent 从 demo 走向生产的关键一步。E2B SDK 兼容则大幅降低了迁移成本。
来源:GitHub · https://github.com/TencentCloud/CubeSandbox · 2026-10-28 推送
2. NVIDIA/SkillSpector:在安装前扫描 agent skill 的提示注入与供应链风险
NVIDIA 开源的安全扫描器(Python / Apache-2.0,23,070★,2026-03-21 创建,10-28 推送),用于在安装前检测 Claude Code、Codex 与 MCP skill 中的漏洞、恶意模式、安全风险、提示注入、数据外泄与供应链风险。10-28 单日涨约 953★。
为什么值得关注:本期 Check Point 的「Yoba」报告说明 AI 客户端已成为投毒目标;当 skill 生态开始规模化分发,安装前扫描会像依赖漏洞扫描一样成为标准环节。这条与 Yoba 报告构成同一问题的攻防两面。
来源:GitHub · https://github.com/NVIDIA/SkillSpector · 2026-10-28 推送
3. Panniantong/Agent-Reach:一个 CLI 让 agent 读遍有围墙的互联网,零 API 费用
(Python / MIT,105,622★,2026-02-24 创建,10-25 推送)给 agent 提供对 Twitter/X、Reddit、YouTube、GitHub、Bilibili、小红书的认证读取与搜索能力,通过处理登录墙并返回干净结构化数据,做到零 API 费用。对同时横跨中英文平台的 agent 管线尤其有用。
为什么值得关注:agentic 管线里最贵的往往不是模型调用而是实时网络上下文——官方 API 要么收费高昂要么不存在。这类工具的价值在于把「有围墙的内容」变成可编程输入;风险同样明确:登录墙绕过涉及平台条款与账号安全,生产使用前需评估合规性。
来源:GitHub · https://github.com/Panniantong/Agent-Reach · 2026-10-25 推送
4. JetBrains/thinkrail:JetBrains 出的轻量 vibe coding IDE,按你的工作方式自我定制
(TypeScript / Apache-2.0,5,030★,2026-07-08 创建,10-28 推送)用 pi 驱动的轻量真实 IDE,卖点是「围绕你的工作方式自我定制」。10-28 单日涨约 1,204★。
为什么值得关注:这是老牌 IDE 厂商对 vibe coding 的一次正面回应——不是给现有 IDE 加 AI 面板,而是重做一个轻量编辑器。值得观察的是它能否把 JetBrains 在重构与静态分析上的积累带进 agent 工作流,而不是只做提示词包装。
来源:GitHub · https://github.com/JetBrains/thinkrail · 2026-10-28 推送
5. HKUDS/DeepTutor:把「终身个性化辅导」做成开源项目
港大数据智能实验室(Python / Apache-2.0,47,958★,2025-12-28 创建,10-28 推送)的 DeepTutor,定位为终身个性化辅导系统。
为什么值得关注:教育是 agent 落地最容易被忽视但需求最真实的方向之一——它要求长期记忆、学习者建模与自适应出题,正好是本期「记忆税」论文所讨论的问题域。把这类系统开源,也让「记忆系统到底有没有净价值」有了可复现的试验场。
来源:GitHub · https://github.com/HKUDS/DeepTutor · 2026-10-28 推送
6. 反 AI slop 设计 skill 三件套:hallmark 与 ai-design-skills 新入榜,impeccable 已报
10-28 GitHub Trending 出现「用 AI 工具修 AI 产物」的集中现象:Nutlope/hallmark(CSS / MIT,40,694★,2026-04-27 创建,10-28 推送,自述「Anti-AI-slop design skill for Claude Code, Cursor, and Codex」)单日涨约 2,830★;elayadesign/ai-design-skills(MIT,11,104★,2026-07-29 创建,10-27 推送)单日涨约 1,395★。同类的 pbakaus/impeccable(92,632★)已于 10-27 期报道,本期仅记录星数增长。
为什么值得关注:当日 GitHub Trending 前五中有三个是「阻止编码 agent 产出通用丑陋 UI」的设计 skill——这说明社区已经从「看,AI 做出了一个网站」转向「它做得好不好」。这类 skill 的技术含量不在提示词,而在不调 LLM 的确定性检测规则(impeccable 有 62 条),这是把设计品味工程化的实际路径。
来源:GitHub · https://github.com/Nutlope/hallmark · 2026-10-28 推送 来源:GitHub · https://github.com/elayadesign/ai-design-skills · 2026-10-27 推送
⚠️ 待核实
- vLLM v0.33.0rc1:
v0.33.0rc1tag 已推送(10-28),但 GitHub Releases API 对该 tag 返回 404,未生成对应 release 条目,变更内容无法逐条核实。本期未把 vLLM 列为正文条目。 - Gemini 4 Carbon 的上下文窗口:Google 官方博客未披露;1M 为 Artificial Analysis 口径,非厂商确认。
- Giotto Alto / Solo 的基准分数:全部为公司自测,未找到第三方复现;且据 HuggingNews 报道其许可证禁止独立性能基准测试,若属实则「性能可验证性」前提不成立。自托管与设备形态定价未公布,未发现开放权重。
- gh-aw 的 Accenture 客户数据(每周省 29 小时、velocity 翻倍、AI 撰写 91% 提交、日生产错误 11,000 → 1,000):为厂商口径转述的客户自报,非独立基准。
- 荷兰裁员计划:需经议会博弈,十年周期内政府可能更迭;岗位削减与 AI 部署的因果关系在实际预算中未必一一对应;「部分部门裁减比例或高达 60%」为媒体口径,未见政府文件确认。
- Clover 的「5–10 倍」与 680 tokens/s:前者明确限定为部分测试场景,后者为内部测试;WindTunnel 49 项任务数据来自开发者个人测评,非独立基准。
- HP / 华硕 / 宏碁产能迁回:基于日经消息人士,惠普、戴尔、华硕均未置评,宏碁仅称「动态调整供应链运营」;「内存价格 12 个月涨 500%」为 Tom's Hardware 转述口径。
- 微软 VEO 的实际离职人数:6 万为合资格人数而非实际离职人数;微软未公布预计离职数;「实际约 1,800–3,000 人」为媒体按其他大厂 3%–5% 接受率推算。
- Nemotron 3.5 Transcribe 的 AA-WER 2.8%:为 Artificial Analysis 口径;huggingface.co 本环境不可直接访问,模型卡数据经官方帖 + 二手交叉,可能有转述误差。
- Memory Tax 的「90/99 结果低于 RAG」:来自 aicrier 转述,论文正文表格未直接获取;「19 个 BI 违规 / 83 个工件」与「A-Mem 117 小时」等数字均以 arXiv 摘要与二手核对为准。
- 国家数据集团经营范围与股东出资:基于天眼查工商信息与媒体转述,未见官方公告逐条确认出资比例与认缴时间表。
本期淘汰记录
- 科大讯飞 SparkAudio 1.0 与星火 X2.6:原始发布于 10-22(2026 全球 1024 开发者节),人民日报 10-27 刊发、10-28 大量二手转载——原始发布日早于本期统计窗口,按纪律淘汰(仅作背景,不单列条目)。
- 10-29 规则引擎草稿中的 OpenAI 合作稿四条(ServiceNow 扩大合作、The future of the firm、Legora、Retell 支撑 1 亿月通话):厂商合作稿,无量化数据、无可验证的机制变化——按「写不出为什么值得关注就淘汰」处理。
- Genie 4(10-28 已报)、Oracle × OpenAI(10-28 已报)、Nanbeige4.3-33B(10-26 已报)、LFM3(10-28 已报):窗口内无新进展,草稿行不重复收录。
- Ollama v0.40.12(10-27 期已报):窗口内无新正式版;v0.40.13-rc1 已收。
- vLLM v0.32.0(10-19 已报):窗口内无新正式版;v0.33.0rc1 仅有 tag 无 release 条目——转待核实。
- llama.cpp b11936–b11971:同仓库只保留最新(已收 v0.8.0 与 b11972)。
- obra/superpowers(10-17 已报)、makecindy/cindy(10-26 已报)、nightly-labs/openbot(10-27 已报)、pbakaus/impeccable(10-27 已报):窗口内仅星数增长,无版本级变化——按规则不成条。
- stablyai/orca、KnockOutEZ/wigolo、FrigadeHQ/hob:10-28 期已完整报道。
- TradingAgents、VoiceStudio、morluto/rea、deepseek-harness、MoneyPrinterTurbo 等 GitHub Trending 常客:窗口内无新发布,或与已报条目同实体。
- 达卯科技约 2 亿元融资、上海卫星互联网产业基金、招商基金主动 ETF 募集达标:纯融资/募资稿,无技术信息、无可验证机制变化。
- Prospector(arXiv,10-28 报道)与 TrawMem:仅见二手转述(aimagick.cc),一手 arXiv 页面未定位——进待核实后仍不足,淘汰。
- EnvSched(2610.37609)、Metacognitive Decoding(2610.37642)、Experience Memory Graph(2607.13884)、LongChang(2610.37649)、PRESENT(2610.36435)等 arXiv 候选:未逐篇回验元数据,或与本期四条主线(评测私有化、执行层确定性、dLLM 进 agent、AI 成本外溢)关联不足——按「写不出为什么值得关注就淘汰」处理。
- SafeTulu / SimpleLoRIF(2610.37481):10-28 期已收录(附录第 45 行),本期不重复。
- Anthropic S-1 / IPO 相关讨论(10-27 已报):窗口内无新进展。
- Carbon-X(HuggingFaceBio,10-24 已报):与本期 Gemini 4 Carbon 同名不同实体,注意区分;窗口内无新进展。
- 微软 2026 DDR 报告相关安全数据:10-28 期已作为背景引用,本期不重复。
- 10-29 08:00 规则引擎自动草稿本身:其摘要为原文摘录(多为英文)、未做批判性判断,且把「厂商自述」当作结论;本期以人工复核版整体替代,草稿中的 16 条索引行按上述逐条重判。
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止日期 |
|---|---|---|---|---|---|---|
| 1 | 模型与产品 | Introducing Gemini 4 Carbon | Google DeepMind 官方博客 | https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/ | 2026-10-28 | 2026-10-28 |
| 2 | 模型与产品 | Gemini 4 Carbon is the new #1 on the Intelligence Index v5 | Artificial Analysis | https://artificialanalysis.ai/articles/gemini-4-carbon-new-number-1 | 2026-10-28 | 2026-10-28 |
| 3 | 模型与产品 | Announcing Artificial Analysis Intelligence Index v5 | Artificial Analysis | https://artificialanalysis.ai/articles/artificial-analysis-intelligence-index-v5 | 2026-10-27 | 2026-10-27 |
| 4 | 模型与产品 | Artificial Analysis shifts 60% of model index to private test sets | Silicon Report | https://www.siliconreport.com/artificial-analysis-shifts-60-of-model-index-to-private-test-sets | 2026-10-28 | 2026-10-28 |
| 5 | 模型与产品 | 扩散智能 DiffuSpace 开源 Clover-35B-A3B-Preview | 央广网 | https://www.cnr.cn/tech/techph/20261028/t20261028_527855192.shtml | 2026-10-28 | 2026-10-28 |
| 6 | 模型与产品 | 重构 GDN 架构:Clover 35B-A3B-Preview 开源 | 中新经纬 | https://www.jwview.com/jingwei/html/m/10-28/694594.shtml | 2026-10-28 | 2026-10-28 |
| 7 | 模型与产品 | DiffuSpace 开源 Clover-35B-A3B:MoE 扩散模型提速至 680 tokens/s | 钛媒体 | https://www.tmtpost.com/nictation/8184494.html | 2026-10-28 | 2026-10-28 |
| 8 | 模型与产品 | NVIDIA Nemotron 3.5 Transcribe and Granary v2 | NVIDIA / Hugging Face | https://huggingface.co/blog/nvidia/nemotron-transcribe-granary | 2026-10-28 | 2026-10-28 |
| 9 | 模型与产品 | Nvidia releases Nemotron 3.5 Transcribe for speech in 40 languages | Silicon Report | https://www.siliconreport.com/nvidia-releases-nemotron-3-5-transcribe-for-speech-in-40-languages | 2026-10-28 | 2026-10-28 |
| 10 | 模型与产品 | Giotto launches sovereign AI family(Alto / Solo) | Giotto.ai SA(Ad Hoc News 转发) | https://www.ad-hoc-news.de/boerse/news/corporate-news/giotto-launches-sovereign-ai-family-to-make-ai-public-infrastructure/70419755 | 2026-10-27 | 2026-10-27 |
| 11 | 模型与产品 | Giotto Alto and Solo: Claimed vs Verified | ExplainX | https://explainx.ai/blog/giotto-alto-solo-swiss-sovereign-ai-models-benchmarks-claimed-vs-verified-2026 | 2026-10-28 | 2026-10-28 |
| 12 | 工程与架构 | GitHub Agentic Workflows generally available | GitHub Blog(worldprogramming 转述) | https://www.worldprogramming.org/posts/github-agentic-workflows-generally-available-zpv2ja | 2026-10-28 | 2026-10-28 |
| 13 | 工程与架构 | gh-aw GA: Markdown agents compile into guarded Actions jobs | Beyond the News | https://beyondthe.news/dossiers/github-agentic-workflows-ga-markdown-actions-safe-outputs-october-2026 | 2026-10-29 | 2026-10-28 |
| 14 | 工程与架构 | llama.cpp release v0.8.0 | llama.cpp GitHub Release | https://github.com/ggml-org/llama.cpp/releases/tag/v0.8.0 | 2026-10-28 | 2026-10-28 |
| 15 | 工程与架构 | llama.cpp release b11972 | llama.cpp GitHub Release | https://github.com/ggml-org/llama.cpp/releases/tag/b11972 | 2026-10-28 | 2026-10-28 |
| 16 | 工程与架构 | Ollama release v0.40.13-rc1 | Ollama GitHub Release | https://github.com/ollama/ollama/releases/tag/v0.40.13-rc1 | 2026-10-28 | 2026-10-28 |
| 17 | 工程与架构 | Memory-Enforced GPU Sharing in Kubernetes with NVIDIA CUDA 13.4 | NVIDIA Developer Blog | https://developer.nvidia.com/blog/memory-enforced-gpu-sharing-in-kubernetes-with-nvidia-cuda-13-4/ | 2026-10-27 | 2026-10-27 |
| 18 | 工程与架构 | Fake ChatGPT, Claude apps spread malware via signed AI binaries(Yoba) | Check Point Research(Security Intel Hub 转述) | https://securityintelhub.com/article/fake-chatgpt-claude-apps-spread-malware-via-signed-ai-binaries | 2026-10-28 | 2026-10-27 |
| 19 | 行业与发展 | 微软推出新一轮自愿离职方案,覆盖约 6 万名员工 | 路透社 / 环球时报(环球网转述) | https://3w.huanqiu.com/a/c36dc8/4TnKB2C2ox4 | 2026-10-28 | 2026-10-26 |
| 20 | 行业与发展 | 6 万员工将离职,微软年内第三次「瘦身」 | 中国经济网 | http://intl.ce.cn/sjjj/qy/202610/t20261029_3275145.shtml | 2026-10-29 | 2026-10-28 |
| 21 | 行业与发展 | 荷兰计划用 AI 取代 2.5 万个政府工作岗位 | 彭博社(IT之家 / 腾讯新闻转述) | https://news.qq.com/rain/a/20261027A0C9U000 | 2026-10-27 | 2026-10-26 |
| 22 | 行业与发展 | 荷兰拟用 AI 替代 2.5 万公务员引发质疑 | 环球时报 | https://www.163.com/dy/article/LACV6IT50514R9OJ.html | 2026-10-29 | 2026-10-27 |
| 23 | 行业与发展 | 国家数据集团有限公司完成工商登记,注册资本 300 亿元 | 每日经济新闻(天眼查数据) | https://www.nbd.com.cn/articles/2026-10-27/4620418.html | 2026-10-27 | 2026-10-27 |
| 24 | 行业与发展 | 注册资本 300 亿元,国家数据集团完成工商登记 | 大河财立方 | https://www.toutiao.com/article/7701177805563888182/ | 2026-10-27 | 2026-10-27 |
| 25 | 行业与发展 | AI-Driven Component Costs Push HP, ASUS, Acer to Shift PC Production Back to China | 日经亚洲(TrendForce 转述) | https://www.trendforce.com/news/2026/10/28/news-ai-driven-component-costs-reportedly-push-hp-asus-acer-to-shift-some-pc-production-back-to-china/ | 2026-10-28 | 2026-10-28 |
| 26 | 行业与发展 | AI component hikes force PC makers to return manufacturing to China | Tom's Hardware | https://www.tomshardware.com/tech-industry/manufacturing/ai-component-hikes-force-the-worlds-largest-pc-makers-to-return-manufacturing-capacity-to-china-brands-to-seek-lower-production-costs-and-efficiency-in-established-supply-chain | 2026-10-28 | 2026-10-28 |
| 27 | 行业与发展 | 微纳核芯完成超 10 亿元 C2 轮融资 | 科创板日报 | https://news.qq.com/rain/a/20261028A0CFRK00 | 2026-10-28 | 2026-10-28 |
| 28 | 行业与发展 | 微纳核芯三颗芯片投片与客户进展 | 投资界 | https://app.myzaker.com/news/article.php?pk=6ae1a6828e9f093f4b3e82ed | 2026-10-28 | 2026-10-28 |
| 29 | 论文与开源 | Memory Tax: Dissecting the Net Value of Agent Memory(2610.34073) | arXiv | https://arxiv.org/abs/2610.34073 | 2026-10-25 提交 | 2026-10-25 |
| 30 | 论文与开源 | Memory Tax: Many Agent Memory Systems Lose to Plain RAG | ExplainX | https://explainx.ai/blog/memory-tax-agent-memory-systems-underperform-naive-rag-uiuc-paper-2026 | 2026-10-28 | 2026-10-28 |
| 31 | 论文与开源 | InfraDev: Can Coding Agents Develop AI Infrastructure?(2610.36589) | arXiv | https://arxiv.org/abs/2610.36589 | 2026-10-27 提交 | 2026-10-27 |
| 32 | 论文与开源 | Evolving Agent Teams(2610.36848) | arXiv | https://arxiv.org/abs/2610.36848 | 2026-10-27 提交 | 2026-10-27 |
| 33 | 论文与开源 | EAT 代码仓库 | GitHub | https://github.com/caoshiyi/EAT | 2026-10-28 推送 | 2026-10-28 |
| 34 | 论文与开源 | God Does Not Play Dice: Enforcing Batch Invariance(2610.36623) | arXiv | https://arxiv.org/abs/2610.36623 | 2026-10-27 提交 | 2026-10-27 |
| 35 | 论文与开源 | RynnWorld-Latent: A Cross-Embodiment World Model(2610.36791) | arXiv | https://arxiv.org/abs/2610.36791 | 2026-10-27 提交 | 2026-10-27 |
| 36 | 开源项目 | TencentCloud/CubeSandbox | GitHub | https://github.com/TencentCloud/CubeSandbox | 2026-10-28 推送(13,074★) | 2026-10-28 |
| 37 | 开源项目 | NVIDIA/SkillSpector | GitHub | https://github.com/NVIDIA/SkillSpector | 2026-10-28 推送(23,070★) | 2026-10-28 |
| 38 | 开源项目 | Panniantong/Agent-Reach | GitHub | https://github.com/Panniantong/Agent-Reach | 2026-10-25 推送(105,622★) | 2026-10-25 |
| 39 | 开源项目 | JetBrains/thinkrail | GitHub | https://github.com/JetBrains/thinkrail | 2026-10-28 推送(5,030★) | 2026-10-28 |
| 40 | 开源项目 | HKUDS/DeepTutor | GitHub | https://github.com/HKUDS/DeepTutor | 2026-10-28 推送(47,958★) | 2026-10-28 |
| 41 | 开源项目 | Nutlope/hallmark | GitHub | https://github.com/Nutlope/hallmark | 2026-10-28 推送(40,694★) | 2026-10-28 |
| 42 | 开源项目 | elayadesign/ai-design-skills | GitHub | https://github.com/elayadesign/ai-design-skills | 2026-10-27 推送(11,104★) | 2026-10-27 |
引用提醒:本文所有条目均来自上表所列公开来源;厂商自测数据(Gemini 4 Carbon 全部跑分与对齐指标、Clover-35B-A3B-Preview 全部评测与速度、Giotto Alto/Solo 全部基准、Nemotron 3.5 Transcribe 的模型卡 WER 与微调收益、gh-aw 的 Accenture 客户数据、微软 VEO 的接受率推算、微纳核芯的芯片进展)未经独立复现,引用时请保留「厂商自测」标注。Artificial Analysis Intelligence Index v5 的 60% 权重基于私有测试集,不可复现,其机构自身将 v5 定位为「修订后的测量系统」而非旧排名的延续,引用时请一并说明。arXiv 论文均为预印本,未经同行评审。待核实区条目不得作为事实引用。配图为依据上述来源自绘,非原文插图。