AI DAILY
AI日报 2026-10-13
一句话结论这一期最值钱的不是任何一个新模型,而是一组彼此拆台的证据:Meta 把智能指数最高的一档锁进每月 50/200 美元的订阅而不放 API,vLLM-SR 用 Apache-2.0 把决策模型的价格地板直接打掉,而同一批 arXiv 论文分别说明「更快的决策不会自动变成更好的 agent」「机器文本检测器测到的常常只是排版」「让评审更一致并不等于更接近人的判断」——前沿能力的可得性在收窄,而用来衡量前沿能力的那批指标在同时被证伪。
AI日报 2026-10-13
整理日期:2026-10-13 素材来源:厂商官方博客与 release(Meta / Z.ai / OpenAI / GitHub)、arXiv 原始页面、gov.uk、Reuters、Hugging Face 仓库本体,以及少量聚合站做线索发现后回溯一手源
可信度提示:统计窗口为 2026-10-11 09:00 → 2026-10-13 09:15(香港时间)。arXiv 论文按「2026-10-12 公告批次」计入,但每条显式标注 v1 提交日(多为 2026-10-09),公告与提交的区别已写在论文节节首。两条明确标为「补录」的条目首发日早于窗口起点(Decision 3.0 权重 10-10 上传、AesCode 10-07 静默上线),系往期漏报,已显式标注、不计入当日新增。Meta Muse Wonder 的逐项基准与参数规模官方博客未在正文给出(只放图),引用的数字均为二手转述并已标注。所有厂商自测分数已标「厂商自测、无独立复现」。
#AI日报 #模型发布 #开源 #论文 #AI治理
一句话结论
这一期最值钱的不是任何一个新模型,而是一组彼此拆台的证据:Meta 把智能指数最高的一档锁进每月 50/200 美元的订阅而不放 API,vLLM-SR 用 Apache-2.0 把决策模型的价格地板直接打掉,而同一批 arXiv 论文分别说明「更快的决策不会自动变成更好的 agent」「机器文本检测器测到的常常只是排版」「让评审更一致并不等于更接近人的判断」——前沿能力的可得性在收窄,而用来衡量前沿能力的那批指标在同时被证伪。
一、模型与产品
| # | 条目 | 关键数字与事实 | 判断 |
|---|---|---|---|
| 1 | Meta Muse Wonder / Muse Wonder Full(首发,2026-10-12) | 两个模型;卖点 Active Memory(跨会话记忆)与 Active Focus(长任务不掉线);评测集含 Harvey LAB、FocusBench、SWE-Marathon;官方只放图未给逐项数字 | Meta Superintelligence Labs 的第一个「前沿档」发布,但它没有开源——与 Meta 过去两年的开源叙事相反 |
| 2 | Z.ai GLM-Legal(首发,2026-10-12) | 基于轻量基座 GLM-5.3-Flash;Harvey LAB 全通过率 19.2%(比基座 +12.5pp);LegalBench / PLawBench 称与前沿闭源持平;未开源,Beta 申请制 | 打法是「用轻基座 + 域内中训/后训 + harness 协同演化去换专业域」,而不是堆参数 |
| 3 | GPT-6.1 Sol 默认上下文 272k → 500k(2026-10-11) | Codex 与 ChatGPT Work 默认上下文提至 500k(约 +80%);订阅用量不收长上下文附加费;API 与手动设置仍按 >272k 输入 2 倍、输出 1.5 倍计费;上限仍 1M | 抬默认水位而不是抬上限——用体验锁定企业工作流,而不是打参数军备竞赛 |
| 4 | vLLM Semantic Router Decision 3.0(补录 · 权重 2026-10-10 上传) | 六档全 Apache-2.0:d3 26.09B / d3-flash 8.39B / d3-mini 4.54B / d3-nano 2.21B / d3-lite 0.85B / d3-edge 0.59B;三类问法(Choice / 是非 / 评分)每个选项给概率、不生成 token;单卡 MI325X 单请求延迟中位:文本 55ms、图片 273ms、10 秒视频 553ms | 厂商自测、榜单由团队自建、无第三方复现——但权重真的在 HF 上,这一点无可辩驳 |
| 5 | Microsoft AesCode 8B / 32B(补录 · 2026-10-07 静默上线) | 生成可编辑 HTML/CSS 的幻灯片/海报/看板;32B 起于 Qwen3-VL-32B-Instruct,cold-start SFT + GDPO 七路奖励;300 样本自测 32B Overall 85.89(Rule 94.33 / Visual 77.44)、8B 82.94;严重边界失败率 32B 4.3% vs GPT-5.5 34.7%;Apache-2.0,bf16 32B 约需 65GB 加速器内存 | 真正的卖点藏在一个小数字里:不给参考图时 8B 的视觉分只掉 1.00 分,而基座 Qwen3-VL-8B-Instruct 掉 19.55 分——它被训练成会用参考图,而不是长出审美 |
条目 1 补充:Artificial Analysis 智能指数(第三方,经二手转述)Muse Wonder Full 56 / Muse Wonder 52,对照 Claude Opus 5.5 58、Sonnet 5.5 56、GPT-6 Astra 53。定价为 VentureBeat 转述:Wonder 在 Meta Model API 为 $4 / $20 每百万 token;Wonder Full 只给 Muse Code 订阅(Power $50/月、Maximum $200/月),DeepSWE 1.1 报 79.0。两个模型均在 Meta 俄亥俄 Prometheus 数据中心训练。 来源:Meta 官方博客 · https://research.meta.ai/blog/muse-wonder · 2026-10-12
条目 3 补充:一手为 OpenAI 产品负责人 Thibault Sottiaux 的 X 帖(2026-10-11,自述为「Day 7」);本次未能在 OpenAI Codex changelog 读到对应条目,属官方个人账号口径。
条目 4 补充:d3 自测 Jev Decision Index 0.3.1 文本 64.7 / 视觉 71.6,9B 档(d3-flash)超过上一代 27B。模型可本地部署,vLLM Semantic Router 的原生支持目前在开发通道。
条目 5 补充:这次发布没有任何官方公告——无博客、无 release notes、无预印本,模型卡引用栏写「审稿中 2027」(明显是占位符)。截至 2026-10-11,8B 仓库显示两次下载、一个赞。
二、工程与架构
| # | 条目 | 改了什么 | 为什么值得看 |
|---|---|---|---|
| 1 | llama.cpp b11574–b11577(2026-10-12 单日四版) | b11574:Hexagon NPU 的 CPY/CONCAT 第三轮优化,专治「短行」——把转换型 CPY 按行分块交给 DMA 描述符、避免短行被 DMA 延迟绑死;新增 HVX gather-row 线程化、f16 快路、双缓冲、按 mdev 拆任务;并修掉 mdev 场景下 vtcm_acquire 同步状态非原子导致的随机挂起。b11577:修 vLLM d3 系列的多序列用例 |
关键信息在「第三轮」三个字:同一个 kernel 被反复拆解,说明 NPU 后端仍在被逐条行打通。那个随机挂起是并发正确性 bug,不是性能调优 |
| 2 | Ollama v0.40.4-rc0(2026-10-12) | mlx: compact restored recurrent state after speculative rollback——投机解码回滚后压缩恢复的循环状态;server 复用已验证 manifest 与已加载模型;内置 llama.cpp 升到 b11521 以支持决策模型与 EmbeddingGemma 2;Codex 的 /model 选择器出现本地已装模型 |
投机解码回滚会留下未清理的循环状态,是状态机语义 bug而非速度问题;这类 bug 在启用 MLX 默认后端之后才容易暴露 |
| 3 | Agno v3.1.3:外部 agent 的会话变持久(2026-10-12) | ClaudeAgent 的 SDK session id 落库、transcript 逐行镜像进 agno_transcripts 表,换副本也能续;ClaudeAgent/CodexAgent 支持 background=True、可取消、可索引 SSE;continue_run 以每个工具结果为检查点、可从中间 fork,已完成的 run 不被原地改写(续跑是新的兄弟 run) |
把「跑完就消失」的外部 agent 变成可运维对象。检查点级重放比整轮重跑便宜得多,这条对长任务的成本曲线影响很直接 |
| 4 | Adaptive DHiSparse:把投机解码架到分层稀疏 KV 上(arXiv:2610.13708) | HiSparse 把历史放主机内存按需取,但每档负载用同一个缓存预算、且不支持 draft 模型投机解码;本工作按负载调整常驻集(先保工作集、显存有闲就多留历史、其余走精确融合检索),draft KV 用窗口受限 ring buffer,验证阶段跨层组复用 | 数字:100K 上下文并发 128,GLM-5.3 + DFlash2 单解码 GPU 793 输出 tok/s(1.45× HiSparse、1.27× 非投机自适应);同样延迟上限下并发到 4×、输出 2.3–3.7× |
条目 1 来源:https://github.com/ggml-org/llama.cpp/releases/tag/b11574 · 2026-10-12(内容为 release body 中补丁自述) 条目 2 来源:https://github.com/ollama/ollama/releases/tag/v0.40.4-rc0 · 2026-10-12 条目 3 来源:https://github.com/agno-agi/agno/releases/tag/v3.1.3 · 2026-10-12 条目 4 来源:https://arxiv.org/abs/2610.13708 · v1 提交 2026-10-09(2026-10-12 公告)
三、行业与发展
1. 英国政府 AI 风险一揽子措施(更新 · 首报 2026-10-11)
首发时只有「拟修订《网络安全与韧性法案》加入 AI 代理失控条款」一句。2026-10-12 的官方新闻稿给出完整四条(由内阁办公室、AI 安全研究院、国家网络安全中心、DCMS 联合发布):
- 扩大用前沿模型做网络防御——两个试点已识别并修复政府系统内 1,000+ 个潜在漏洞
- AI 安全研究院(AISI)已对最新一代先进模型开展严格评测(与主要开发商及美国政府协作后启动)
- 为国家应对涉及自主 agent 的重大事件做准备(与 NCSC、AISI 共同研究响应方式)
- 研究如何识别与上报未遂事件,并探索在《网络安全与韧性法案》框架下加强保护,明确点出「AI 失控风险,即自主系统脱离人类监督」
AI 大臣 Kanishka Narayan 对厂商的原话:「若你无法充分控制风险,就不要发布这个系统。」
边界必须说清:法案相关全部是「考虑中/将探索」,不是你已生效的义务;新闻稿未点名任何被评测的开发商或模型,也未给出试点漏洞的严重度分级、测试方法与独立验证。
同日关联:Reuters 转引 The Telegraph — 美方放宽了此前劝阻 OpenAI/Anthropic 与英方分享新模型的立场,实际打开了发布前评估通道。白宫与两家公司均未回应置评请求。两件事合起来看,才是这一条的分量。
来源:GOV.UK · https://www.gov.uk/government/news/britain-steps-up-national-defences-against-growing-ai-risks · 2026-10-12
2. Microsoft 总裁 Brad Smith:AI 受到的监管比牛奶还少(2026-10-12)
接受 BBC 采访(经 Reuters 报道)时提出:需要一套全球安全规则,包括独立评估方、被 rogue agent 攻破时须通知「受害者」、随时可用的紧急制动、以及法律强制的事件报告。原话:「现在,你的洗衣机受到的安全规则比 AI 还多。货架上每一盒牛奶都要接受安全规则和检验。」 他认为英国因 AI 安全研究院的既有安排最适合领头,并称华盛顿对伦敦的看法与对布鲁塞尔(按风险分级监管)截然不同。
判断:这跟同日英国的一揽子措施、以及 Anthropic(10-10 意外行为报告)、OpenAI(misalignment 报告)的自我披露是同一股力——治理重心正从「透明度声明」转向可中断、可调查、可上报。对采购方是有利的:供应商必须在合同里回答可观测性与急停问题。
来源:Reuters(经 MarketScreener 转载)· https://au.marketscreener.com/news/microsoft-president-says-milk-faces-more-regulation-than-ai-ce785ddcd189f422 · 2026-10-12
3. 无问芯穹完成 23 亿元 C 轮(2026-10-12)
- 累计融资 43 亿元;证券时报称单轮与累计金额均刷新国内 AI Infra 赛道纪录
- 资方横跨三类:国资(杭州高新金投、社保中关村基金、珠海科技产业集团、徐汇资本)、产业资本(腾讯、百度、联想)、财务投资(红杉中国、启明创投、顺为资本)
- 业务口径(均为公司自述):不自持大规模数据中心,做异构算力调度;已触达 3.7 万 P 算力、覆盖 16 种芯片、千卡异构混训平台具万卡扩展性,算力利用率最高 97.6%;自研跨集群异构 PDD 架构称首 token 延迟 −51.5%、单 token 成本 −37.5%
- 10 月初已传以保密形式向港交所递交 IPO 申请,最早 2027 上半年挂牌
判断:这一轮的定义性事实是「算力运营商」而非「造芯片或做模型」拿到国内 AI Infra 最大单笔——说明市场在押注碎片化算力的调度价值,而不是再投一家模型公司。
来源:证券时报 · https://stcn.com/article/detail/4213036.html · 2026-10-12
4. 模思智能(OpenMOSS / 邱锡鹏)完成超 10 亿元 Pre-A 轮(2026-10-12)
华控基金领投,国开科创、上海科创基金、新微资本、徐汇资本、追光硬科技创投、临港策源基金等参与,老股东持续加注。公司由复旦大学与上海创智学院联合孵化,创始人邱锡鹏为复旦特聘教授、MOSS 开源对话模型与 SpeechGPT 的核心作者。
- 方向:全模态实时交互智能——让模型在持续流入的语音、画面、动作与环境状态中判断用户此刻需要什么
- 半年内围绕语音、视觉、实时多模态连续发布 20 多个模型并持续开源
- 即将发布 MOSS Live:前端交互模型持续看/听/说,后端能动性模型负责复杂推理与任务执行
- 本轮距 2026 年 4 月的数亿元天使轮仅半年
来源:上海证券报 / 中国证券网 · https://www.cnstock.com/commonDetail/800692 · 2026-10-12
四、论文与开源
本节口径:arXiv
cs.AI/cs.LG/cs.CL的 recent 列表显示 2026-10-12(周一)公告 cs.AI 161 篇等。逐篇核对发现抽检的 v1 提交日多为 2026-10-09(含周末积压)。本节按「公告日」计入本期,但每条显式标注提交日,避免把「公告」当成「首次公开」。
| # | 论文 | 核心方法与结论 |
|---|---|---|
| 1 | AI Models Can Provably Hide Arbitrary CapabilitiesarXiv:2610.13928 · v1 2026-10-09 | 用 digital locker 把加密后的神经网络嵌进宿主权重,只有收到秘密触发器才解密并执行。在密码学假设下,即便拿到全部权重,隐藏电路也「可证明地」难以诱导。把此前只能藏固定字符串的工作扩到任意计算。实测抗微调、权重加噪、基于梯度的触发器搜索、潜空间对抗训练,任务为化学反应用预测(CBRN 相关能力的代理)。作者开源了模型以帮助改进防御。判断:这是对「能力评测能测出危险能力」这一整套假设的正面打击——若成立,能力评测的效力上限来自密码学,而不是工程。 |
| 2 | When Faster Decisions Do Not Make Better Agents: An Empirical Study of Jev in Agent WorkflowsarXiv:2610.13092 · v1 2026-10-09 | 在 ALFWorld(具身)与 AndroidWorld(移动 App)两个场景、五个 agent 上做 4,500 次任务执行。结论:接入 Jev 后五个 agent 的决策成本与延迟都显著下降;但任务成功率在 ALFWorld 基本持平,在两个移动 agent 上明显下滑。机制:省下的决策预算被辅助推理与额外交互吃掉,失败恢复与过早宣告完成限制了交付。最刺的一点是——有一个 agent 单次尝试更便宜了,但「每个成功结果的平均成本」反而上升。 |
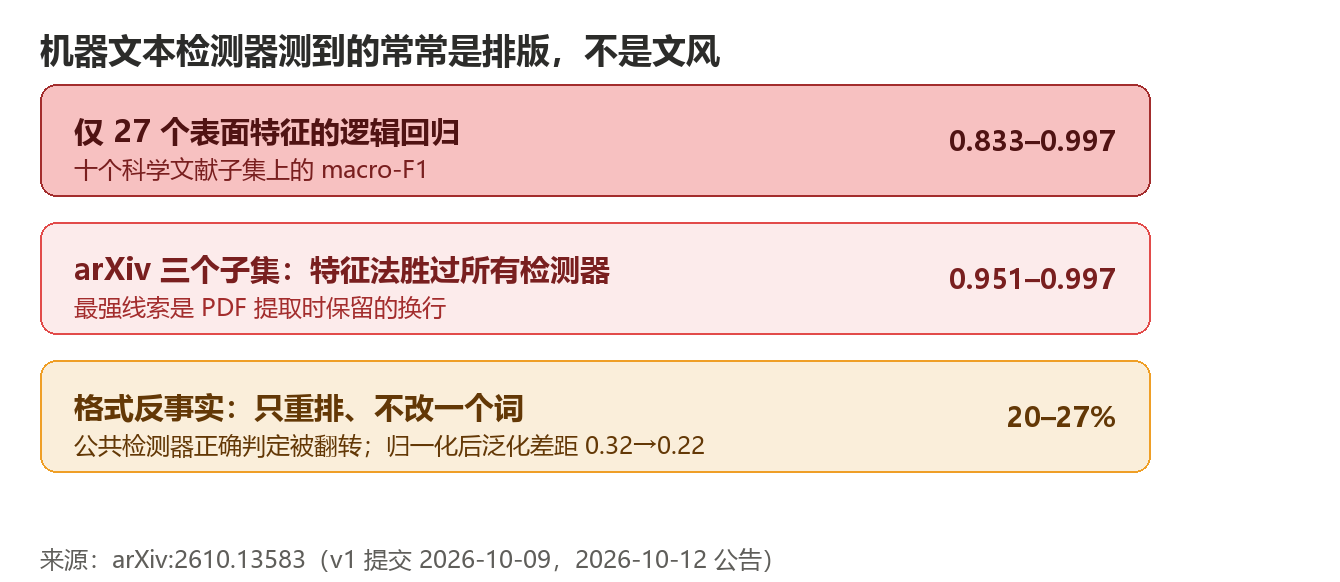
| 3 | Measuring Artifact Reliance in Machine-Generated Text DetectorsarXiv:2610.13583 · v1 2026-10-09 | 十个科学文献子集、六个常用资源。仅用 27 个表面特征的逻辑回归就拿到 macro-F1 0.833–0.997;在三个 arXiv 子集上 0.951–0.997,胜过所评测的全部检测器。最强线索是 PDF 提取伪影:人类文本保留原始换行,生成文本被抽成整块散文。格式反事实测试:只把机器写好的摘要重新折行、不改一个词,公共检测器的正确判定被翻转 20–27%。训练前做格式归一化,泛化差距从 0.32 降到 0.22。 |
| 4 | Agreement Without Alignment: Label-Free Rubric Clarification Increases LLM-Judge Consensus but Not Agreement with HumansarXiv:2610.13303 · v1 2026-10-09 | 无标注流程:把 rubric 拆成子准则,按跨评审分歧排序,只让编辑模型改写争议最大的那些(人类标签从不参与选择或改写,只用于最后评估)。三个基准、五名评审(三家厂商),合计 129,770 次评审请求。SummEval 上评审间 Krippendorff α 提升 0.069(95% CI 0.046–0.092),相对「随机改写同数量条款」的对照高 0.074;但「与专家评分的一致度」没有可检出的改善。另一项设计(把可文本核查的子准则交给确定性检查器)在本次评测中一条都没迁移成功。 |
| 5 | Prediction Is Not a Sufficient Memory StatearXiv:2610.13881 · v1 2026-10-09 | 理论工作。一个能复现当前所有预测的记忆,仍可能已忘掉如何从下一个观测里学习。对光滑凸残差损失:存在固定维连续循环状态当且仅当损失是多项式;D 次需要恰好 r = C(d+D, D) − 1 个坐标;即便在「当前预测相同」的历史族里,仍有 r − d 个坐标是必要的。岭回归下精确状态要 dp + d(d+1)/2(即设计矩阵),而只记预测器只要 dp。把 KV/循环状态的压缩上限从经验问题变成可证的维度问题。 |
出处(逐条)
- https://arxiv.org/abs/2610.13928
- https://arxiv.org/abs/2610.13092
- https://arxiv.org/abs/2610.13583
- https://arxiv.org/abs/2610.13303
- https://arxiv.org/abs/2610.13881
为什么选这五条:其余 cs.AI 当日条目多为增量式 RL / 蒸馏 / benchmark 变体。这五条分别落在「安全评测的有效性上限」「决策模型的真实 ROI」「文本检测的效度」「LLM-judge 的效度」「记忆压缩的理论边界」——都是会改变别人怎么做决定的结论,而不是又刷高一个分数。
五、值得关注的趋势
趋势一:决策模型这一波,开源在打价格,一篇论文在打结论
vLLM-SR 把 Decision 3.0 六档(0.59B–26.09B)全以 Apache-2.0 放出,等于让 TypeSafe 与 Microsoft 共同锚定的 $0.042/M 输入、输出免费在自托管场景下变成一个无关的地板价。但同一窗口内 arXiv:2610.13092 用 4,500 次执行说明:决策层的省时省钱不会自动传导到任务层,甚至会出现「每次尝试更便宜、每个成功结果更贵」的反转。
判断:决策模型当前能兑现的价值点在确定性路由、护栏判定、批量打分这类「问题有固定选项」的场景,不在于「替 agent 做决策」。评估这类模型时,该看的不是决策指数,而是每个成功任务的全成本——而后者恰恰是厂商 benchmark 里从不出现的数字。
趋势二:前沿能力的变现路径,正从 token 转向席位
Meta 把智能指数更高的一档(Wonder Full)只给 Muse Code 订阅($50/月 Power、$200/月 Maximum),API 上只放较小的 Wonder。这是把最贵的能力卖成座位,而不是按量计费。配合 Zuckerberg 在 2026-09-15 拒绝减速的表态与 1300–1450 亿美元的 2026 年资本开支指引,这家公司的回收路径明显押在消费与订阅侧,而非开发者 API 侧。
对买方的具体含义:想找一个「非 OpenAI、非 Anthropic」的第二前沿供应源,在 API 上拿不到最强档。多供应商策略需要按「席位渠道」重写采购假设,而不是继续按 token 单价比价。
趋势三:法律垂直同一天被两家拿同一个基准说事,而这个基准是卖方定义的
Meta 用 Harvey LAB 论证法务任务能力,Z.ai 用 Harvey LAB 的全通过率 19.2% 论证端到端不掉链——而 Harvey 本身就是一家法律 AI 公司。真正值得记住的是那个数:在严格全通过判分下,旗舰模型也只有不到五分之一的任务能全程无瑕疵交付。
判断:垂直 agent 的真实门槛不在单步推理,在多步骤零容错。而当一个细分赛道的「权威基准」由赛道内的一家商业公司定义并维护时,读者需要同时问两个问题——分数是多少,以及是谁在计分。
趋势四:治理从「原则」走向「可中断、可调查、可上报」
英国 10-12 的一揽子措施(AISI 评测最新模型、为自主 agent 重大事件做响应准备、研究未遂事件上报)与 Microsoft 总裁同日提出的「紧急制动 + 事件报告 + 通知受害者」,指向同一套操作化要求;美方同日的立场放宽则把发布前评估通道实际打开。把它们与 Anthropic 10-10 的意外行为报告、OpenAI 的 misalignment 报告并置看,行业正在形成一种顺序:先自曝,再要求规则。
判断:这对采购方是净利好——「能不能停、能不能查、能不能报」从合规话术变成了合同条款。但同时也要注意,这一批动作里有大量「考虑中/将探索」的成分,尚无可执行的时限与罚则。
六、有趣的 AI 开源项目
| 项目 | 星数与许可 | 做什么 / 为什么值得看 |
|---|---|---|
| morluto/rea(更新 · 首报 2026-10-07) | 146,406★(单日 +45,495,连续两天 GitHub Trending 第一)· MIT | 通过 MCP 把 agent 接到 Hopper / Ghidra / IDA、WABT、pwntools,对原生二进制、JS/Electron 应用、网站、EVM 字节码给带证据的结论,而不是让 LLM 盯着汇编猜。前一日为 96,754★ / +25,585——星数在加速而非退潮 |
| mksglu/context-mode | 27,096★ · Elastic License v2 | 把 MCP 工具输出在进上下文之前先沙箱化(单次 Playwright 快照可达 56KB),自称削减 98%;并在会话被压缩后仍记得哪些文件在改、哪些任务未完成。跨 17 个平台分发,npm 安装。口径说明:10-11 期只登记了仓库名、未展开,本期补齐实质内容 |
| cathrynlavery/diagram-design | 52,255★(+2,100)· MIT | agent skill:把 44 种图输出成单个自包含 HTML+SVG(可套品牌样式),支持从 draw.io / Mermaid / Excalidraw 导入、导出 PNG/SVG,不需要额外渲染服务。同样是 10-07 期只登记了名字、本期补实质 |
| openmed 3.0.0 | Apache-2.0 · 148 个 PR(其中 46 个来自社区) | 本地优先临床工具包。3.0 新增 Patient Journey:把门诊记录、FHIR 流、HL7 消息、检验 CSV、影像报告拼成单个患者时间线,全部在本机硬件上跑(Transformers / ONNX / GGUF+llama.cpp / 浏览器 WebGPU / 手机均可)。「不猜」的设计哲学很硬:99% 身份匹配也不自动合并、必须人工复核;两个来源诊断冲突就都保留并标待审;检验值被更正则两个版本都留;本地模型没下载就拒绝出摘要、绝不静默转云。官方自设边界:3.0 的摘要管线仅面向合成数据、尚不能用于真实患者,且本次不包含新的临床模型 checkpoint |
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止日期 |
|---|---|---|---|---|---|---|
| 1 | 模型与产品 | Muse Wonder: A Frontier Model For Personal & Professional AI Agents | Meta(research.meta.ai 官方博客) | https://research.meta.ai/blog/muse-wonder | 2026-10-12 | 2026-10-12 |
| 2 | 模型与产品 | GLM-Legal: Advancing Agentic Legal Intelligence | Z.ai(官方博客) | https://z.ai/blog/glm-legal | 2026-10-12 | 2026-10-12 |
| 3 | 模型与产品 | GPT-6.1 Sol 默认上下文提升至 500k | OpenAI 产品负责人 Thibault Sottiaux(X) | https://x.com/thsottiaux | 2026-10-11 | 2026-10-11 |
| 4 | 模型与产品 | Muse Wonder 定价与第三方智能指数(Muse Wonder / Muse Wonder Full 52 / 56;Wonder Full 仅 Muse Code $50/$200;DeepSWE 1.1 79.0) | AI Weekly(转述 Wired / VentureBeat) | https://aiweekly.co/alerts/meta-releases-muse-wonder-its-first-frontier-class-ai-model | 2026-10-12 | 2026-10-12 |
| 5 | 模型与产品 | Decision 3.0 六档权重(d3 26.09B 等,Apache-2.0) | vllm-sr(Hugging Face 机构页) | https://huggingface.co/collections/vllm-sr/decision-30 | 权重上传 2026-10-10 | 2026-10-10 |
| 6 | 模型与产品 | Decision 3.0 家族盘点、分数与延迟口径 | OrcaRouter(公开盘点,非官方公告) | https://www.orcarouter.ai/blog/decision-3-0-open-multimodal-decision-models | 2026-10-12 | 2026-10-10 |
| 7 | 模型与产品 | microsoft/AesCode-32B 模型卡(300 样本自测、Apache-2.0、需约 65GB) | Microsoft(Hugging Face 仓库本体) | https://huggingface.co/microsoft/AesCode-32B | 权重上传 2026-10-07 | 2026-10-07 |
| 8 | 模型与产品 | AesCode 发布细节与「不给参考图掉 1.00 分」对照 | OrcaRouter(含模型卡引用) | https://www.orcarouter.ai/zh-TW/blog/microsoft-aescode-8b-quiet-release | 2026-10-12 | 2026-10-11 |
| 9 | 工程与架构 | llama.cpp b11574:Hexagon CPY/CONCAT 第三轮(短行)优化 | ggml-org/llama.cpp(release body) | https://github.com/ggml-org/llama.cpp/releases/tag/b11574 | 2026-10-12 | 2026-10-12 |
| 10 | 工程与架构 | llama.cpp b11577:修 vLLM d3 多序列用例 | ggml-org/llama.cpp | https://github.com/ggml-org/llama.cpp/releases/tag/b11577 | 2026-10-12 | 2026-10-12 |
| 11 | 工程与架构 | Ollama v0.40.4-rc0(MLX 投机回滚循环状态、manifest 复用) | ollama/ollama | https://github.com/ollama/ollama/releases/tag/v0.40.4-rc0 | 2026-10-12 | 2026-10-12 |
| 12 | 工程与架构 | Agno v3.1.3(外部 agent 持久化会话 / 后台运行 / 检查点重放) | agno-agi/agno | https://github.com/agno-agi/agno/releases/tag/v3.1.3 | 2026-10-12 | 2026-10-12 |
| 13 | 工程与架构 | Adaptive DHiSparse: Speculative Decoding over a Load-Adaptive KV Hierarchy | arXiv:2610.13708 | https://arxiv.org/abs/2610.13708 | 2026-10-12 公告(v1 2026-10-09) | 2026-10-09 |
| 14 | 行业与发展 | Britain steps up national defences against growing AI risks | GOV.UK(内阁办公室 / AISI / NCSC / DCMS) | https://www.gov.uk/government/news/britain-steps-up-national-defences-against-growing-ai-risks | 2026-10-12 | 2026-10-12 |
| 15 | 行业与发展 | Microsoft president says milk faces more regulation than AI | Reuters(经 MarketScreener 转载) | https://au.marketscreener.com/news/microsoft-president-says-milk-faces-more-regulation-than-ai-ce785ddcd189f422 | 2026-10-12 | 2026-10-12 |
| 16 | 行业与发展 | 再融 23 亿元!清华系独角兽刷新国内 AI Infra 赛道融资纪录 | 证券时报 | https://stcn.com/article/detail/4213036.html | 2026-10-12 | 2026-10-12 |
| 17 | 行业与发展 | 模思智能完成超 10 亿元 Pre-A 轮融资 | 上海证券报 / 中国证券网 | https://www.cnstock.com/commonDetail/800692 | 2026-10-12 | 2026-10-12 |
| 18 | 论文与开源 | AI Models Can Provably Hide Arbitrary Capabilities | arXiv:2610.13928 | https://arxiv.org/abs/2610.13928 | 2026-10-12 公告(v1 2026-10-09) | 2026-10-09 |
| 19 | 论文与开源 | When Faster Decisions Do Not Make Better Agents: An Empirical Study of Jev in Agent Workflows | arXiv:2610.13092 | https://arxiv.org/abs/2610.13092 | 2026-10-12 公告(v1 2026-10-09) | 2026-10-09 |
| 20 | 论文与开源 | Measuring Artifact Reliance in Machine-Generated Text Detectors | arXiv:2610.13583 | https://arxiv.org/abs/2610.13583 | 2026-10-12 公告(v1 2026-10-09) | 2026-10-09 |
| 21 | 论文与开源 | Agreement Without Alignment: Label-Free Rubric Clarification… | arXiv:2610.13303 | https://arxiv.org/abs/2610.13303 | 2026-10-12 公告(v1 2026-10-09) | 2026-10-09 |
| 22 | 论文与开源 | Prediction Is Not a Sufficient Memory State | arXiv:2610.13881 | https://arxiv.org/abs/2610.13881 | 2026-10-12 公告(v1 2026-10-09) | 2026-10-09 |
| 23 | 开源项目 | morluto/rea(146,406★,+45,495) | GitHub | https://github.com/morluto/rea | 2026-10-13 | 2026-10-13 |
| 24 | 开源项目 | mksglu/context-mode(27,096★) | GitHub | https://github.com/mksglu/context-mode | 2026-10-13 | 2026-10-13 |
| 25 | 开源项目 | cathrynlavery/diagram-design(52,255★) | GitHub | https://github.com/cathrynlavery/diagram-design | 2026-10-13 | 2026-10-13 |
| 26 | 开源项目 | openmed 3.0.0(Apache-2.0,Patient Journey) | GitHub / PyPI | https://github.com/maziyarpanahi/openmed/releases/tag/v3.0.0 | 2026-10-12 前后 | 2026-10-12 |
| 27 | 线索发现 | AI Agent GitHub Digest — 2026-10-13 | quidproquo | https://quidproquo.cc/posts/daily/2026-10-13-ai-agent-github-digest-en | 2026-10-13 | 2026-10-13 |
| 28 | 线索发现 | AI/TLDR 当日条目流(用于发现 Muse Wonder / GLM-Legal / Karpathy) | AI-TLDR | https://ai-tldr.dev | 2026-10-13 | 2026-10-13 |
自绘配图说明: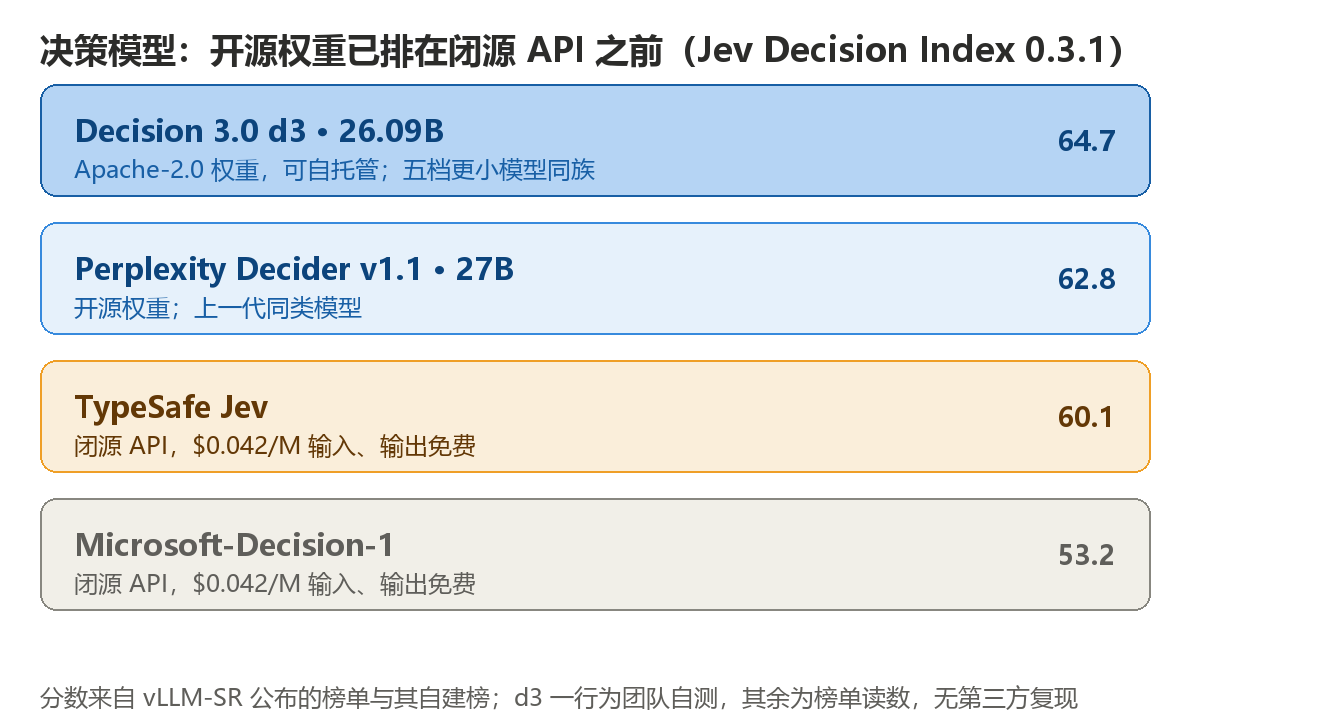、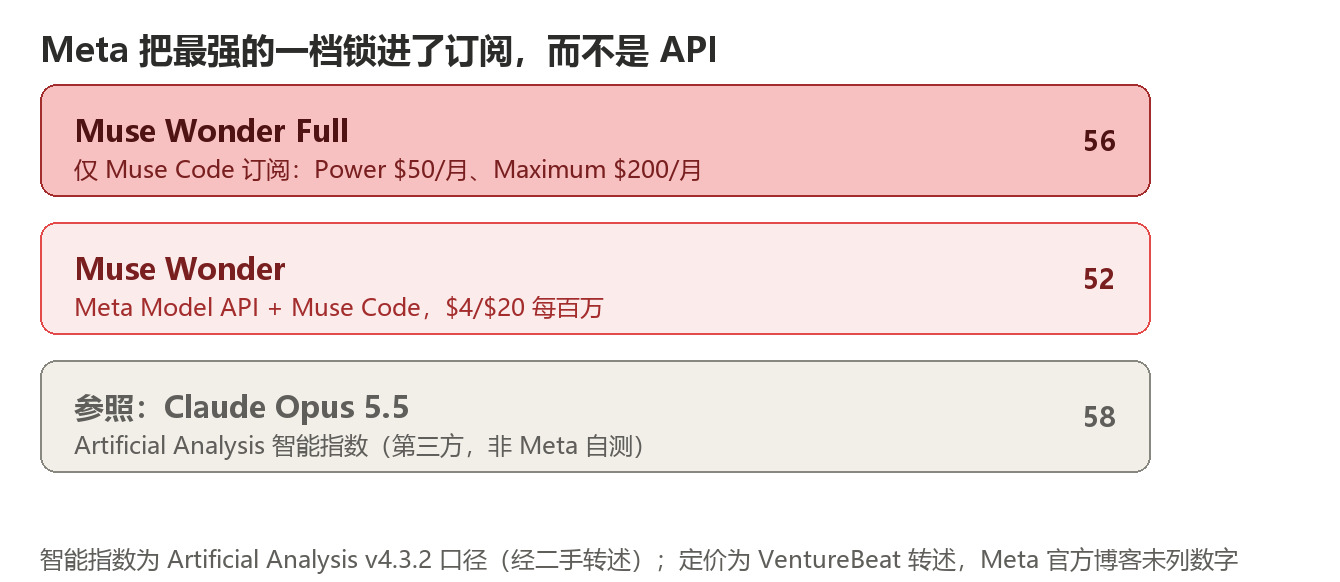、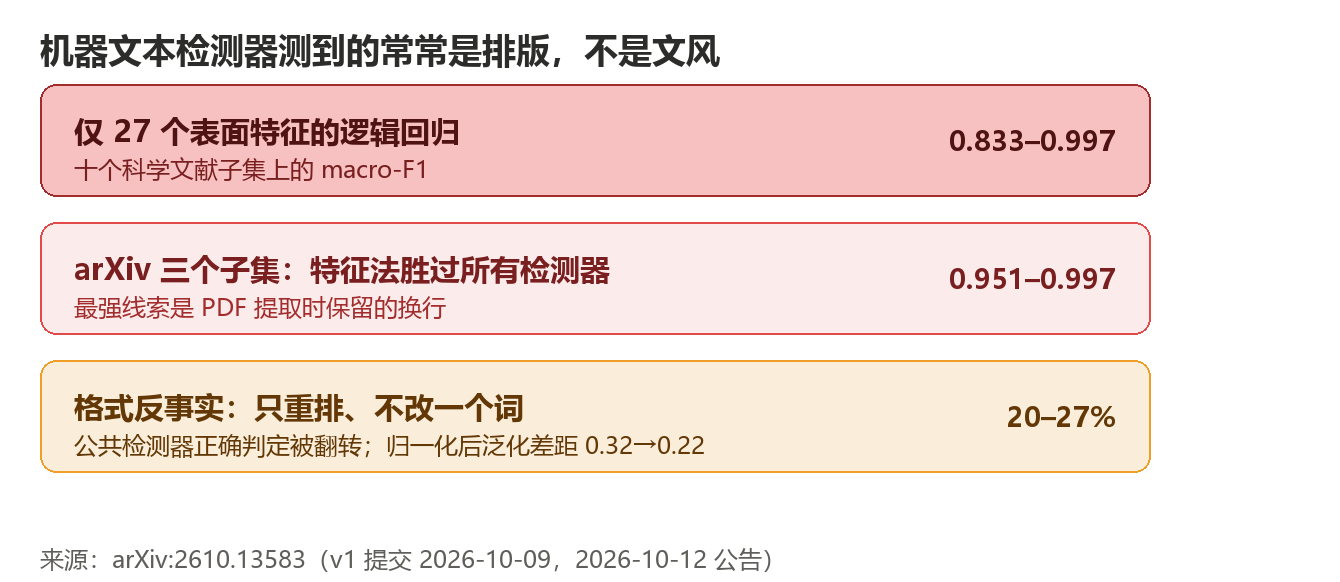 三张均为本笔记自绘示意图,非原文插图;数据取自上表第 4–6、18–20 项。

本期淘汰记录
| # | 候选 | 淘汰理由 |
|---|---|---|
| 1 | OpenAI 数学手稿「仅 42% Lean 化」批评潮 | 首发 2026-10-06/07,已报道(索引 10-07 行、10-08 已补更新)。本次新增的剑桥/KCL 关于 Navier–Stokes 自然语言证明与 Lean 代码不一致的论文,发布时间落在窗口外 |
| 2 | Zuckerberg「拒绝减速 + 2026 年 1300–1450 亿美元资本开支」 | 表态日期 2026-09-15,窗口外(仅作趋势二的背景资料并已标注日期) |
| 3 | Altman / Amodei / Delangue 在联合国安理会发言 | 会议日期 2026-09-23,窗口外。聚合站把它当「近日事件」重提,属旧闻重发 |
| 4 | EU 技术主管 Virkkunen 称「AI Act 足以应对 rogue agent」 | 表态 2026-10-09,早于窗口起点 |
| 5 | 纽约市议会 AI 听证(OpenAI / Anthropic / Meta / Google 均不保证护栏) | 听证 2026-10-05,窗口外 |
| 6 | 英国医疗 AI 监管 44 条建议获政府全盘接受 | 窗口外 |
| 7 | Meta Muse 下载 660 万 / 日活 180 万 | 已报道(索引 10-09 行),本期无实质新进展 |
| 8 | Microsoft-Decision-1「比 GPT-6 Sol 快 35 倍」 | 已报道(索引 10-10 行);本轮新增说法仍只有二手中文转述,无一手依据 |
| 9 | Cloudflare Clef-omni、KernelAI、Vals AI、MOLT Sinai、Nish Tahir 决策模型教程、Odyssey-3、Epoch InnovationEval、arXiv 投稿限流 | 均为 10-11 / 10-12 期已报道条目,本期窗口内无实质新进展 |
| 10 | mhtsec/ARTEX、zhongerxin/iPhone-use、rociiu/talorys | 已报道(索引 10-12 行) |
| 11 | Pydantic AI v2.55.0「弃 Python 3.10」 | 10-12 期已按一手 release 核对并淘汰(release 无此变更);本期 digest 再次出现同一说法,仍无一手依据 |
| 12 | Project Maya / Strata 本地跑 GLM-5.3-Flash 提速 10→30 tok/s | 单一 Reddit 用户自述,无一手复现、无原始日志 |
| 13 | Nextech × Assort Health / EliseAI 多年期合作 | 纯合作公告,无实测结果,写不出「为什么值得关注」 |
| 14 | o9 Digital Tomorrow Grant 25 万美元 | 公益资助,与 AI 技术进展无关 |
| 15 | AMD 向 OCP 贡献 Helion 机架规范 | 仅见于中文早报转述,未能回溯到 AMD 官方一手页面与确切日期 |
⚠️ 待核实
| # | 条目 | 缺什么证据 |
|---|---|---|
| 1 | Meta Muse Wonder / Wonder Full 的逐项基准分数 | 官方博客正文只有图、模型卡 PDF 在本次环境不可访问。智能指数 52/56、DeepSWE 1.1 79.0 均为二手转述(AI Weekly 引 Wired / VentureBeat)。需官方模型卡或 Artificial Analysis 模型页原始读数 |
| 2 | Muse Wonder 系列的参数规模、上下文长度、活跃参数 | 官方博客完全未披露,需技术报告 |
| 3 | microsoft/BitNet「新增 1-bit 嵌入模型(0.6B / 270M)」 | 来自 GitHub digest 摘要,但其 releases 页未找到对应 tag。需官方 release 或 commit |
| 4 | Decision 3.0 的「#1 on both boards」与全部分数 | HF 权重可下载(一手)成立,但所有分数与榜单均由团队自维护,无独立复现。需第三方在自有标注上复测 |
| 5 | 美方放宽对英 AISI 发布前访问 | Reuters 转引 The Telegraph,白宫与 OpenAI / Anthropic 均未回应。需官方确认 |
| 6 | GPT-6.1 Sol 500k 默认上下文 | 一手为 Thibault Sottiaux 的 X 帖,Codex changelog 未见对应条目。需官方 changelog 写入 |
引用提醒:本笔记所有条目均带原始链接与日期。厂商自测的 benchmark 已逐条标注「厂商自测、无独立复现」,不要当作第三方结论使用;涉及具体定价、分数、百分比的引用,请回到一手页面逐项核对。榜单类数字(尤其 Jev Decision Index)注意区分「榜单读数」与「团队自测」,本笔记已逐处标注。三张配图为自绘示意图,用于说明结构关系,不替代原文数据。