AI DAILY
AI 日报 2026-10-28
一句话结论本期收录 29 条(含 1 条更新)、淘汰 14 类候选:Cloudflare 公开 GLM-5.3 跨请求 KV 缓存暴露的完整故障链——155 条响应含他人数据,根因是「KV 池 681,280 token < 声明上下文 1,048,576」叠加 SGLang 把拒绝状态记错字段,而返回的仍是 HTTP 200;同窗口 Warp 被第三方 vendor 攻陷、agent 决策日志外泄,TrendAI 记录 44 个 AI agent 全自主打穿日本至少 16 家组织。模型侧开放权重两端同日刷新上限(端侧 LFM3 用约 1 GB 内存跑 256K 上下文,服务端 Ling-3.1 用 MIT 放开 560B/25B 激活);科学侧 Anthropic 用 Lean 4 递交「3-SAT 亚指数算法」反驳 ETH、Axiom 用 24 天形式化完有限单群分类——「谁来认证」比「谁先证出」更稀缺。
AI 日报 2026-10-28
整理日期:2026-10-28 素材来源:白名单一手信源(厂商官方博客与模型卡、arXiv 原始页面、GitHub 仓库与 release、Cloudflare / TrendAI / Anthropic 官方公告、Reuters / Bloomberg / CNBC / BleepingComputer / 科技日报 / 中证网等),逐条见文末附录 可信度提示:本期统计窗口 2026-10-27 09:45 → 10-28 12:00 HKT。arXiv 本窗口对应 10-25/10-26 提交批次(2610.345xx–2610.376xx),于 10-27 20:00 ET(= 10-28 08:00 HKT)压线公告,论文节节首另有口径说明。厂商自测 benchmark 均已显式标注「厂商自测、无独立复现」。Cloudflare 事件为协调披露(10-26 发布,报告人 9-8 提交),按「首次进入公开视野」计入本期。Warp 事件 CEO 表态发布于 10-26,BleepingComputer 报道于 10-27。huggingface.co 本环境不可直接访问,Ling-3.1 条目按官方模型卡 + 二手交叉处理(见待核实区)。 配图:文中三张示意图为自绘(依据上列来源整理),非原文插图。
#AI日报 #模型动态 #工程架构 #论文 #开源项目
一句话结论
本期收录 29 条(含 1 条更新)、淘汰 14 类候选:Cloudflare 公开 GLM-5.3 跨请求 KV 缓存暴露的完整故障链——155 条响应含他人数据,根因是「KV 池 681,280 token < 声明上下文 1,048,576」叠加 SGLang 把拒绝状态记错字段,而返回的仍是 HTTP 200;同窗口 Warp 被第三方 vendor 攻陷、agent 决策日志外泄,TrendAI 记录 44 个 AI agent 全自主打穿日本至少 16 家组织。模型侧开放权重两端同日刷新上限(端侧 LFM3 用约 1 GB 内存跑 256K 上下文,服务端 Ling-3.1 用 MIT 放开 560B/25B 激活);科学侧 Anthropic 用 Lean 4 递交「3-SAT 亚指数算法」反驳 ETH、Axiom 用 24 天形式化完有限单群分类——「谁来认证」比「谁先证出」更稀缺。
一、模型与产品
1. Liquid AI LFM3:六个 2B 级模型共用一条骨干,4-bit 约 1 GB 内存跑 256K 上下文(厂商自测)
Liquid AI 10-27 发布 LFM3 家族,六个模型全部长在同一条 LFM3-1.7B-Base 骨干上:文本(LFM3-1.7B)、视觉(LFM3-VL-2B)、音频(LFM3-Audio-2B)、全模态(LFM3-Omni-2B),以及两个决策模型(d1-2B、d1-omni-2B)。
- 架构:24 层三混合——13 层门控短卷积(kernel 7)+ 5 层滑动窗口注意力(窗口 256)+ 6 层全局注意力。LFM3-1.7B 为 1.73B 稠密参数,4-bit 量化后约 1 GB 内存,8K 上下文下比上代 LFM2-1.2B 快约 25%。
- 训练:预训练 22T token + 3.5T token 中训练(以 agent 轨迹为主),上下文扩至 256K。
- 自报成绩(29 项平均 49.37 vs Qwen3.5-9B 47.24):WebArena-Verified 38.42 vs 28.94、AutomationBench 41.29 vs 15.10、BFCL V4 71.39 vs 62.83;但 SWE-bench Verified 43.40 vs 51.20、GPQA Diamond 63.37 vs 80.40、RULER 128K 65.56 vs 87.11 明显落后。HLE 无工具 7.17 → 有工具 13.90。LFM3-VL-2B 在 62 项视觉基准平均 71.4(Gemma 4 12B 71.7、GPT-5.6 Luna 73.4)。
- 许可:LFM Open License v1.0,商用仅限年收入 < $10M 的组织——这是本期最值得注意的一条限制。
- 生态:launch partners 覆盖 Ambarella / AMD / Arm / Intel(经 OpenVINO)/ NVIDIA / OpenRouter / Qualcomm / Vercel;Mercedes-Benz 与 Shopify 参与预发布测试;llama.cpp、Ollama、MLX day-0 支持(llama.cpp 已在 b11938–b11945 落地五个 LFM3 变体)。
为什么值得关注:1 GB 内存 + 256K 上下文 + 原生 agent 训练,把「端侧能跑」的门槛又压低一档;但它在通用知识与长上下文检索上明显让位于 9B 级对手,说明这一代端侧模型的定位是执行器而非知识库。真正的商业约束在许可:$10M 年收入线把绝大多数成规模公司挡在商用门外,端侧模型的「开放」正在变成分层授权。
来源:Liquid AI 官方博客 · https://www.liquid.ai/blog/lfm3 · 2026-10-27;llama.cpp b11938 / b11941 / b11945 · https://github.com/ggml-org/llama.cpp/releases · 2026-10-27
2. 蚂蚁百灵 Ling-3.1-flash-1019:560B 总参 / 25B 激活、1M 上下文、MIT 许可
10-27 13:46(北京时间)inclusionAI/Ling-3.1-flash-1019 上线 Hugging Face,54 个 safetensors 分片,MIT 许可。
- 规格:560B 总参 / 25B 激活,1M token 上下文。架构为 63 层 KDA(Kimi Delta Attention 线性注意力)+ 9 层门控 MLA 的混合线性 MoE,512 个路由专家、每 token 激活 8 个。
- 定价:$0.30 / $0.90 每百万 token(输入 / 输出)。
- 部署:参考配置 8×H200 或 4×GB300,SGLang / vLLM 均支持。
- 自报(模型卡,无独立复现):Artificial Analysis 智能指数 41 → 44,AutomationBench-AA 62% → 68%。
- 配套:同期放出可继续预训练的 Ling-3.1-flash-base 基座——这一点比分数更重要,意味着 MIT 覆盖到「拿去做自己的模型」而不只是「拿去推理」。
为什么值得关注:560B 参数 + MIT + 1M 上下文,是目前开放权重里「能力上限」与「许可宽松度」同时拉满的少数组合。与 LFM3 的 $10M 收入线并置看,同一天两个中国/美国团队给出了完全相反的开放策略(详见趋势三)。注意 AA 记发布日期为 10-22 而 HF 仓库创建于 10-27,两者差异未获解释。
来源:Hugging Face 模型卡(inclusionAI)· https://huggingface.co/inclusionAI/Ling-3.1-flash-1019 · 2026-10-27;Ant Ling 官方帖 · https://x.com/AntLing_ai · 2026-10-27
3. Google DeepMind Genie 4:首个原生实时生成音频的世界模型,官方博客零量化指标
DeepMind 10-27 发布 Genie 4,定位「新一代世界模拟」。核心变化是原生实时生成音频(此前世界模型只生成画面)。
- 架构分工:Gemini 3.8 Flash 作为 in-the-loop guiding agent——观察场景、拆解目标、回看帧验证每一步、即时调整计划;Gemini Omni 锚定外观一致性;Gemini 4 Argon 配合执行(现场演示 Apptronik Apollo 下跳棋)。
- 交互:键盘控制 + 文本指令改天气 / 加人物 / 挪镜头。
- 合规:全部生成视频与音频带 SynthID 水印。
- 可用性:research preview,仅 trusted testers;后续进入 Google AI Ultra(Project Genie)与 Gemini API / AI Studio early access。
- 官方自述局限:视觉细节与物体恒常性漂移、复杂物理交互、实时音频准确性、可读文字渲染、空间准确性、长期一致性。
为什么值得关注:官方博客全文没有任何量化指标——没有分辨率、帧率、会话时长、一致性时长数字。这在世界模型赛道是反常的(Genie 3 发布时给了 720p/24fps/分钟级)。结合「research preview 仅 trusted testers」,合理判断是这一代在音频实时性上做了取舍,画面一致性可能未达可公布水平。战略上 DeepMind 明确把自己定位为 hybrid world models(生成式 + 物理引擎混合),而非纯生成路线。
来源:Google DeepMind 官方博客 · https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/ · 2026-10-27
4. Apple Creator Studio:办公三件套接入 AI 助手并支持 MCP,Keynote 新增开放格式 .keyx
Apple 10-27 宣布 Creator Studio 更新,11 月免费推送。
- 办公三件套:Keynote / Pages / Numbers 加入智能助手(Apple 自研模型 + OpenAI 模型),分别对应「设计 / 动画 / 精修幻灯片」「起草 / 重构文本」「计算 / 可视化 / 推荐图表 / 建表」。
- MCP 支持(需 macOS 27+):外部 AI agent 可读取文档内容、编辑、执行自动化——这是 Apple 第一次把自家生产力套件开放给第三方 agent。
- 格式:Keynote 新增
.keyx(JSON 开放格式)。 - 创意工具:Pixelmator Pro 加 Generate Fill;Logic Pro 加智能助手(beta)+ 增强 Stem Splitter(可分离鼓件)+ 重设计 Browser;Final Cut Pro 内置 MotionVFX(数千元素)+ 23 种新转录语言;无边记加文本样式 / 背景色 / Pixelmator Pro 编辑(12 月)。
- 定价:新订阅 ¥38/月 或 ¥380/年,美式英语先行。
为什么值得关注:MCP 支持是这条的真正分量——它把 Keynote / Pages / Numbers 变成 agent 可操作的对象,而不是又一个「AI 帮我写文案」按钮。.keyx 用 JSON 开放格式,说明 Apple 在为「程序化生成演示文稿」铺路。但官方未说明 MCP 访问是否需要订阅,这是采购决策的关键缺口。
来源:Apple Newsroom(中国)· https://www.apple.com.cn/newsroom/2026/10/apple-creator-studio-adds-powerful-new-ai-features-and-even-more-creative-tools/ · 2026-10-27
5. 蚂蚁灵光 2.0:从「任务执行者」到「事务管理者」,靠独立云主机做长程任务
蚂蚁集团 10-27 发布 灵光 2.0,称其为灵光 App(2025-11-18 上线,6 天下载破 200 万)上线以来最大升级。
- 能力变化:AI 介入任务的起点前移——过去用户先发现问题再下指令,现在获授权后灵光可主动识别潜在需求并发起分析、监测、跟进,在关键节点提醒。
- 技术支撑:跨会话记忆 + 长程任务调度 + 工具连接三项升级;依托独立云主机,用户退出对话后任务继续运行,并随信息与状态变化动态跟进。
- 场景:机票订完 24 小时盯价;授权支付宝后扫描被遗忘的自动续费订阅;盯钉钉班级群整理老师通知并提取待办;宠物照护、儿童疫苗、纪念日、车辆年检等长期跟进。
- 接入范围:支付宝账单 / 会员 / 出行 + 钉钉 / 飞书 / 邮箱 / 米家;开放环境支持 MCP 与 CLI 调用。
- 安全:接入蚂蚁 APASS(跨智能体、跨设备、跨应用的统一账号与安全管理基础设施),身份认证、意图安全、隐私保护纳入执行流程;授权密钥与智能体分离托管,智能体不直接接触密钥;用户可随时查看、调整、撤销授权。
为什么值得关注:「关掉 App 任务还在跑」是产品形态的分水岭——它把 AI 助手从「会话」变成「常驻进程」,代价是必须有云主机与调度层。科技日报在报道里直接点出了随之而来的问题:跨应用协同下如何避免授权信息泄露、如何确保操作符合用户意图。APASS 的「密钥与智能体分离托管」是目前国内厂商给出的较完整答案,但尚无第三方审计。
来源:科技日报 · https://www.stdaily.com/web/gdxw/2026-10/27/content_603557.html · 2026-10-27;中证网 · https://www.cs.com.cn/ssgs/cj2020/2026/10/27/detail_2026102710047464.html · 2026-10-27;中国证券网 · https://www.cnstock.com/commonDetail/812556 · 2026-10-27
6. 智元 Genie Master:Physical RSI 首次在真实便利店业务验证,11-02 开 24 小时直播「转正考核」
智元机器人 10-27 发布具身 Agent 框架 Genie Master,称其为行业首次在真实业务场景验证 Physical RSI(具身递归自进化)。
- 支撑协议:EEP 具身执行协议,统一四类接口——可调用能力、引导执行、结果达标、未完成任务。任务中断时保留进展并从断点重规划;多机协作时追踪集群分工。
- 已落地场景:精灵 G2 在上海便利店做熟食打包、取货、补货。遇到自定位问题(如头部相机分辨率不足 + 标签遮挡)会自行改用腕部相机补近距离视角。
- 考核安排:11-02 06:00 起,6 台精灵 G2 开启 24 小时不间断直播(首日 10:00 → 次日 10:00),分午高峰、晚高峰、深夜独立值守、清晨早餐四个班次。
- 同期发布:安规级重载 精灵 G2 Max(拆码垛 / 物料转运 / 产线供料);启元第 5,000 台机器人下线。
为什么值得关注:「Physical RSI」这个词此前只出现在论文里,这次被拿到便利店做公开直播考核——无论结果如何,把评测从实验室搬到有客流、有 SKU 变动、有设备故障的真实门店,本身就是对「具身 agent 能不能值班」的一次硬约束测试。注意效果数据均为厂商口径,无独立复现。
来源:南方新闻网 · https://www.nfnews.com/content/n614Jlzk3P.html · 2026-10-27
7. Firefox Smart Window:AI 填表背后是 Google Gemini 3.1 Flash Lite,网页监控用 Qwen
Mozilla 10-27 在 Firefox 上线 Smart Window(Beta,仅美国 / 加拿大英语桌面版)。
- AI 填表:需页面有 ≥4 个文本字段才触发;从已打开标签页提取上下文自动填写;数据共享给 Google Gemini 3.1 Flash Lite。目前仅支持文本字段,下拉框与 PDF 表单在开发中。
- 网页监控:
/watch功能由 Qwen 识别页面变化,可设每日 / 每周检查;每任务最多 5 页、最多 15 个任务;60 天无变化自动暂停、90 天停止。
为什么值得关注:浏览器厂商的 AI 功能开始分流到不同第三方模型——填表用 Google、监控用阿里。这既说明浏览器自研模型的成本不划算,也意味着用户的表单内容会流向两个不同的模型供应商。Mozilla 一向以隐私立场著称,这次在功能说明里直接写明数据共享对象,算是把选择权交回用户;但对「Firefox 用户」这个群体的预期管理仍是个考验。
来源:The Verge · https://www.theverge.com/ai-artificial-intelligence/1019551/firefox-smart-window-ai-fill-forms · 2026-10-27
二、工程与架构
1. Cloudflare 公开 GLM-5.3 跨请求 KV 缓存暴露:155 条响应含他人数据,根因是「池小于上下文」叠加 SGLang 状态判断失效
Cloudflare 10-26 发布协调披露报告,承认 Workers AI 上的 GLM-5.3 存在跨请求 KV 缓存暴露。
- 影响面:155 条响应含其他用户数据,全部来自 > 681,280 token 的 prompt;影响期 8-27(模型上线)→ 9-9,约 13 天。Cloudflare 排除自身测试与研究人员测试流量后,判断这些请求在时间与数量上与正常超长上下文使用一致,未发现蓄意利用证据。
- 时间线:9-8 23:11 UTC,Knostic 的 Gadi Evron 经 HackerOne 提交(附可复现脚本);9-9 14:00 UTC 模型转私有(返回 HTTP 400);9-9 19:40 UTC 修复后恢复公开。
- 根因一(配置):模型声明上下文 1,048,576 token,但 prefill GPU 上的 KV 池实际只有 681,280 token(约 65%)。该池大小不是配置项,而是 SGLang 启动时按加载权重后剩余显存自动测算得出,与声明的上下文长度无强制一致性校验。团队事前已知不匹配,但误判为「引擎会对超长 prompt 返回错误」——因为长上下文测试确实返回了成功的 HTTP 状态码。
- 根因二(引擎):SGLang 分离式 prefill/decode 下,超长请求被标为 rejected 并替换为 one-token placeholder,但请求未中止;拒绝状态记在
to_finish而非finished_reason,finished()仍返回 False,于是请求通过了 prefill 与 decode 两侧的准入队列。prefill 只写了一页 KV 就通知「传输完成」,decode 却按原长度(如 8 页)预留并读取,其中 7 页仍是此前其他请求的残留。 - 为什么没被发现:返回的是 HTTP 200 而非 400,
prompt_tokens与长 prompt 相符,回复语义连贯、速度异常快。上线前只验证了 HTTP 响应码与引擎性能,未验证模型输出的内容与连贯性。 - 上游历史:SGLang issue #30233 于 7-6 已报告;Cloudflare 自 v0.5.10 起持续标记。
- 修复:池扩至约 2.04M token(约上下文的 2 倍)+ 引擎补丁(Cloudflare 提交 #38704;SGLang main #36988 于 9-6 合并、#38935)。官方建议所有运维方升级 SGLang v0.5.22+。
- 其他加固(9-11~9-19):双角色延迟释放(#38961 → #40645 / #41402 / #41404)、Mooncake 传输批次限界(#32758)、负载均衡器改造、部署前强制检查。
- 长期方案:① Integrity by construction——页级 tag,开销 <1%,8 月中在 GLM 5.2 测过但因可靠性停用;过渡方案是
--disaggregation-enable-kv-checksum(#39500)② Integrity by mathematical impossibility——借 Topaz / Meerkat 的形式化验证经验,对 RDMA + Mooncake 建模。
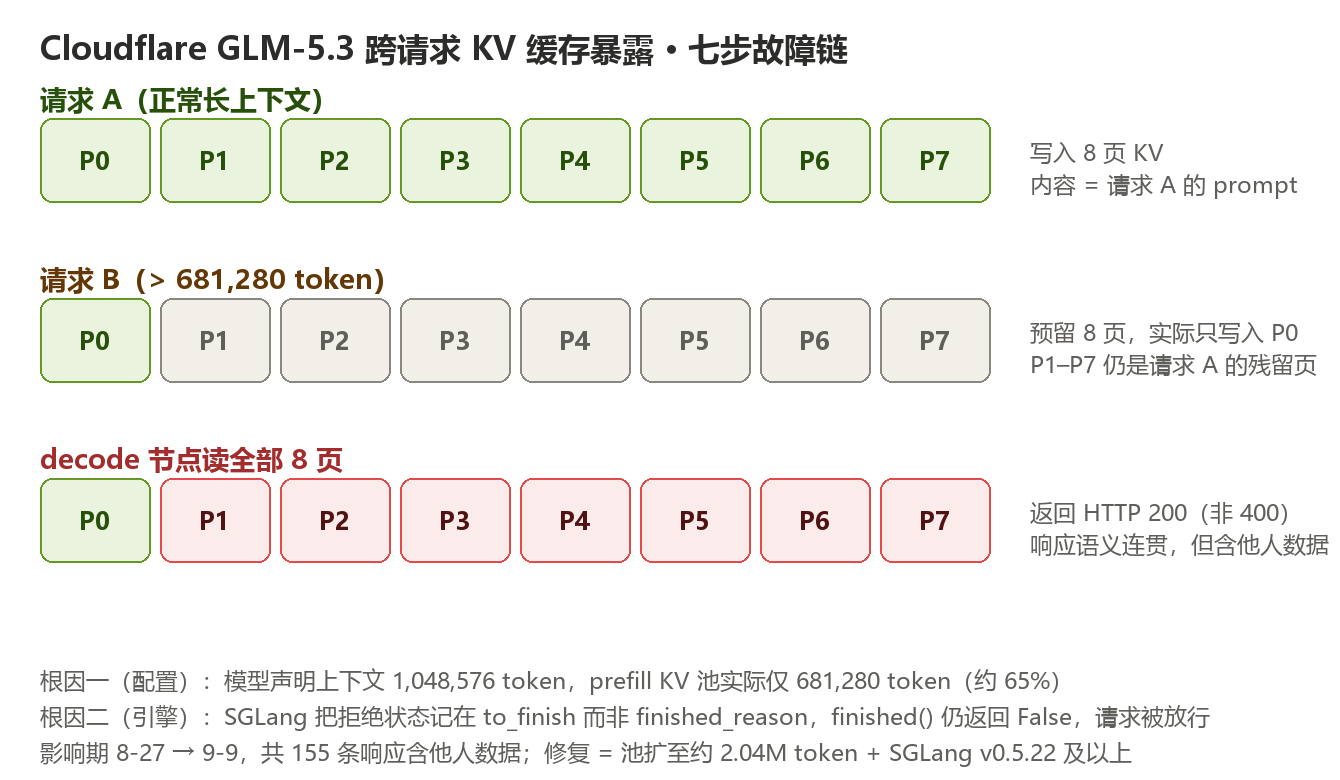
为什么值得关注:这是一份罕见的、把「配置错误 + 框架 bug + 测试盲点」三层叠加讲透的公开复盘。三个可迁移的教训:(1)声明的能力上限与实际资源上限必须做启动期硬校验,靠「引擎应该会报错」是赌博;(2)分离式推理的「传输完成」信号必须携带页数,否则接收端只能假设;(3)上线验证必须包含输出内容检查,只测状态码与吞吐等于不测。第三条对所有自建推理服务的团队都成立。
来源:Cloudflare 官方博客 · https://blog.cloudflare.com/kv-cache-exposure-remediation/ · 2026-10-26;SGLang PR #36988 · https://github.com/sgl-project/sglang/pull/36988 · 2026-09-06
2. Warp 供应链泄露:第三方 vendor 被攻陷,agent 决策日志与遥测外泄,上限约 1% 用户
Warp CEO Zach Lloyd 10-26 在 X 发帖披露:10-23(周五)发现「Warp 基础设施中一个 vendor 正被主动且窄带地利用」,数小时内检测并缓解。
- 泄露内容:agent 决策日志(agent trace)与遥测数据。Warp 未说明是否含源码、提示词、文件路径或凭据。
- 影响面:Lloyd 称「上限约 1% 的 Warp 用户可能受影响」;Warp 官网称有 80 万+ 用户。已通知所有「被正面确认受影响」的用户。
- 攻击描述:Lloyd 称攻击「看起来来自一个 agent swarm,使用了非常复杂的渗透与提权技术,可能始于 vendor 依赖中的一个漏洞」。
- 处置:已联系该 vendor;聘 CrowdStrike 做完整调查;已通报执法部门。未点名 vendor、未公布漏洞、未发布 IOC。
- 背景:上周 AI 编码平台 OpenCode 通知用户存储的 API key 泄露,影响约 1.4% 用户,部分账户被未授权扣费至 $1,700。
为什么值得关注:「appears」「likely」这两个词很重要——agent swarm 攻击目前只是 Warp 的初步判断,无第三方确认,CrowdStrike 的结论才是关键。但即便 swarm 说法不成立,这条也成立:agent trace 不是无害的使用统计,它是「agent 在你的项目里读了什么、跑了什么、决定了什么」的逐步日记,编码 agent 日常会碰配置文件和终端输出,trace 里很容易带上没人打算存储的东西。两周内两个 AI 开发工具被攻破,说明这类产品的攻击面已经从「代码」扩展到「开发者行为数据」。
来源:BleepingComputer · https://www.bleepingcomputer.com/news/security/warp-discloses-breach-exposing-ai-agent-logs-user-telemetry-data/ · 2026-10-27;Zach Lloyd 原帖(经 TSNMedia 转述细节)· https://tsnmedia.org/warp-vendor-breach-agent-telemetry · 2026-10-26
3. TrendAI:CyberStrikeAI 用 44 个 AI agent 全自主打穿日本至少 16 家组织
TrendAI 10-27 发布报告,记录三套暴露的服务器环境,其中 Case A 是全自主攻击。
- Case A(全自主):CyberStrikeAI 的 44 个 agent 覆盖侦察 → 漏洞发现与验证 → 利用 → C2 → 持久化 → 外传 → 自动报告全链条,可生成日语表单与假登录页。至少 19 家可识别组织,其中至少 16 家在日本;每家都产出同格式报告与证据索引,说明是平台结构化流程的输出。操作者还针对台湾地区与香港地区。
- Case B(人主导 + LLM 辅助):8-9 月约 24 天,目标为 AI 工作流平台与推理服务,动机是低成本获取大量推理算力。一起入侵针对默认凭据暴露的 GIS 服务器,窃取地籍与商业记录、Windows 凭据、邮件数据。
- Case C(AI 仅做脚本工具):针对 Cisco / Citrix / F5 / Yamaha 边缘设备,用已公开漏洞、管理功能、配置文件中的凭据;估计 1-10 月至少 6 轮 campaign。WebLogic 发现列表含英、法、意、卡塔尔、哥伦比亚。
- 归因:无证据表明三案为同一操作者。
- TrendAI 结论:「AI 增加了攻击者的人力,但工作仍然是找没锁的门……变化的是能一次试几千个、适应目标国语言、且不疲劳。」
- 交叉参照:微软 2026 DDR 报告称 AI 把「漏洞发现到武器化」的中位时间压到 24 小时以下。
为什么值得关注:这是目前最具体的「agent 规模化攻击」实证——44 个 agent 不是营销数字,而是对应 19 家组织的同格式报告。但报告也诚实地指出 Case C 里 AI 只是脚本工具,真正的门槛仍是「默认凭据」「未打补丁的边缘设备」这些老问题。对防守方的直接含义:当攻击的边际成本趋近于零时,任何「暂时不重要」的暴露面都会在几周内被穷举。
来源:The Hacker News(引 TrendAI 报告)· https://thehackernews.com/2026/10/cyberstrikeai-uses-44-ai-agents-to.html · 2026-10-27
4. Cursor 上线 DeepSeek V4.1 Flash 并发布 Agent SDK:CursorBench 47.7% 只要 $0.98/任务
Cursor 10-26 起在 Settings > Models 中开放 DeepSeek V4.1 Flash(无需 BYOK),同时发布 Agent SDK。
- CursorBench 4.0 四档:Max 47.7%($0.98/任务)、Medium 46.3%($0.80)、High 45.6%($0.77)、Low 44.9%($0.60)。Max 档排第 17。
- 对标:接近 Sonnet 5.5 High(47.8%,$1.20)但便宜约 18%;Opus 5.5 Max 57.8% 但 $13.43/任务(约 13.7 倍)。
- 代价:token 与步数显著更高——Max 约 537K token / 187 步,Sonnet 5.5 High 约 37K / 41 步。
- Agent SDK:用 Markdown 写提示词 + TypeScript 定义工具,支持托管或自建部署,内置 evals,与 Bugbot / Security Review / Rollouts 共用同一 harness。
为什么值得关注:$0.98 vs $13.43 的对比说明「便宜模型 + 更多步数」在某些任务上已经能逼近旗舰,但 537K vs 37K 的 token 消耗意味着延迟与上下文管理成本被转移到别处。Agent SDK 的意义在于 Cursor 把内部 harness 商品化——它不再只是编辑器,而是想成为 agent 的运行时。
来源:AI Coder(引 Cursor 官方 changelog)· https://aicoder.com/news/news-20261026-cursor-deepseek-v4-1-flash-cursorbench-cost-frontier · 2026-10-26
5. 版本更新速览:六个项目在同一窗口发版,两条修复值得单独看
| 项目 | 版本 / 批次 | 时间(UTC) | 关键变更 |
|---|---|---|---|
| Claude Code | v2.1.312 | 10-27 20:24 | 新增 oidc.user_id_claim(支持 Microsoft Entra ID 的 oid);全屏下点击队列消息下方提示可立即发送;修复「Claude 只看到超大 CLAUDE.md / rules / @-include 文件开头就覆盖它」——Write 现在要求读全或就地编辑;修复 Bash cd 进 git 仓库深处后 per-directory 与 paths: skills 找不到;修复无效命令名致所有命令无法加载(可能让 claude -p 无输出) |
| Codex CLI | rust-v0.165.0 | 10-27 20:09 | 新增内置 Google Cloud Vertex AI provider(model_provider = "gcp");模型目录加 GPT-6.1 Terra;默认开启对话中 reasoning effort 调整;memory v2 对新 profile 默认开启并支持导入外部 agent 记忆;修复远程 MCP 工具请求随本地 future 丢弃而取消、provider 报模型不存在时不再重试 |
| transformers | v5.21.0 | 10-26 18:17 | 新增 MiniCPM-OCR(OpenBMB,SigLIP + 窗口注意力 merger + Qwen3.5)、Flint(Recursive 的 MoE:多数层带 RoPE 滑窗注意力、其余层无位置编码全注意力;学习式 attention sinks;sigmoid 路由 6/256 专家 + 无门控共享专家)、UltraVBert、Gradium Phonon TTS |
| llama.cpp | b11936–b11946 | 10-27 20:11 → 10-28 01:58 | b11946 新增 /v1/realtime 实时对话与转录(server,示例客户端默认端口 9931);b11944 server 暴露 chat template 的 reasoning effort levels(minimal/low/medium/high/xhigh/max);b11940 deferred tools 与 tool_reference content parts;b11936 k-pool 稀疏选择独立于 kq_mask 形状 |
| pydantic-ai | v2.62.0 / v2.63.0 | 10-27 02:38 / 10-28 00:55 | v2.62.0 可经 OpenAI configuration_update 与 Anthropic per-message output_config 在对话中改 thinking effort(记为 ModelSettingsDeltaPart);新增三类模型错误;破坏性:SummarizingCompaction 摘要改存为 CompactionPart 而非系统提示词。v2.63.0 CodeMode 默认 dynamic_catalog=True(揭示的工具追加而非重写缓存提示词) |
| browser-use | 0.13.14 | 10-26 22:00 | 加 OpenAI browser tools 与共享 Bash helper;修复缩放显示器下截图 / 裁剪 / 点击坐标错位;改进有界页面观察、表单状态、文件访问、浏览器恢复 |
为什么值得关注:两条修复值得单独拎出来。**Claude Code 的「只读开头就覆盖大文件」**是一个典型的静默数据损坏路径——它不会报错,只会让文件后半段消失,而大 CLAUDE.md 恰恰是最常见的使用方式。browser-use 的缩放显示器坐标错位同理:在 125% / 150% DPI 的 Windows 上,agent 会点错位置但不报错。这两条都属「不修就会长期污染结果」的类型。
来源:Claude Code v2.1.312 · https://github.com/anthropics/claude-code/releases/tag/v2.1.312 · 2026-10-27;Codex CLI rust-v0.165.0 · https://github.com/openai/codex/releases/tag/rust-v0.165.0 · 2026-10-27;transformers v5.21 · https://github.com/huggingface/transformers/releases/tag/v5.21 · 2026-10-26;llama.cpp releases · https://github.com/ggml-org/llama.cpp/releases · 2026-10-28;pydantic-ai releases · https://github.com/pydantic/pydantic-ai/releases · 2026-10-28;browser-use 0.13.14 · https://github.com/browser-use/browser-use/releases/tag/0.13.14 · 2026-10-26
三、行业与发展
1. Anthropic × GSA:全线产品 40% 折扣,覆盖联邦与州地方政府,预计省约 $10 亿
Anthropic 10-27 宣布扩大与 美国总务管理局(GSA) 的合作,经 GSA Multiple Award Schedule 采购,适用联邦 + 州 / 地方 / 部落 / 领地政府。
- 折扣:40%(OneGov discount),覆盖 Claude Enterprise / Claude for Government / Claude API——首次覆盖全部产品线。预计为政府省约 $10 亿。无最低消费承诺。
- 采用规模:约 500 家美国政府组织在用 Claude;Claude for Government 周活跃用户自 2 月增约 8 倍,联邦文职机构用量一年增约 20 倍。
- 合规状态:Claude for Government 已达 FedRAMP High(9-30 GA);Bedrock 与 Vertex AI 亦 FedRAMP High(部分模型 DoD IL4/IL5);Claude Enterprise 仍在申请 FedRAMP Moderate(FedRAMP 20x 流程)。云渠道折扣数月后生效。
- 案例(官方口径):犹他州 10 机构 34 名开发者——80% 在 30 分钟内搭好环境、71% 四周试点后报省 20+ 小时;某州 CIO 8 分钟响应勒索软件(常规 2-3 天);某联邦安全团队用 Claude Mythos 约两天检测修补关键漏洞(一个月前人工渗透未发现);某州 IT 开发者两天迁移近 900 个 API 方法(原排期一个月);某州 IT 主管为 12 个遗留仓库写文档、梳理 467 张表并标记 27 项风险。
为什么值得关注:40% 折扣 + 无最低消费承诺,是政府采购里少见的条款组合——它把「试用成本」压到接近零,赌的是用起来之后不会换。真正的信号是 Claude Enterprise 还在申请 FedRAMP Moderate:说明 Anthropic 认为商业客户与政府客户会用同一套产品线,而不是维持两套。
来源:Anthropic 官方公告 · https://www.anthropic.com/news/expanding-partnership-gsa · 2026-10-27
2. Anthropic 药物开发早期进展:六家合作方 + 收购一人公司 Mithril Medicine
Anthropic 10-27 发布生命科学合作进展报告。
- Generate Biomedicines:6 名科学家用 Claude Code 改造 CAR-T 治实体瘤,一个设计比标准版约短 70%,实验室测试使免疫细胞产生约 10 倍受体。
- Divergence Labs(食物过敏):Claude 基本自主在约一个月内生成约 35,000 个抗体设计;3 个可结合 IgE、20 个可剥离 IgE,其中 3 个剥离效果优于标准药物。
- BigHat Biosciences:Claude 接入实验室数据系统 Reccy,约 10 周内制造测试约 1,010 个变体;最佳版本结合力提升超 10 倍、靶向癌症先导物稳定性提高 18°C、长效药物先导物聚集速度慢 100 倍以上。
- Enveda:生产化学家最多 75% 时间花在文书;测试 1,061 页文档,Claude 找出人工发现的全 11 个问题并额外标记 7 个人工遗漏;人工审核时间减 89%(>25 小时 → <3 小时);两份监管文件初稿一份耗时 4 小时(人工约 3 个月)。
- The Column Group:筹建新公司 Pleiades,首个 skill 已在 45 个靶点-疾病配对上评估。
- BMS:临床试验规划,2027 扩大合作,无具体数字。
- 收购 Mithril Medicine:一人公司,创始人 Cody Tranbarger,两种罕见儿童型肌营养不良;Claude 组织合同 / 物流 / 协调 11 家外部实验室,从想法到小鼠有希望结果不到 18 个月,最早 2028 年底进人体临床。
- 配套:Life Sciences Verification Program(受信任组织用最强模型 + 更宽松安全防护)、Claude Science、生命科学家 Claude 额度、客座研究员开放征集。
为什么值得关注:原文明确限定「绝大部分仍是临床前,尚未进入人体试验」——这句话必须保留。真正可迁移的不是那些倍数,而是 Enveda 的文书场景:1,061 页文档、找出人工遗漏的 7 个问题、审核时间降 89%,这是任何受监管行业都能复用的模式。收购一人公司 Mithril 则是另一种信号:Anthropic 开始用并购获取「agent 跑通的科研流程」,而不只是卖 token。
来源:Anthropic Research · https://www.anthropic.com/research/early-progress-drug-development · 2026-10-27
3. 更新(首报 10-27):NVIDIA 认购 Meta $3B、AMD 认购 $1B 落定
上期报道 Meta 启动至多 $95B 股权融资、三家芯片厂「有意」认购至多 $5B。本期增量:
- NVIDIA $3B(按 $625 发行价约 480 万股)、AMD $1B,合计 $4B 已落定,属 Meta 至多 $95B 股权融资的一部分。
- 对价:Meta 将扩大 Vera Rubin / Spectrum-X 以太网 / BlueField-4 部署、加深 Muse 合作、探索 OpenShell 参考架构的智能体安全与 Sentry 全链路行为监控;AMD Helios 机架级系统已在 Meta 完成安装测试、EPYC 驱动 Muse、2 月框架最高覆盖 6 吉瓦 AMD 算力。
- 发行细节:A 类普通股发行从 $22.5B 上调至 $25B、定价 $625/股(较收盘价折让约 1%),加 $12.5B 票面 6.5% 强制可转换优先股(2029-08 转股);普通股认购需求约 5 倍超额。
- 后续:2027 年 1 月拟经 ATM 再筹最多 $600 亿无投票权 C 类股,总规模或达 $975 亿(超 Alphabet 6 月 $850 亿纪录)。
为什么值得关注:从「有意」到「落定」只隔一天,说明这不是姿态。芯片厂直接持有客户股权,把供应商-客户关系变成共同投资者关系——这意味着未来采购谈判里,「买多少」和「股价多少」会被放在同一张桌子上算。
来源:CNBC · https://www.cnbc.com/2026/10/27/nvidia-invest-meta.html · 2026-10-27
4. Oracle × OpenAI:四款企业 offerings 同台,含免费起步的 SMB 套餐
Oracle 10-27 在 AI World 发布与 OpenAI 合作的四款 offerings。
- Oracle AI Workspace(coming soon):ChatGPT 插件,连接 Fusion Applications / NetSuite / Oracle AI Database / OCI;员工描述业务目标后由插件汇集工具与信息,保留治理、审批与控制。
- Oracle AI Security Mesh:托管服务,用 OpenAI cyber 模型在 OCI / 其他云 / 本地找并修漏洞;客户定义授权测试范围,Oracle 管理护栏。
- Oracle App Composer:用 Codex 建企业应用,Oracle 在 OCI 管理部署与运维(含 OKE 与 Autonomous AI Database),支持 APEXlang。
- Oracle AI SMB Bundle:免费起步,每年 $12,000 OCI 额度 + ChatGPT Business + AI Workspace + Codex + App Composer + OCI + NetSuite QuickStart;合格团队成员装 NetSuite QuickStart 插件并在 7 天内使用可获一次性 $50 额度(最多 5 人/工作区,$250)。
- 背景:OpenAI 五年向 Oracle 采购约 $3,000 亿算力(约 4.5 GW,2027 起);Oracle 亦在 OCI 上提供 Google TPU(2027 起)、Cerebras(2027)、SambaNova(路透)。OCI Superclusters 扩至多吉瓦级 Vera Rubin NVL72 + Vera CPU,配 Acceleron 网络 + Spectrum-X 以太网 + BlueField-4 DPU。Oracle 股价当日涨 5%。
为什么值得关注:这是「云厂商把模型厂商的产品重新包装成企业软件」的完整样本——Oracle 卖的不是 API,是带治理、审批、部署、运维的整套东西。SMB Bundle 的 $12,000 额度 + $50 注册奖励是典型的 PLG 打法,用在企业软件渠道上说明 Oracle 认为中小客户值得用补贴换。
来源:Oracle 官方新闻稿 · https://www.oracle.com/news/announcement/ai-world-oracle-reinvents-enterprise-computing-for-the-ai-era-with-openai-2026-10-27/ · 2026-10-27
5. Replit Cloud Agents:非工程人员用自然语言提需求,agent 在云端沙箱测完直接开 PR
Replit 10-27 向所有 Pro 与 Enterprise 客户开放 Cloud Agents。
- 流程:非工程人员用自然语言描述改动 → agent 找相关代码 → 在云端沙箱测试 → 在 GitHub 开 PR / GitLab 开 MR(遵循团队 skills 与贡献指南)→ 附截图与视频。
- 验证方式:agent 在浏览器里像客户一样点击验证,失败则修码重测。
- 学习回路:review 反馈转为 skills 更新(early access,工程师批准后生效)。
- 共享环境:管理员配一次(含仓库 / 运行时 / skills / 工具 / 依赖),自动从 main 更新;凭据经 credential broker 从外部 secrets manager 取。
- 入口:Slack
@Replit与移动端,Teams 即将支持。 - 内部数据(自报):workspace memory 使 token 用量降 51%、常见数据任务从 16 分钟降至 1 分钟。
- CEO Amjad Masad 的 Self-Driving Company 宣言:2030 年 Fortune 500 全部成为 Self-Driving Company;H1 2026 工程师代码产出近三倍而 review 时间 / 回滚 / 事故持平;$9B 估值、$400M 融资、5,000 万+ 用户、85% Fortune 500 用户、目标 2026 年底 $1B run-rate。
为什么值得关注:把「非工程人员提需求」和「agent 必须像客户一样点击验证」绑在一起,是这条最实的设计——它绕开了「agent 说改好了但没验证」这个最常见的失败模式。但「review 反馈自动转 skills」需要工程师批准才生效,说明 Replit 自己也不认为这条回路可以完全自动。
来源:Replit 官方博客 · https://replit.com/blog/anyone-can-bring-ideas-to-company-codebase · 2026-10-27
6. Agent 身份与凭据成为独立产品线:IBM Vault 2.2 + 1Password for Agents
IBM(10-27,TechXchange):Agent Identity 给每个 agent 记录所有者、状态、权限;HashiCorp Vault 2.2 加安全 agent 账户与凭据控制,两者 GA。Vault 可发短时凭据、agent 越权时实时拒绝并撤销会话、自动续期 agent 凭据、含后量子加密。watsonx Orchestrate 的 agent discovery(tech preview,连 Amazon Bedrock / Microsoft Foundry / Google Gemini 找 agent,也覆盖模型与 MCP server)与 containment(tech preview,沙箱运行 + 关停);evaluation GA(测试 / 监控 / 追踪每 agent 模型与 token 用量);Secure Hub(public preview)、IBM Integration Intelligence Hub(tech preview)。
1Password(10-22 发布,本期传播):1Password for Agents 让 AI agent 代登录而不接触明文凭据——agent 发登录请求 → 向 1Password 提交身份密钥 → 系统向用户推送提醒 → 用户确认后 1Password 自动填充。免费且可选(个人与家庭账户),集成 Claude、Grok 等。
为什么值得关注:两家在同一个窗口把「agent 的身份」当成独立产品来做,说明共识已经形成:agent 不是「用户的会话」,而是「需要独立账号、独立权限、独立审计的主体」。Vault 的「越权时实时撤销会话」和 1Password 的「用户确认后自动填充」是两种不同的信任模型——前者靠策略,后者靠人在环。注意 1Password 实际发布于 10-22,早于本期窗口,此处按「本期进入中文视野」记录。
来源:IBM TechXchange(经 SiliconANGLE 转述)· https://siliconangle.com/2026/10/27/ibm-agent-identity-hashicorp-vault-2-2/ · 2026-10-27;1Password 官方博客 · https://blog.1password.com/1password-for-agents/ · 2026-10-22
7. 英国 Home Office 用生成式 AI 处理庇护申请,监管机构考虑调查
WIRED 与 Guardian 10-27 报道:英国**独立首席检查官(ICIBI)**正考虑调查内政部(Home Office)用生成式 AI 处理庇护申请。
- 工具:ACS(Asylum Case Summarisation) 与 APS(Asylum Policy Search),基于 OpenAI 2023 年 GPT-4 + Microsoft Foundry,2024 年底试点。
- 调查发现:ORG(Open Rights Group)六个月调查显示,ACS 摘要「不可用」比例显著高于官方公布的 9% 错误率;APS 无质量控制。
- 司法先例:7 月英国法官指内政部引用「AI 幻觉」文件拒庇护。
- 各方表态:内政部称 AI 仅辅助、不做决定;OpenAI 称 GPT-4 将于 1 月退役。
为什么值得关注:这是「AI 进入高风险公共决策」的典型样本,且三个环节都出了问题:摘要质量低于公布值、检索无质量控制、决策被法官抓到引用幻觉。OpenAI 宣布 GPT-4 明年 1 月退役,意味着这套仍在试点中的系统必须迁移——迁移期的可复现性由谁负责,报道里没有答案。
来源:WIRED · https://www.wired.com/story/uk-home-office-ai-asylum-decisions/ · 2026-10-27;The Guardian · https://www.theguardian.com/uk-news/2026/oct/27/home-office-ai-asylum-claims-watchdog · 2026-10-27
8. 融资速览:Disruptive 募 $10B 盲池,趋境科技 B 轮超 13 亿元
- Disruptive(10-27,Bloomberg):达拉斯基金募集 $10B,投至少 10 家后期 AI / 国防 / 软件公司,单笔最多 $10 亿;首支盲池基金;德州史上最大 VC 基金。
- 趋境科技(10-27):AI Token 生产服务商完成 B 轮超 13 亿元,年内累计募资 24 亿元;浙财创新 / 萧山资本 / 工银投资 / 中关村科学城 / 星连资本 / 钱江世纪城领投,商汤 / 网宿等跟投;收入接近去年全年 10 倍;日均 Token 产量半年增长超百倍达万亿量级。
为什么值得关注:两条放在一起看很有意思——美国出现单支 $10B 的后期盲池,中国出现「卖 token」的公司半年产量涨百倍。前者赌的是「后期公司还需要大额非公开资本」,后者说明推理算力的转售已经形成规模市场。
来源:Bloomberg · https://www.bloomberg.com/news/articles/2026-10-27/disruptive-raises-10-billion-fund-for-late-stage-ai-bets · 2026-10-27;智通财经 · https://www.zhitongcaijing.com/content/detail/1513286.html · 2026-10-27
四、论文与开源
口径说明:本节 arXiv 条目对应 10-25/10-26 提交批次(2610.345xx–2610.376xx),于 10-27 20:00 ET(= 10-28 08:00 HKT)公告,落在本期窗口内。所有论文均为预印本,未经同行评审。
1. Anthropic 递交《A 2^o(n) Time Algorithm for 3-SAT》反驳 ETH:署名 Claude,Lean 4 形式化,但「参与不等于认证」
Anthropic 10-27 在 anthropics/formal-math 仓库的 eth 目录发布 《A 2^o(n) Time Algorithm for 3-SAT》,作者署名 Claude, Anthropic。
- 内容:给出 3-SAT 的亚指数时间算法,直接反驳指数时间假设(ETH)。Lean 4 形式化,pin Lean / Mathlib v4.33.1,CI 用第二套独立内核 nanoda 复核。
- 过程:Levent Alpöge 称 Anthropic 内部 Claude 研究模型于 10-16 用 14M 输出 token、无人类输入找到核心算法。
- 性质:结果纯渐近,不涉及实际求解器性能。
- 关键限定:README 自述「证明是机器校验的,但
MainResults.lean是否与论文陈述一致,需要人类读者判断」。 - 时序:紧接 OpenAI 10-26 三项科学声明(其中 ETH 被反驳);Alpöge 先质疑 OpenAI 依赖既有工作,数小时后 Anthropic 发布自己的反驳。Impagliazzo / Paturi / Williams 工作组公开信称「参与不等于认证」并组织审阅。WebProNews 报道两家均称各自模型在 10-16 发现结果。
- 状态:无外部组织确认。
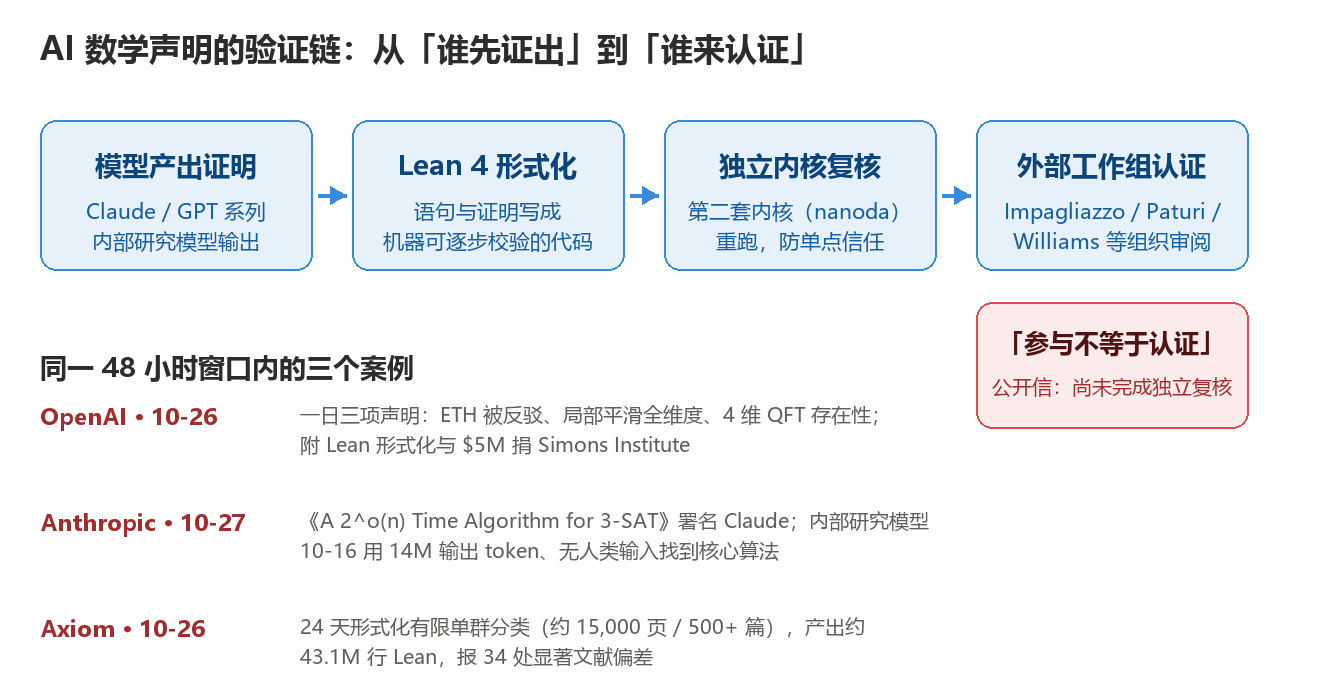
为什么值得关注:两家在 48 小时内各自声称同一件事(ETH 被反驳),且都称发现日期是 10-16——这个巧合本身值得注意。更关键的是验证链的第四环是空的:模型产出 → Lean 形式化 → 独立内核复核 → 外部工作组认证。前三环已经工程化(Lean + nanoda 可以自动化跑),第四环仍靠人手,而工作组的公开信明确说「参与不应被视为认证」。AI 做数学的瓶颈已经从「能不能证」变成「社区能不能及时验」。
来源:anthropics/formal-math(eth 目录)· https://github.com/anthropics/formal-math/tree/16a5ce41304fcdaea4e0be7c132e1c361dc26da5/eth · 2026-10-27;TechCrunch · https://techcrunch.com/2026/10/27/frontier-ai-labs-say-their-models-refuted-the-exponential-time-hypothesis-what-does-that-mean/ · 2026-10-27
2. Axiom 用 24 天形式化有限单群分类:约 43.1M 行 Lean,报 34 处显著文献偏差
Axiom 10-26 发布报告:AxiomProver 多 agent 系统用 24 天完成**有限单群分类(Enormous Theorem)**的 Lean 形式化。
- 规模:原定理约 15,000 页 / 500+ 篇论文 / 约 100 位数学家;产出约 43.1M 行 Lean 代码。
- 方法:10-01 开 Slack 频道,基于既有 Lean 工作 + 内部 proof map 拆为 108 个里程碑与约 380 个任务。
- 文献问题:发现并修正多处文献问题,多数为小错(打字、表格、漏假设),但 34 处值得注意的偏差需解决。最重大的一处与 Unbalanced Group Theorem(UGT) 相关——agent 在形式化 John Walter 1986 年 memoir 时发现其证明中一个闭包断言有显式反例(该操作可能产生被排除在指定族之外的群),使关键推理失去依据;但反例未推翻 UGT 目标或 Walter Proposition II.5.9(ii) 的结论。与 Richard Lyons、Ronald Solomon 等原工作者通信后重路由证明并给出新证明。
- 人员:核心贡献者 Dean Cureton、Vasily Ilin、Bhavik Mehta、Niels Voss;外部顾问 Richard Lyons、Dan Nakano、Ron Solomon。
- 基础:构建于 Mathlib 并纳入 Qiuzhen-CFSG 约 120 万行代码;将公开长篇 errata 列表。
为什么值得关注:这条的价值不在「24 天」这个数字,而在它发现了一个 40 年前证明里的显式反例——这是形式化真正能带来的东西:不是更快,而是把「大家都同意」的地方逼到机器可检查。注意「2,000+ 错误」这个流传的数字主要源自二手 X 帖,官方页确认的是 24 天、43.1M 行与 34 处显著偏差。
来源:Axiom 官方研究页 · https://axiommath.ai/research/the-enormous-theorem-formalized/ · 2026-10-26
3. Ai2《Old Ideas, Novel Problems》:LLM 当「新颖性裁判」,prompt 措辞微调让准确率摆动超 50 个百分点
Ai2 10-27 发布 NoveltyBench,测试 LLM 作为「新颖性裁判」的可靠性。
- 数据构造:基于 ICLR 2026 同行评审挖掘(不把录用当新颖性代理,而是挖评审中明确讨论原创性的段落)。154 个高新颖性人类想法(所在领域前 10% 录用论文且评审正面认定新颖、无评审质疑)+ 145 个较低新颖性想法(后 10% 被拒论文且评审提出原创性疑虑、无评审正面认定)。标注者与评审挖掘标签在 47/50 抽查中一致。
- Human+Generated 设置:同样 154 个人类想法与 154 个简单 LLM 生成想法配对;专家审 30 对(偏向最强裁判漏掉的)每次都选人类想法,判断生成想法无一新颖。
- 测六个裁判:GPT-5.1 / 5.2 / 5.4、Claude Sonnet 4.5 / Opus 4.5 / Opus 4.6。
- 核心发现:prompt 措辞微调使准确率摆动超 50 个百分点(GPT-5.4 从 93.5% 降到 40.9%);提示裁判「评审认为一个想法新颖另一个不新颖」会改变超过一半相同想法对的判断,有时准确率低于随机;同一改动对一个裁判有益、对另一个有害;检索与更多推理不能持续改善判断。
- 专用系统反而不如简单 prompt:Idea Novelty Checker 0.642 macro-F1 @ $30.66、Sakana AI Scientist 0.772 @ $82.05,均不如简单 prompt 的 Claude Opus 4.6 基线(0.854 @ $2.59)。GPT-5.6 Sol 用 extra-high reasoning + 限 arXiv 的实时迭代搜索得 0.78(低于 Claude Opus 4.6 的 0.89)且每决策成本约 10 倍。
- 配套:发布基准、数据、代码与自动化流水线。
为什么值得关注:这是对「用 LLM 做评审」最直接的一次打脸——专用系统花 12 倍钱,得分还低 0.2。更值得记住的是「prompt 措辞能让准确率摆动 50 个百分点」:任何声称「我们的 LLM 评审准确率 X%」的说法,如果不公开 prompt 原文,这个数字就没有意义。
来源:Ai2 官方博客 · https://allenai.org/blog/novelty-bench · 2026-10-27
4. Google Research「睡眠」框架:给 LLM 加 consolidation + dreaming 两阶段,BABILong 扩至 10M token
Google Research 10-27 发布 sleep framework,用「睡眠」阶段实现持续学习。
- 阶段一 memory consolidation:用 knowledge seeding + on-policy distillation + semantic reward,把脆弱的短期上下文压缩进稳定的长期参数;理论上是结构化低秩压缩问题;解锁预分配 MoE 容量——低秩专家挂在低频记忆块上避免覆盖旧参数;用 Generalized Knowledge Distillation + RL 模仿,奖励基于语义与 Levenshtein 距离相似度;consolidation 完成后重置高频临时参数。
- 阶段二 dreaming:随机激活非标准专家生成合成样本,梯度过滤选最优样本微调;理论刻画随机专家激活与奖励样本选择为改善学习几何的机制。
- 约束:保持核心架构与代码库不变,只更新数值权重。
- 结果(作者自报,无独立复现):continual translation 对未见语言(Manchu、Kalamang)近乎零性能下降(ICL / Cartridges / SFT 严重遗忘);BABILong 长上下文近完美扩展至 10M token,超 GPT-4 与 Titans;SQuAD 事实知识单任务 48.9%、CPT 46.2%(超 base / SFT / SEAL);数学推理 AIME 24 79.2%、AIME 25 69.0%、HMMT 25 46.1%(超 SFT / GRPO / OPSD)。
- 作者:Ali Behrouz(Google + Cornell)、Farnoosh Hashemi(Cornell)、Adel Javanmard(Google + USC)、Vahab Mirrokni。
为什么值得关注:「不改架构、只改权重」是这条最有工程价值的部分——它意味着持续学习可以作为训练流程的附加阶段而非新模型。但 10M token 的 BABILong 成绩需要谨慎看待:这是作者自建的评测配置,且「近完美」在长上下文任务上通常意味着任务本身有可利用的结构。
来源:Google Research 官方博客 · https://research.google/blog/the-sleep-framework-a-new-way-for-llms-to-retain-knowledge-in-continual-learning/ · 2026-10-27
5. OCR 双发:百度 Unlimited-OCR 2 用稀疏参考滑窗把峰值缓存从 47 GB 降到 1.77 GB,OpenBMB 出 MiniCPM-OCR 套件
百度 Unlimited-OCR 2(10-27,MIT 许可,代码与权重开源至 GitHub / Hugging Face,上线百度智能云与百度 AI 开放平台):
- 核心机制:稀疏参考滑动窗口注意力(SR-SWA)——把文本-视觉注意力交互从超长序列压缩到固定大小的工作参考集(如 512 token,由 128 token 局部窗口 + 跨 32-token 块 top-16 选择组成),使每步解码延迟与显存占用几乎恒定;配合无限解码机制(Unlimited-Horizon Decoding)。
- 规模:约 3.34B 参数(激活 0.5B),保留 DeepSeek-OCR 式布局(SAM ViT-B + CLIP-L 编码器 → 12 层 MoE 解码器,每 token 路由 6/64 专家 + 2 共享专家);多页模式每页 273 image token。
- 自报成绩:MPDocBench 84.6(Qwen3.8-Max 78.3)、MarathonDocBench 77.1(Kimi-K3 33.7、前代 Unlimited-OCR 0.0)。子项:文本 89.6、公式 87.9、标题层级 48.2(最低)。
- 效率:百页场景单步解码比 Full Attention 快 7 倍、比上一代 R-SWA 快 5.6 倍;单文档峰值缓存从 47.00 GB 降至 1.77 GB;16 文档并行吞吐从 360 tokens/秒 提升到 1315 tokens/秒。可一次解析《哈利·波特》全系列 7 部超 3,600 页。
- 部署:BF16 权重约 6.7 GB,单张 A800-80GB 测试;支持 Transformers(
infer_multi多页单请求保留跨页上下文)与 SGLang(定制 wheel)。
OpenBMB MiniCPM-OCR 套件(10-27):MiniCPM-OCR 1.0(1.3B 参数解析模型)+ MiniCPM-OCR Jev(2B 参数质量评分模型);DSpark 加速下最高 128 页/分钟;1.0 在 Real5-OmniDocBench 得 93.68;Jev 提供模型无关的准确率检查,在 JevOCRBench 得 93.6 AUROC 识别需人工复核的内容。已随 transformers v5.21 落地。
为什么值得关注:47 GB → 1.77 GB 是这条真正的分量——它把「百页文档解析」从多卡降到单卡。但要注意:主打优势的 MarathonDocBench 是百度自建基准,第三方独立复测待社区;在通用单页 OmniDocBench 上 94.02 分仍落后专用模型。MiniCPM-OCR 的 Jev 走的是另一条路——不追求更高解析分,而是判断哪些内容需要人工复核,这在真实业务里往往比多 1 分更有用。
来源:GitHub baidu/Unlimited-OCR · https://github.com/baidu/Unlimited-OCR · 2026-10-27;新华网 · https://www.news.cn/tech/20261027/f97d067ddf65432f9e8024515d949784/c.html · 2026-10-27;transformers v5.21 release notes · https://github.com/huggingface/transformers/releases/tag/v5.21 · 2026-10-26
6. arXiv 本窗口精选:九篇值得读的
| arXiv | 标题 | 提交 | 一句话结论 |
|---|---|---|---|
| 2610.34654 | Thinking-in-Bets | 10-26 | 训练无关、纯 prompt:agent 在读到用户反馈前先写私有 Claim Checklist(每条 claim + 证据 + 0-1 置信度,阈值 0.5)。SWE-Together + SWE-Interact 上「错误批评导致的正确补丁误翻转」从 12.2% → 0.02%(6,074 中 744 → 6,130 中 1);Agents' Last Exam 上 3.5 Flash-Lite 误翻转 93.3% → 6.7%、复审通过率 30.0% → 95.0%。局限:仅测 Gemini、用模拟用户、阈值手设 |
| 2610.35434 | Skill^∞ | 10-26 | 技能优化的递归自我改进:meta agent 用 meta-skill 优化任务技能,并优化 meta-skill 本身。83 个 SkillsBench 任务通过率 60.7% vs 人工策划技能 56.4%、SkillEvolver 54.5% |
| 2610.34577 | Rethinking Verification in Agent Harnesses | 10-25 | 把验证作为 test-time scaling 的一个轴,四层框架(初始指令 / 回合中提醒 / 完成门 / 独立评审);17 种设计 × 7 个前沿编码模型。独立评审平均准确率 Terminal-Bench +5.9–9.5pt、SWE-bench Verified +3.9–6.6pt,成本仅 1.13–1.25× |
| 2610.37571 | TeamGym | 10-27 | 基于真实法律 / 金融 / 医疗 / 软件工程语料构建团队决策环境,引入 pivotal information(最小事实集)。8 个语言模型 × 12 个源语料:分发关键信息使成功率平均降 22.9 个百分点(communication gap);参与者需自行识别提取关键信息时再降 19.9 点(retrieval gap)。用 RL 在团队决策损失上训练可改善最终决策质量并诱发协调行为 |
| 2610.37523 | The Structure Gap | 10-27 | 定义 structure-encoded problems(输入输出映射由已知结构决定)。核心问题不是表达力而是有限数据下的识别、外推与认证。对高斯逆问题精确证明:已知算子的 Wiener 求解器达 Bayes 风险,而正确线性类中的稠密经验学习器有持续期望超额风险;另证明 cell-coverage 下界与 unobserved-orbit 不可识别结果 |
| 2610.37481 | Follow the Gradient(SafeTulu) | 10-27 | SimpleLoRIF:可扩展梯度嵌入,把反向传播限制在最后四个 transformer 块,可嵌入百万级样本数据集。在 emergent misalignment 上 AUC 高达 0.865;构建 SafeTulu(Tulu 3 移除与不安全响应梯度最对齐的 20% 样本),在 Qwen / Llama / Olmo 上把 GCG 攻击成功率最多降 22%,同时基本保持甚至提升能力 |
| 2610.37624 | Rare, Relevant, and Still Wrong | 10-27 | CrossProfile 诊断基准(60 模板、480 任务):两种启发式(选最稀有 claim、选与决策标准相关的 claim)都在可预测处失败——按相关性选择会重新引入诱饵;即使完美相关性过滤器在经典 hidden-profile 配置下也比 rarest-first 低 23–31 分;rarest-first 平均不优于随机。移除归属标签可使经典配置准确率提升 13–24 分 |
| 2610.37631 | What Improves During Pretraining? | 10-27 | 用不同年份网页快照训练的时间点模型提出 temporal variability score(TVS)。6 个基准 × 6 个模型家族:低与高 TVS 项在训练早期学习相似,但高 TVS 项后期提升更快;预训练结束时高 TVS 项在 36 个模型-基准设置中的 34 个胜出,平均优势 7.3 分(chance-normalized accuracy)。被 AACL 2026 录用 |
| 2610.37407 | Constraining the Commit Boundary | 10-27 | 提出 DIO/ODI 信息授权边界,区分 agent 推理可用证据与可授权持久身份变更的证据;抽象两阶段 supervisor 仅在 claim 特定授权合格证据支持每个必需命题、冲突已解决、操作在授权范围内、状态与策略版本仍有效时才允许 commit。明确声明是概念架构,无实现或实证验证 |
为什么值得关注:三篇指向同一件事——agent 的失败大多不在「能力」而在「信息流」。Thinking-in-Bets 说「先写下你相信什么,再听反馈」能把误翻转压到 0.02%;TeamGym 说「把关键信息分散给不同 agent」平均掉 22.9 分;CrossProfile 说「按相关性挑事实」反而比「按稀有度挑」更差。这三条合起来对多 agent 系统的设计含义很直接:不要指望 agent 自己判断哪条信息重要,要把「谁掌握什么」显式建模。
来源:arXiv 各篇 abs 页(链接见附录)· 2026-10-25 / 10-26 / 10-27 提交
五、值得关注的趋势
1. AI 数学声明进入「验证基础设施」竞争,瓶颈从「能不能证」转向「社区能不能及时验」。 48 小时内三家并立:OpenAI 10-26 三项声明(附 Lean + $5M 捐 Simons)、Anthropic 10-27 递交 3-SAT 亚指数算法(署名 Claude,Lean 4 + nanoda 二次内核)、Axiom 10-26 用 24 天形式化完有限单群分类(43.1M 行 Lean,报 34 处文献偏差)。三家的共同点是前三环已工程化、第四环是空的——模型产出、Lean 形式化、独立内核复核都能自动跑,唯独「外部工作组认证」还得靠人手,而 Impagliazzo / Paturi / Williams 的公开信明确说「参与不应被视为认证」。判断:2027 年前,「附 Lean 证明 + 公开仓库 + 第三方复核排期」会成为 AI 科学声明的发布规范;对团队的直接行动项是给自家 agent 的科学类产出配 verifier 与重跑预算,而不是配更贵的模型。
2. agent 供应链与推理基础设施安全在同一窗口密集爆发,共同点是「信任边界在别人的依赖里」。 Cloudflare 的 KV 泄露根因是「SGLang 的 finished() 判断失效 + 池小于上下文」,Warp 的泄露根因是「第三方 vendor 被攻陷」,CyberStrikeAI 的 44 个 agent 打的是「默认凭据 + 未打补丁的边缘设备」。三条看似无关,但都是自己代码没问题、依赖出问题。Cloudflare 那份复盘里最值得抄的一句是「上线前只验证了 HTTP 响应码与引擎性能,未验证输出的内容与连贯性」——这个盲点对所有自建推理服务的团队都成立。判断:「依赖项的失效模式」会从安全团队的检查项升级为架构评审的必填项;对自建 agent 的团队,给每个外部依赖写一条「它坏了会怎样」的断言比再加一层 WAF 更有用。
3. 开放权重在同一天被两端同时刷新上限,中间档位的稠密模型两头受挤。 端侧 Liquid AI LFM3 把「够用」压到 4-bit 约 1 GB 内存 + 256K 上下文(六个 2B 级模型共用一条 1.73B 骨干),服务端蚂蚁 Ling-3.1 把「开放」压到 560B 总参 / 25B 激活 + 1M 上下文 + MIT 许可(还附可继续训练的 base 基座)。两者许可策略完全相反:LFM Open License v1.0 把商用限定在年收入 < $10M 的组织,Ling 用 MIT 放开商用与再训练。
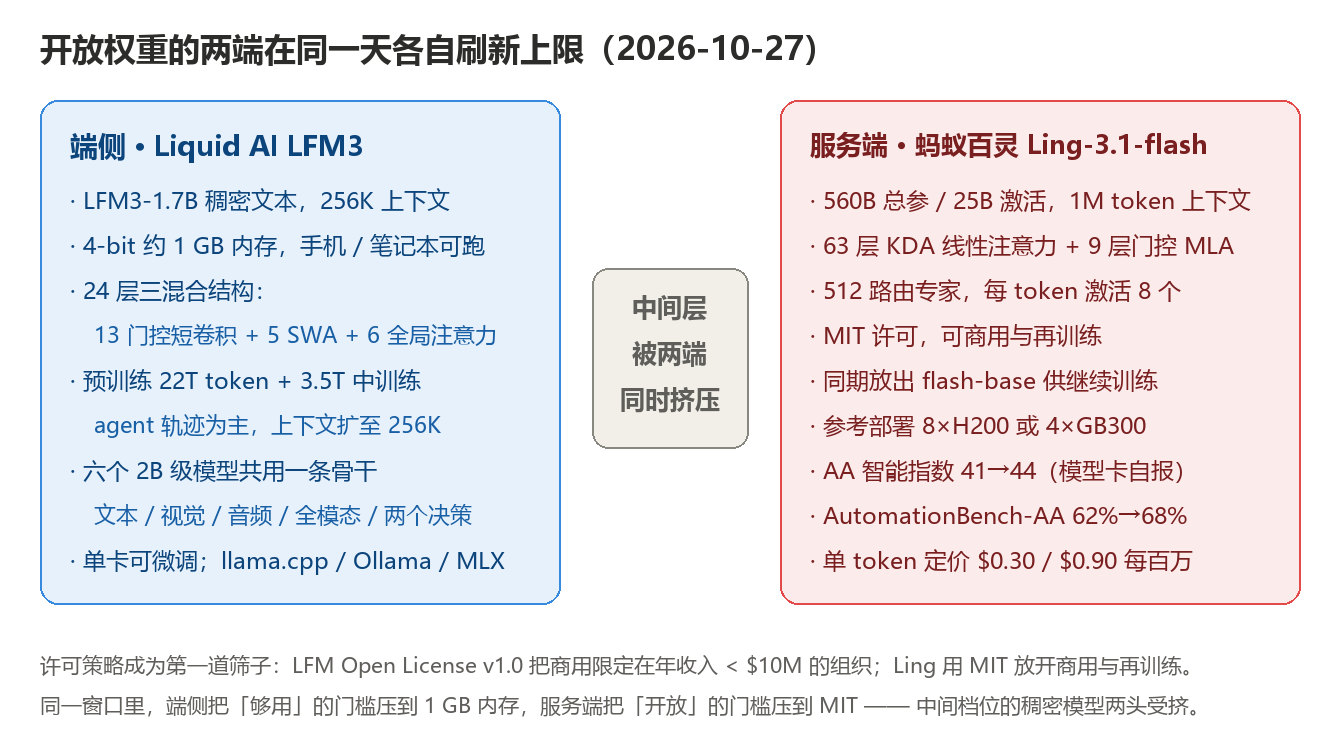
判断:「开放权重」正在分裂成两个不同的东西——端侧的「开放」是「能在你的设备上跑」,服务端的「开放」是「能拿去做自己的模型」。夹在中间的 7B–70B 稠密模型会最先感到压力:端侧够不着它的能力、服务端比它便宜且更宽松。对选型团队,先问「我要的是部署自由还是改造自由」,答案决定该看哪一端。
4. 企业 agent 从「工具」变成「有身份的雇员」,账号、权限、审计成为独立产品线。 同一窗口里:Anthropic 给 GSA 全线产品 40% 折扣且无最低消费承诺(约 500 家政府组织在用,Claude for Government 周活自 2 月增 8 倍);Oracle 把 OpenAI 包装成四款带治理与审批的企业 offerings(含免费起步的 SMB 套餐);Replit Cloud Agents 让非工程人员提需求、agent 在云端验证后直接开 PR;IBM 的 Agent Identity + HashiCorp Vault 2.2 与 1Password for Agents 分别从「策略侧」和「人在环侧」解决 agent 凭据问题。判断:agent 的采购决策正在从「买多少 token」变成「给哪些权限」——这解释了为什么 Vault 和 1Password 会把 agent 身份做成独立 SKU。对企业的直接含义:在给 agent 开账号之前,先确定谁能撤销它、撤销后多久生效、它的操作留痕在哪——这三个问题的答案比模型选型更影响上线时间。
六、有趣的 AI 开源项目
1. stablyai/orca(TypeScript / MIT,108,231★,2026-03-17 创建,10-28 04:29 推送)——桌面 / 移动 / 远程运行任意编码 agent 舰队(如 Grok Bot、Claude Code),用你自己的订阅。入选理由:10.8 万星这个量级说明「多 agent 编排」已经从极客玩具变成刚需;而「用你自己的订阅」是关键设计——它不转售 token,只做编排层,绕开了所有 API 转售的合规问题。对已经在付 Claude Code / Codex 订阅的读者,这是把多个订阅拼成一条流水线的最低成本方式。
来源:GitHub · https://github.com/stablyai/orca · 2026-10-28(API 实测 108,231★)
2. KnockOutEZ/wigolo(TypeScript / NOASSERTION,5,509★,2026-04-12 创建,10-27 10:30 推送)——本地优先的搜索 / 抓取 / 爬取 / 研究 MCP server:无 API key、无云、$0/query,公开 beta。入选理由:给 agent 做检索的 MCP server 大多要接付费搜索 API,wigolo 把整条链路放在本地,代价是自己维护抓取与解析。对成本敏感的自动化场景(每天几千次检索)这是唯一能把边际成本压到零的路子;但「本地优先 + 无 key」也意味着反爬与合规责任全在使用方。
来源:GitHub · https://github.com/KnockOutEZ/wigolo · 2026-10-27(API 实测 5,509★)
3. FrigadeHQ/hob(TypeScript / MIT,278★,2026-10-14 创建,10-28 00:43 推送)——「更简单的本地 AI 使用方式」,免费开源的 Claude / ChatGPT 替代品,在 Mac / Windows / Linux 本地跑 Gemma、gpt-oss 等开放权重模型,私密且可离线。入选理由:星数不大但方向值得记——「本地跑开放权重」的体验层正在被重做,而这一层此前一直是 Ollama 的领地。它与本期 LFM3(1 GB 内存跑 256K)指向同一个趋势:端侧模型的能力已经够用,缺的是「不用懂命令行就能用」的壳。
来源:GitHub · https://github.com/FrigadeHQ/hob · 2026-10-28(API 实测 278★)
⚠️ 待核实
- Ling-3.1-flash-1019 的 AA 成绩与发布日期:AA 智能指数 41→44、AutomationBench-AA 62%→68% 为 inclusionAI 模型卡自报,Artificial Analysis 上当时仅见总指数;AA 记发布日期为 10-22 而 HF 仓库创建于 10-27,两者差异未获解释。huggingface.co 本环境不可直接访问,规格(560B/25B、63 层 KDA + 9 层 MLA、512 专家)经官方帖与二手交叉,可能有转述误差。
- Genie 4 的全部能力描述:官方博客无任何量化指标(无分辨率、帧率、会话时长、一致性时长),本条目所有描述均来自文字表述与演示,无数字可核。
- Axiom CFSG 的「2,000+ 错误」:官方页确认 24 天、43.1M 行、34 处显著偏差;「2,000+ 错误」主要源自二手 X 帖(The Agent Times 已指出),不写入正文。
- Anthropic ETH 反驳的独立复核状态:仓库自述 CI 用 nanoda 二次内核,但无第三方数学家认证;README 明确「
MainResults.lean与论文陈述的一致性需人类读者判断」。Impagliazzo / Paturi / Williams 工作组仅发公开信组织审阅,未出具结论。 - Warp 泄露的数据字段范围:是否含源码 / 提示词 / 文件路径 / 凭据未确认;vendor 与漏洞未点名;「agent swarm」为 Warp 初步判断(原文用 appears / likely),无第三方确认,CrowdStrike 调查未出结论。
- CyberStrikeAI 报告的原始数据:TrendAI 报告经 The Hacker News 转述,报告原文未直接获取;「至少 19 家组织 / 至少 16 家在日本」为报告口径,未见受影响组织自行确认。
- Apple Creator Studio 的 MCP 访问是否需要订阅:官方公告未说明,仅标「需 macOS 27+」。
- 智元 Genie Master 的 Physical RSI 效果:均为厂商 / 媒体报道口径,无独立复现;11-02 的 24 小时直播考核结果尚未产生。
- Cursor DeepSeek V4.1 Flash 的 CursorBench 数字:来源为 aicoder.com 转述 Cursor changelog,Cursor 官方 changelog 页本环境未直接获取;四档分数与单任务成本可能有转述误差。
- Disruptive $10B 基金与趋境科技 B 轮:分别以 Bloomberg 与中文财经媒体(智通财经)为主,未见基金 / 公司官方公告逐条确认。
本期淘汰记录
- OpenAI 前沿模型训练环境断网加固(DNS 逃逸、11 天暂停、Kata Containers CVE-2026-24834、Patch the Planet):索引第 14 行已更新至 10-24,本期无新进展——按纪律淘汰。
- Meta $95B 融资主体(10-27 已报):本期只写 NVIDIA $3B / AMD $1B 落定的增量,其余不重复。
- OpenAI ETH 三项科学声明(10-27 已报):本期仅作 Anthropic 反驳的背景,不单列。
- Cohere / Qwen3.8-Flash-Next、Forever Security AGENTS.md 劫持、OpenHands CVE-2026-112346、Drew Breunig 上下文工程:均为 10-27 期已完整报道,窗口内无新进展。
- makecindy/cindy(10-26 已报约 4,600★,现 7,342★):仅星数增长,无版本级变化——按规则不成条。
- morluto/rea:索引已有,窗口内无新发布。
- microsoft/agensh(775★,2026-08-27 创建,10-23 推送):窗口外旧闻重推,与 10-27 期淘汰记录一致。
- Ollama v0.40.12-rc0:10-27 期已报,窗口内无新 rc 或正式版。
- 1Password for Agents:实际发布于 10-22,早于本期窗口;本期仅作为「agent 身份产品线」的背景与 IBM 并列,不单列条目。
- Cadence Maestro:仅见腾讯新闻 / IT时代网二手转述,一手发布页未定位——进待核实后仍不足,淘汰。
- Self-Direction(arXiv:2610.31846):10-22 提交,窗口外;且其「经验存为独立 LoRA 适配器」路线与本期 Thinking-in-Bets 的「先写 claim 再听反馈」属同一问题域但更早,不重复。
- Recursive Semantic Divergence(arXiv:2610.33012):10-08 提交,窗口外旧档。
- Honeycomb-Surfels / ThinkWorld / Attention as Lattice Gauge Theory / MuonGS / Concordat / M4Bench 等 cs.AI 候选:均为 3D 重建、世界模型或纯理论方向,与本期三条主线(agent 安全、开放权重、科学验证)关联不足,且未逐篇回验元数据——按「写不出为什么值得关注就淘汰」处理。
- 纯融资稿与常规产品更新(FireMon Agentic AI 的三个 agent、Springer Nature 之外的若干企业合作稿):无量化数据、无可验证的机制变化,或与 10-27 期已报条目同实体。
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止日期 |
|---|---|---|---|---|---|---|
| 1 | 模型与产品 | LFM3: a family of models built on one backbone | Liquid AI | https://www.liquid.ai/blog/lfm3 | 2026-10-27 | 2026-10-27 |
| 2 | 模型与产品 | llama.cpp releases(LFM3 五个变体) | GitHub | https://github.com/ggml-org/llama.cpp/releases | 2026-10-27 | 2026-10-28 |
| 3 | 模型与产品 | Ling-3.1-flash-1019 模型卡 | Hugging Face(inclusionAI) | https://huggingface.co/inclusionAI/Ling-3.1-flash-1019 | 2026-10-27 | 2026-10-27 |
| 4 | 模型与产品 | Genie 4: a new generation of world simulation | Google DeepMind | https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/ | 2026-10-27 | 2026-10-27 |
| 5 | 模型与产品 | Apple Creator Studio adds powerful new AI features | Apple Newsroom | https://www.apple.com.cn/newsroom/2026/10/apple-creator-studio-adds-powerful-new-ai-features-and-even-more-creative-tools/ | 2026-10-27 | 2026-10-27 |
| 6 | 模型与产品 | 能管事的 AI 助理!蚂蚁灵光 2.0 发布 | 科技日报 | https://www.stdaily.com/web/gdxw/2026-10/27/content_603557.html | 2026-10-27 | 2026-10-27 |
| 7 | 模型与产品 | 蚂蚁集团发布灵光 2.0:AI 从「任务执行者」走向「事务管理者」 | 中证网 | https://www.cs.com.cn/ssgs/cj2020/2026/10/27/detail_2026102710047464.html | 2026-10-27 | 2026-10-27 |
| 8 | 模型与产品 | 蚂蚁升级灵光 2.0,已内置支付宝账单、钉钉等服务能力 | 中国证券网 | https://www.cnstock.com/commonDetail/812556 | 2026-10-27 | 2026-10-27 |
| 9 | 模型与产品 | 智元 Genie Master 发布,Physical RSI 首次真实业务验证 | 南方新闻网 | https://www.nfnews.com/content/n614Jlzk3P.html | 2026-10-27 | 2026-10-27 |
| 10 | 模型与产品 | Firefox Smart Window AI fill forms | The Verge | https://www.theverge.com/ai-artificial-intelligence/1019551/firefox-smart-window-ai-fill-forms | 2026-10-27 | 2026-10-27 |
| 11 | 工程与架构 | Remediating the GLM-5.3 KV cache exposure | Cloudflare | https://blog.cloudflare.com/kv-cache-exposure-remediation/ | 2026-10-26 | 2026-09-19 |
| 12 | 工程与架构 | SGLang PR #36988(prefill 中止请求传递) | GitHub | https://github.com/sgl-project/sglang/pull/36988 | 2026-09-06 | 2026-09-06 |
| 13 | 工程与架构 | Warp discloses breach exposing AI agent logs, user telemetry data | BleepingComputer | https://www.bleepingcomputer.com/news/security/warp-discloses-breach-exposing-ai-agent-logs-user-telemetry-data/ | 2026-10-27 | 2026-10-26 |
| 14 | 工程与架构 | Warp Says Vendor Hack Exposed Agent Data of Up to 1% of Users | TSNMedia | https://tsnmedia.org/warp-vendor-breach-agent-telemetry | 2026-10-26 | 2026-10-26 |
| 15 | 工程与架构 | CyberStrikeAI uses 44 AI agents to attack Japan | The Hacker News(引 TrendAI) | https://thehackernews.com/2026/10/cyberstrikeai-uses-44-ai-agents-to.html | 2026-10-27 | 2026-10-27 |
| 16 | 工程与架构 | Cursor 上线 DeepSeek V4.1 Flash 与 Agent SDK | AI Coder | https://aicoder.com/news/news-20261026-cursor-deepseek-v4-1-flash-cursorbench-cost-frontier | 2026-10-26 | 2026-10-26 |
| 17 | 工程与架构 | Claude Code v2.1.312 | GitHub | https://github.com/anthropics/claude-code/releases/tag/v2.1.312 | 2026-10-27(20:24 UTC) | 2026-10-27 |
| 18 | 工程与架构 | Codex CLI rust-v0.165.0 | GitHub | https://github.com/openai/codex/releases/tag/rust-v0.165.0 | 2026-10-27(20:09 UTC) | 2026-10-27 |
| 19 | 工程与架构 | transformers v5.21 | GitHub | https://github.com/huggingface/transformers/releases/tag/v5.21 | 2026-10-26(18:17 UTC) | 2026-10-26 |
| 20 | 工程与架构 | pydantic-ai releases(v2.62.0 / v2.63.0) | GitHub | https://github.com/pydantic/pydantic-ai/releases | 2026-10-27 / 10-28 | 2026-10-28 |
| 21 | 工程与架构 | browser-use 0.13.14 | GitHub | https://github.com/browser-use/browser-use/releases/tag/0.13.14 | 2026-10-26(22:00 UTC) | 2026-10-26 |
| 22 | 行业与发展 | Expanding our partnership with GSA | Anthropic | https://www.anthropic.com/news/expanding-partnership-gsa | 2026-10-27 | 2026-10-27 |
| 23 | 行业与发展 | Early progress on drug development | Anthropic Research | https://www.anthropic.com/research/early-progress-drug-development | 2026-10-27 | 2026-10-27 |
| 24 | 行业与发展 | Nvidia to invest $3 billion in Meta | CNBC | https://www.cnbc.com/2026/10/27/nvidia-invest-meta.html | 2026-10-27 | 2026-10-27 |
| 25 | 行业与发展 | Oracle reinvents enterprise computing for the AI era with OpenAI | Oracle | https://www.oracle.com/news/announcement/ai-world-oracle-reinvents-enterprise-computing-for-the-ai-era-with-openai-2026-10-27/ | 2026-10-27 | 2026-10-27 |
| 26 | 行业与发展 | Anyone can bring ideas to the company codebase | Replit | https://replit.com/blog/anyone-can-bring-ideas-to-company-codebase | 2026-10-27 | 2026-10-27 |
| 27 | 行业与发展 | IBM Agent Identity and HashiCorp Vault 2.2 | SiliconANGLE | https://siliconangle.com/2026/10/27/ibm-agent-identity-hashicorp-vault-2-2/ | 2026-10-27 | 2026-10-27 |
| 28 | 行业与发展 | 1Password for Agents | 1Password | https://blog.1password.com/1password-for-agents/ | 2026-10-22 | 2026-10-22 |
| 29 | 行业与发展 | UK Home Office AI asylum decisions | WIRED | https://www.wired.com/story/uk-home-office-ai-asylum-decisions/ | 2026-10-27 | 2026-10-27 |
| 30 | 行业与发展 | Home Office AI asylum claims watchdog | The Guardian | https://www.theguardian.com/uk-news/2026/oct/27/home-office-ai-asylum-claims-watchdog | 2026-10-27 | 2026-10-27 |
| 31 | 行业与发展 | Disruptive raises $10 billion fund | Bloomberg | https://www.bloomberg.com/news/articles/2026-10-27/disruptive-raises-10-billion-fund-for-late-stage-ai-bets | 2026-10-27 | 2026-10-27 |
| 32 | 行业与发展 | 趋境科技完成 B 轮超 13 亿元融资 | 智通财经 | https://www.zhitongcaijing.com/content/detail/1513286.html | 2026-10-27 | 2026-10-27 |
| 33 | 论文与开源 | A 2^o(n) Time Algorithm for 3-SAT(eth 目录) | GitHub(anthropics/formal-math) | https://github.com/anthropics/formal-math/tree/16a5ce41304fcdaea4e0be7c132e1c361dc26da5/eth | 2026-10-27 | 2026-10-27 |
| 34 | 论文与开源 | Frontier AI labs say their models refuted ETH | TechCrunch | https://techcrunch.com/2026/10/27/frontier-ai-labs-say-their-models-refuted-the-exponential-time-hypothesis-what-does-that-mean/ | 2026-10-27 | 2026-10-27 |
| 35 | 论文与开源 | The Enormous Theorem, Formalized | Axiom | https://axiommath.ai/research/the-enormous-theorem-formalized/ | 2026-10-26 | 2026-10-26 |
| 36 | 论文与开源 | Old Ideas, Novel Problems(NoveltyBench) | Ai2 | https://allenai.org/blog/novelty-bench | 2026-10-27 | 2026-10-27 |
| 37 | 论文与开源 | The sleep framework: a new way for LLMs to retain knowledge | Google Research | https://research.google/blog/the-sleep-framework-a-new-way-for-llms-to-retain-knowledge-in-continual-learning/ | 2026-10-27 | 2026-10-27 |
| 38 | 论文与开源 | baidu/Unlimited-OCR | GitHub | https://github.com/baidu/Unlimited-OCR | 2026-10-27 | 2026-10-27 |
| 39 | 论文与开源 | 百度 Unlimited-OCR 2 发布 | 新华网 | https://www.news.cn/tech/20261027/f97d067ddf65432f9e8024515d949784/c.html | 2026-10-27 | 2026-10-27 |
| 40 | 论文与开源 | Thinking-in-Bets | arXiv | https://arxiv.org/abs/2610.34654 | 2026-10-26 提交 | 2026-10-26 |
| 41 | 论文与开源 | Skill^∞: recursive skill optimization | arXiv | https://arxiv.org/abs/2610.35434 | 2026-10-26 提交 | 2026-10-26 |
| 42 | 论文与开源 | Rethinking Verification in Agent Harnesses | arXiv | https://arxiv.org/abs/2610.34577 | 2026-10-25 提交 | 2026-10-25 |
| 43 | 论文与开源 | TeamGym: team decision-making with distributed information | arXiv | https://arxiv.org/abs/2610.37571 | 2026-10-27 提交 | 2026-10-27 |
| 44 | 论文与开源 | The Structure Gap | arXiv | https://arxiv.org/abs/2610.37523 | 2026-10-27 提交 | 2026-10-27 |
| 45 | 论文与开源 | Follow the Gradient(SafeTulu) | arXiv | https://arxiv.org/abs/2610.37481 | 2026-10-27 提交 | 2026-10-27 |
| 46 | 论文与开源 | Rare, Relevant, and Still Wrong(CrossProfile) | arXiv | https://arxiv.org/abs/2610.37624 | 2026-10-27 提交 | 2026-10-27 |
| 47 | 论文与开源 | What Improves During Pretraining? | arXiv | https://arxiv.org/abs/2610.37631 | 2026-10-27 提交 | 2026-10-27 |
| 48 | 论文与开源 | Constraining the Commit Boundary | arXiv | https://arxiv.org/abs/2610.37407 | 2026-10-27 提交 | 2026-10-27 |
| 49 | 开源项目 | stablyai/orca | GitHub | https://github.com/stablyai/orca | 2026-10-28(108,231★) | 2026-10-28 |
| 50 | 开源项目 | KnockOutEZ/wigolo | GitHub | https://github.com/KnockOutEZ/wigolo | 2026-10-27(5,509★) | 2026-10-27 |
| 51 | 开源项目 | FrigadeHQ/hob | GitHub | https://github.com/FrigadeHQ/hob | 2026-10-28(278★) | 2026-10-28 |
引用提醒:本文所有条目均来自上表所列公开来源;厂商自测数据(LFM3 全部跑分、Ling-3.1 的 AA 指数与 AutomationBench、Genie 4 的能力描述、智元 Genie Master 的 Physical RSI 效果、Cursor 的 CursorBench 四档、Replit 的内部效率数据、Anthropic 的政府案例与药物研发倍数、百度 Unlimited-OCR 2 的 MarathonDocBench)未经独立复现,引用时请保留「厂商自测」标注。arXiv 论文均为预印本,未经同行评审。待核实区条目不得作为事实引用。配图为依据上述来源自绘,非原文插图。