AI DAILY
AI 日报 2026-11-04
一句话结论本期收录 20 条正文条目(模型与产品 3、工程与架构 4、行业与发展 6、论文 7)+ 4 个开源项目,淘汰 15 条独立候选、合并 3 组、翻案 1 条。最值得看的三件事都指向同一个词——「口径」:第一,腾讯混元 Hy4 正式版把「模型能力」和「办公协同入口」绑在一起发布,770B/49B 激活、1M 上下文、首次引入视觉与 Computer Use,但真正有信息量的是它自曝的两个数字——金融众测 579 个真实任务里综合 3.04 分居开源第一,以及幻觉率从 preview 的 15.76% 降到 5.45%;一个模型愿意公布自己的幻觉率,比它公布多少个榜单第一更值得记。第二,Anthropic 修订版招股书把「算力承诺」这个此前只有定性描述的东西变成了可查的会计科目:8,954 亿美元承诺、Q3 算力费用 98.63 亿(占营收 58%)、单季由盈转亏 5.67 亿——这是 AI 行业第一次有人把「增长越快、亏得越多」的机制写在监管文件里。第三,GitHub Octoverse 2026 给了一个会被长期误读的数字:含 agent 配置文件的当年新仓库平均提交量是同类仓库的 8 倍——这是相关性,不是因果,GitHub 自己在方法论里写明了这一点,而中文转述几乎全部省略了这句。
AI 日报 2026-11-04
整理日期:2026-11-04 素材来源:白名单一手信源(腾讯混元官方发布文与腾讯新闻、Anthropic Claude 官方文章、Deep Principle 官方发布文与 ModelScope 模型卡、OpenAI 官方博客、GitHub Blog 与 GitHub Releases/API、Anthropic 招股书经中新经纬与证券时报梳理、FT 经中央社与 C114 转述、The Information 经香港经济日报与链新闻转述、arXiv 原始 abs 页、Android Developers Blog),逐条见文末附录 可信度提示:本期统计窗口 2026-11-03 00:00 → 11-04 20:00 HKT。四条硬约束先说清:① arXiv 11-04 批次截至本刊检索时尚未生成(cs.AI 与 cs.CL 的
submittedDate查询均返回 0),本期论文全部来自 11-03 UTC 15:46–18:54 提交的批次,编号 2611.05088–2611.05358,属窗口内新投稿,已在各条标注 v1 时间戳。② 腾讯混元 Hy4 的官方发布页为 JS 渲染,直接抓取只得到导航骨架,本期数字取自官方发布文全文转载(腾讯搜索页)与腾讯新闻两篇独立报道交叉核对,全部为厂商自测、无第三方复现;权重「近期开源」尚无仓库地址。③ Anthropic 招股书数字需修正——本期核查后确认承诺总额为 8,954 亿美元(约人民币 6 万亿元),此前流传的「1.07 万亿美元」口径无法在修订稿中找到对应,已按一手梳理口径改写。④ NVIDIA 51% 红线与 Oracle 取消腾讯租约均为 FT 引知情人士,NVIDIA 官方回应未确认也未否认 51% 这个数字,Oracle 与腾讯双方均未公开置评。 配图:文中三张图为自绘(依据下列来源整理),非原文插图。
#AI日报 #模型动态 #工程架构 #论文 #开源项目 #行业观察
一句话结论
本期收录 20 条正文条目(模型与产品 3、工程与架构 4、行业与发展 6、论文 7)+ 4 个开源项目,淘汰 15 条独立候选、合并 3 组、翻案 1 条。最值得看的三件事都指向同一个词——「口径」:第一,腾讯混元 Hy4 正式版把「模型能力」和「办公协同入口」绑在一起发布,770B/49B 激活、1M 上下文、首次引入视觉与 Computer Use,但真正有信息量的是它自曝的两个数字——金融众测 579 个真实任务里综合 3.04 分居开源第一,以及幻觉率从 preview 的 15.76% 降到 5.45%;一个模型愿意公布自己的幻觉率,比它公布多少个榜单第一更值得记。第二,Anthropic 修订版招股书把「算力承诺」这个此前只有定性描述的东西变成了可查的会计科目:8,954 亿美元承诺、Q3 算力费用 98.63 亿(占营收 58%)、单季由盈转亏 5.67 亿——这是 AI 行业第一次有人把「增长越快、亏得越多」的机制写在监管文件里。第三,GitHub Octoverse 2026 给了一个会被长期误读的数字:含 agent 配置文件的当年新仓库平均提交量是同类仓库的 8 倍——这是相关性,不是因果,GitHub 自己在方法论里写明了这一点,而中文转述几乎全部省略了这句。
一、模型与产品
1. 腾讯混元 Hy4 正式版:770B / 49B 激活,首次引入视觉与 Computer Use,权重「近期」开源
11-04 发布。相比 8-28 的 Hy4 preview,官方口径是「显著扩展预训练与后训练规模」,并首次引入视觉能力与电脑操作。硬指标延续 preview:总参 770B、激活 49B、上下文 1M。
能力面分四块,官方给的证据密度不均:
| 场景 | 官方说法 | 证据等级 |
|---|---|---|
| 视觉 + 电脑操作 | 结合感知、推理与工具调用,做细粒度图像处理、复杂图表分析、数学视觉推理;首次支持电脑操作,可结合命令行与图形界面;针对 Blender、CAD 等专业软件与跨应用长程任务做专项训练 | 演示为主,无独立复现 |
| 前端与游戏开发 | 与腾讯 IEG 游戏开发者合作,深度适配 UE / Unity / Godot,开始扩展至多人联机;GameDev +19.1%、GameLogic +9.8%(对 preview) | 厂商自测 |
| 金融与办公 | 数千个工作空间、上万高质量任务;联合腾讯金融科技组织 213 位专家(153 位来自外部头部金融机构、七成 5 年以上经验)做众测,579 个真实金融任务综合得分 Hy4 3.04 / DeepSeek-V4.1-Flash-1017 2.97 / Kimi-K3.1-Pro 2.68 / GLM-5.3 2.68,居开源第一 | 众测有外部专家,但仍由厂商组织与计分 |
| 科研 | 7 大学科、123 项可执行研究任务的 TenureTrail 内部评测居开源第一;小鼠胚胎三维重建(699 万细胞 / 84 张无序切片 / 1.5 小时 / 全程无人干预);与北大数学团队找到 Méndez–Pinto–Villarreal 猜想反例并做 Lean 形式化验证 | 内部评测 + 个案演示 |
真正值得单独拎出来的是两个自曝数字:自建测试中幻觉率从 preview 的 15.76% 降至 5.45%,猜测导致的错误率从 23.1% 降至 5.6%。在一个普遍不公布幻觉率的发布季里,这组数字比任何榜单排名都更有信息量——当然它也是自建测试,没有说明测试集构成与判定方式。
该怎么读:Hy4 的发布叙事重心不在「追上闭源」,而在入口。官方明确它已上线 WorkBuddy/CodeBuddy、元宝、企业微信智能助理、ima、腾讯云 TokenHub,API 同步接入 OpenRouter、Hermes、OpenCode,定价与 preview 保持一致,更便宜的 Hy4 flash「近期发布」。配套披露的 WorkBuddy 企业版数据(50 多个行业、中国企业 500 强覆盖 50% / 100 强覆盖 60%、开放平台伙伴与开发者超 5 万家、上架 Skills 超 20 万个)说明腾讯押的是「模型 + 办公协同 + Skills 市场」这套组合,而不是单纯的模型能力。腾讯集团高级执行副总裁汤道生的说法很直白:企业落地 Agent 最大的问题不是模型不够强,而是断点太多。
同时官方主动划了边界:Hy4「与顶尖闭源模型仍存在较大差距」,尤其在前沿数学、长程开发、模型迭代、视觉问答的高难度测试集上;生物实验设计能力 Hy-BioExperimentBench 30.4/100,明确说「尚未发现能显著降低生物化学危害门槛」。安全侧只纳入防守性网络安全数据、剔除攻击性训练内容,由腾讯玄武与科恩实验室做审计。权重「近期开源」、系统卡片同步发布、已联合 vLLM/SGLang 社区与 Inferact Inc. 提供生态支持——但截至本期检索,没有仓库地址,不能称「已开源」。
来源:腾讯混元官方发布文(全文转载)· https://so.html5.qq.com/page/real/search_news?docid=70000021_1036aeb0d6a19652 · 2026-11-04 交叉核对:腾讯新闻(驱动中国 / 21 世纪经济报道)· https://news.qq.com/rain/a/20261104A0AIZN00 · 2026-11-04
2. Anthropic Message Threads:把「重发历史」从请求体里拿掉,长会话 TTFT 中位降 35%
11-02 官方发布,Public Beta。问题定义很具体:长时间运行的编码 agent 一个会话可能发起数百次请求,每轮都要重发此前的全部对话与工具结果;当上下文累积到几十万 token,Claude 还没开始生成,时间就已经花在了上传上。
机制是「对话只发一次,之后每轮只发新增」:首个请求带完整内容并开启 thread,后续请求只含新增消息 + 上一次响应 ID,服务端在轮次之间在内存中加密持有会话、不写磁盘。关键边界必须说清——Claude 每轮仍读取完整对话,因此 token 用量不变,省的是请求体上传时间,不是计费。
| 指标 | 官方口径 | 需要注意 |
|---|---|---|
| TTFT | 50 万–100 万 token 的请求,中位下降约 35%;对大多数 Claude Code 用户默认开启 | 未给分位数分布与测试集;上下文越长收益越明显 |
| 请求体 | 只发增量;computer use 类 agent 的截图留在 thread 中不再重传;文档/图片密集工作流显著变小 | 官方未给具体缩减百分比 |
| 过期 | 最后一次请求后 5 分钟失效,过期需重发全量开新 thread | 只适合活跃会话,不适合长时间挂起的低频对话 |
| 可用性 | 原生 Claude Platform、Claude Platform on AWS、Claude in Microsoft Foundry、Claude Models on Google Cloud(Anthropic managed) | 按标准 token 费率计费,适用现有速率限制 |
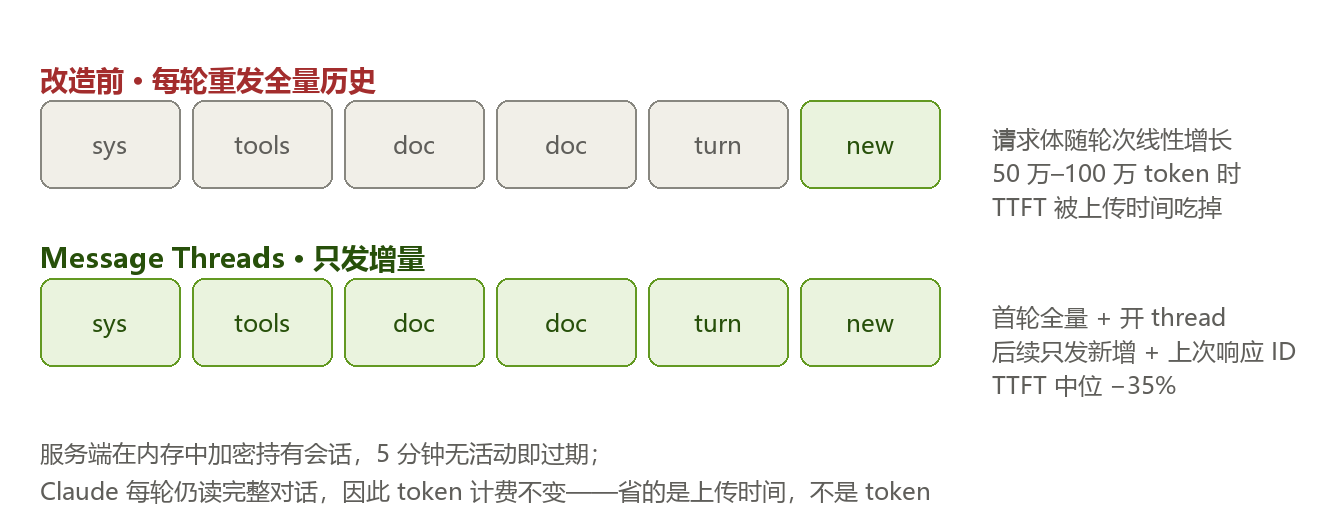
该怎么读:这条的价值不在 35%,而在它把「上下文成本」拆成了两个可以独立优化的量——token 数(决定计费与注意力计算)和字节数(决定网络与序列化开销)。过去两者被绑在一起,只能靠「少放上下文」同时压;Message Threads 证明字节数可以单独压掉,且不影响模型实际读到的内容。对做 agent 基础设施的团队,这是一个可以直接照搬的抽象:会话状态服务端持有 + 客户端只发 delta。代价是 5 分钟过期带来的状态脆弱性——一旦客户端丢连接,恢复成本是全量重传。
来源:Anthropic(Claude Platform / Announcements)· https://claude.com/resources/articles/message-threads · 2026-11-02
3. Deep Principle Hydrogen-1.0:753B 科学模型开放权重,MIT 许可,FSR 38.3% 超 GPT-6 Astra
11-02 发布、11-03 权重落地 Hugging Face 与 ModelScope。杭州 AI for Science 公司深度原理(Deep Principle)以智谱 GLM-5.3 为基座做科学后训练,产出 753B MoE(架构 GlmMoeDsaForCausalLM,动态稀疏注意力 + MoE),1M 上下文 / 128K 输出,MIT 许可(比 GLM-5.3 的自定义许可宽松,可商用、可改、可再分发)。BF16 权重约 1.5 TB / 303 个分片,另有 NVFP4(B200/B300)与 MXFP4(MI350X/MI355X)量化版;官方称已在 8 卡上用 SGLang 测试。
训练数据是这条最值得记的部分:除领域知识外,还灌入了科学家的任务级反馈、自有实验室记录(含失败实验与修正过的假设)、完整发现轨迹。多数科学模型吃的是论文与教科书里的「干净答案」,这家吃的是「假设 → 实验 → 失败 → 修正 → 再试」的全过程。
| 评测 | Hydrogen-1.0 | 对照 | 说明 |
|---|---|---|---|
| FrontierScience-Research(多步科研推理) | 38.3% | GPT-6 Astra 33.3%;基座 GLM-5.3 高 13.9pp | 厂商自测 |
| GPQA-Diamond | 93.0% | 基座 +3pp;Kimi-K3 93.5% | 198 道专家题 |
| 科学计算(内部) | 76.92% | GPT-6 Astra 71.79% | 内部场景,官方注明绝对分差反映内部题目难度 |
| 单步正向反应预测(内部) | 90.48% | GPT-6 Astra 83.33% | 同上 |
| NMR 结构解析(内部) | 落后 3.33pp | GPT-6 Astra | 官方主动承认这一项不如对手 |
| 过渡金属配合物设计(5 轮迭代) | HOMO-LUMO 带隙 4.318 eV | Astra 3.689 / Kimi-K3 3.353 | 仅接收自身反馈 |
该怎么读:这条有两层意义。第一层是「开放权重」本身——OpenAI 用 agent 证明 Navier-Stokes 有限时间奇点并做 Lean 形式化、Anthropic 通过基因组分析找到带 CRISPR 样重复序列的酶系统,这些发现能力都锁在闭源模型里;Hydrogen-1.0 把「科学后训练」这条路用 MIT 权重重新铺了一遍,任何实验室都能下载后在自己的「祖传数据」上继续训。第二层是它的工程细节,比榜单更能说明团队水平:全模型 MoE 后训练用 Muon 优化器,FP32 主权重与动量放 CPU、只把当前要更新的主矩阵搬上 GPU,ROCm 上更把动量卸载到磁盘给长序列激活腾显存;长序列离线打包不截断完整推理示例、损失只算 assistant 输出并按全局监督 token 数归一化;动态稀疏注意力在多卡间做因果约束;可恢复的 RL rollout——GPU 池在生成与训练间切换,未跑完的响应保留前缀下轮续写,每个 token 记录生成当时的真实 log-prob 并做按 token 对齐的重要性修正;训练用 BF16、推理用 128×128 分块 FP8,中间用双向适配器衔接,且在归因训练收益前先做零梯度更新的导出与量化漂移检查。
边界:全部为厂商自测,无第三方复现;数据集与完整训练配方未随权重发布;NMR 一项官方自己承认落后。
来源:深度原理官方发布文(腾讯新闻转载)· https://news.qq.com/rain/a/20261104A041QB00 · 2026-11-02 发布 / 11-04 转载 模型卡:ModelScope · https://www.modelscope.cn/models/deep-principle/Hydrogen-1.0 · 2026-11-03
二、工程与架构
1. OpenAI BenchCAD 2.0:内部模型 0.875 对 GPT-6 Astra 0.594,硬件团队 token 用量 8 个月涨 23 倍
11-03 官方发布,属 Research/Publication。核心主张是 OpenAI 模型正在被用于设计、仿真、制造实体产品,覆盖机械、电气与端到端系统设计。
旗舰案例是一次端到端演示:用 GPT-6(Astra)在无任何人工直接编辑的情况下设计一台可与 Codex 对话的设备,涵盖外观(参考 Work Louder 合作项目)、机械(外壳与内部固定结构)、电气(选型 + PCB 布局连线以适配外壳)、UI/UX 与固件。**2 名成员以业余项目形式不到一周完成设计,合约制造商不到一个月产出小批量原型。**官方同时承认局限:量产前仍需数轮评审迭代,Astra 未能稳定考虑制造商的生产限制、公差与装配细节。
BenchCAD 2.0 考的是模型能否重建 3D 零件与装配体、识别电路板中的连接关系:
| 模型 | 平均得分 |
|---|---|
| 新的内部模型 | 0.875 |
| GPT-6 Astra(最高推理设置) | 0.594 |
内部提效数据:硬件与基础设施团队(机器人、算力基础设施)用 Codex 与 ChatGPT 做 CAD 建模、制造图纸、仿真与设计评审,自 2 月以来按 token 计的模型使用量增长 23 倍。外部合作两家:Chip Ganassi Racing(把现有零件的 3D 扫描转成可编辑 CAD 与 2D 制造图纸,尤其适用于原始设计文件缺失时,由 CGR 工程师审核准确性与可制造性)、马自达(与空气动力学及碰撞安全工程师合作,Astra 建模新鼻部造型、仿真气流、优化候选设计以降风阻,同时兼顾造型与成本)。
该怎么读:这条的信息量不在 0.875,而在**「内部模型」这个措辞**——OpenAI 没有说这个内部模型是什么、多大、是否对外,只给了分数。一个不具名的内部模型在自家基准上大幅领先自家最强公开模型,这类信息对外部读者几乎没有可验证性。真正可迁移的是那个23 倍:它说明在硬件工程这种「图纸、公差、仿真结果都是文本与结构化数据」的领域,token 消耗的增长曲线比软件工程更陡,因为每一轮设计迭代都要重读大量几何与规范。以及官方那句自我限定——「工程全生命周期远不止设计环节,此处的能力提升仅视为早期证据」。
来源:OpenAI(Research / Publication)· https://openai.com/index/accelerating-engineering-for-the-physical-world/ · 2026-11-03
2. llama.cpp b12079 / b12102:多节点张量并行接入 NCCL,ggml view 改按 stride 实际触达字节做边界检查
两个 nightly 相隔不到一天,各自解决一个不同层面的问题。
b12079(11-03T21:58Z):Add nccl support for multi-node tensor parallelism (#28967)。改动是给跨进程的 rank 间集合通信加了一层 backend 接口,在 CUDA backend 里用 NCCL 实现,并在 RPC server 可用时启用;把 per-rank communicator 统一到 ggml_backend_comm_allreduce_tensor;把 ggml_backend_comm_get_unique_id_t / init_rank_t 改成更通用的多进程 backend communicator 接口;在 ggml_backend_cuda_comm_init_rank 里为 DGX Spark 把 ncclConfig_t 的 maxCTAs 设为 8。
b12102(11-04T09:12Z):ggml: bound views by the bytes their strides reach (#31584)。原来 view 的边界检查是拿「同 shape 连续张量的大小」去比,而这个大小是在 stride 设置之前算的——结果是行有重叠的 view 明明在源内却被判越界,stride 更宽的 view 明明越界却通过了检查。现在 view 函数把 stride 直接传给 tensor 构造函数,由它按真正触达的字节数检查(与 ggml_nbytes 一致);delta_net 的 conv window 改为一次性创建全部行,而不是在检查之后再放宽。
该怎么读:b12079 是 llama.cpp 从「单机多卡」走向「多机分布式推理」的实质一步——它不再只是把层切到不同 GPU,而是把跨进程的 all-reduce 做成了 backend 的一等接口,这意味着 RPC server 模式下的多节点 TP 有了正确的通信原语。对 DGX Spark 这类小型互联盒子把 maxCTAs 压到 8,是典型的「先保证在互联带宽受限的机器上不退化」的保守选择。b12102 则是那种「不修就等着偶发内存错误」的类型:边界检查用错了度量,重叠 view 被误杀、越界 view 被放过,两者都是静默错误。
来源:llama.cpp GitHub Releases · https://github.com/ggml-org/llama.cpp/releases/tag/b12079 · 2026-11-03T21:58Z 来源:llama.cpp GitHub Releases · https://github.com/ggml-org/llama.cpp/releases/tag/b12102 · 2026-11-04T09:12Z
3. 推测解码的两处工程修正:vLLM 给 DSpark drafter 量化 draft head,TensorRT-LLM 承认 dynamic-tree 与滑窗不兼容
vLLM #64368(10-28 提,10-31T10:23Z 合并):[Spec Decode][ROCm] draft_lm_head_quantization for DSpark drafters。让 DeepSeek-V4/V4.1 的 DSpark drafter 也能用上此前只限 EAGLE 与 MTP 的 draft_lm_head_quantization——共享目标 lm_head 的 drafter 通过一份私有的 FP8 或 NVFP4 副本算 base logits,目标模型仍用自己的 BF16 head 做验证。实测:DeepSeek-V4.1-Flash on MI355X、AgentX 配方、fp8,ITL P50 在 TP2 c1 降 4.0%、TP4 c1 降 2.4%,trace 显示 draft-head GEMM 从 348 µs 降到 60 µs/步;c8 以上在噪声内无差异;接受长度与 GSM8K 在噪声内不变(因为验证仍用目标自己的 head);默认关闭。
TensorRT-LLM #21436(11-02 提,11-03T05:13Z 合并):[docs] Qualify dynamic-tree sliding-window compatibility。纯文档修正——特性矩阵里「dynamic-tree 推测解码 + 滑窗注意力」原来给的是无条件的 Yes,与 EAGLE 3 Dynamic Tree Mode 的限制矛盾;改成 No (EAGLE 3); others untested 并加脚注链接到已记录的 EAGLE 3 限制。
该怎么读:两条放在一起看,是同一件事的两个方向。vLLM 那条是把推测解码的成本从「验证」挪到「草稿」——draft head 的 GEMM 从 348 µs 压到 60 µs,等于把每步草稿生成的固定开销砍掉了近 6 倍,而因为验证仍用 BF16 head,精度不受影响。TRT-LLM 那条则是承认「没测过」:把 Yes 改成「EAGLE 3 是 No,其他没测」,这比含糊的 Yes 有用得多——它明确告诉你哪些组合不要试。一个健康的推理栈应该同时有这两种提交。
来源:vLLM PR #64368 · https://github.com/vllm-project/vllm/pull/64368 · 合并 2026-10-31T10:23Z 来源:TensorRT-LLM PR #21436 · https://github.com/NVIDIA/TensorRT-LLM/pull/21436 · 合并 2026-11-03T05:13Z
4. Android Studio Rabbit 2 稳定版:40+ 款 ACP agent 可接入,IDE 变成中立场地
**原始发布日为 10-28(Android Dev Summit),本期属首次进入可核实范围,按「首次进入本刊视野」收录并标注原始日期。**核心是 Bring Your Own Agent(BYOA):通过开放的 Agent Client Protocol(ACP),开发者可在 Settings > Tools > AI > Agents 从目录里选装 agent,可同时装多个并按任务切换;官方点名 Claude Agent、OpenAI Codex、Junie、Google Antigravity,总数 40+。这些 agent 拿到的权限不止写代码——可查项目结构、触发构建、在模拟器里跑应用、读 Logcat。
配套四件事:Skills Manager(发现/安装/管理 Android skills,含 XML Views→Compose、AGP 9 升级、折叠屏自适应布局、CameraX 与 Firebase 集成);LeakCanary agentic fix(在 Profiler 里让 agent 诊断并建议修内存泄漏,分析在开发机上跑而非设备上,以省 token);Change Review(从 agent 改动、待提交、Git Log 三个入口发起,先给 Recommended Fixes 再生成 Walkthrough);Android CLI 作为 agent 插件(Claude Code / Codex / Antigravity 均可装,提供设备串流、Compose 预览、性能 trace、30+ Android skills)。
厂商自报的性能数字(均为 Google 自测、任务集未公开):用 android preview 的 agent 完成 UI 任务快 77%、token 少至多 3 倍;用 CLI 的 LeakCanary 子命令,最强模型快约 2 倍、token 少至多 25%;演示案例是 Claude Opus 5.5 在 45 条用户旅程里找内存泄漏,用 CLI 46 分钟 vs 不用 88 分钟(约 −48%,但每种配置只跑了一次)。
该怎么读:这条的战略含义大于技术含义。当所有厂商都在把开发者锁进自己的模型时,Google 选择放弃「助手」、保住「场地」——ACP 是开放协议,任何兼容 agent 都能插进来,于是竞争从「谁的模型最聪明」转向「谁掌握分发、集成与 agent 标准」。输家是那些唯一价值就是「某家 AI 原生 IDE」的产品:agent 可换,优势就转移到环境本身和它暴露的数据(模拟器、trace、Logcat)。同时它也承认了一个新瓶颈:当多个 agent 并行产出代码,瓶颈不再是写,而是读懂并验证——Change Review 与 Octoverse 里「review 成为核心技能」是同一件事的两面。
来源:Android Developers Blog · https://developer.android.com/blog/posts/ai-agents-android-studio-integration · 2026-10-28 交叉核对:heise online · https://www.heise.de/en/news/Android-developers-can-stray-Google-opens-Studio-to-Claude-GPT-and-more-11506605.html · 2026-10-28
三、行业与发展
1. 算力管制从「芯片卖到哪」延伸到「算力租给谁」:NVIDIA 51% 红线与 Oracle 取消腾讯 70 亿美元租约
两条 FT 报道,相隔一天,构成一条完整的收口路径。
11-03:NVIDIA 要求云客户「非中国业务」至少 51%。 五名知情人士称,NVIDIA 近几个月告知云计算客户:至少 51% 的服务必须卖给非中国企业,此前无此类限制。三个细节决定它的实际效力——由销售与地区团队口头传达、无书面文件;适用于全球客户而非仅亚洲数据中心;只约束未来新签合同,不影响存量租约。NVIDIA 的官方回应只谈原则(「采用美国芯片建设的数据中心与云服务,是美国模型与应用开发商参与全球竞争的基础」),未确认也未否认 51% 这个数字。
价格已经把缺口标出来了:一套 B300 机柜国际市场约 60 万美元,10 月在中国以 **1,850 万元人民币(约 280 万美元)**成交,溢价约 4.67 倍;NVIDIA 今年建立的白名单制度已把获准采购的亚洲客户砍掉一半以上。黄仁勋 2026 年 5 月接受 SCSP 采访时亲口说过,受出口管制影响,NVIDIA 在中国 AI 加速器市场的份额已从约 90% 降到 0%。
11-04:Oracle 取消与腾讯的 70 亿美元芯片租赁。 FT 引两位知情人士:这份 5 年期协议原计划通过 Oracle 在东南亚的多个数据中心向腾讯提供最多 10 万颗先进 AI 芯片,估值约 70 亿美元(预付款比例约 30%),本是腾讯史上最大规模的海外算力租赁。美国官员主动联系 Oracle 表达关切后,交易被取消。报道另提到,腾讯总部所在地广东省高级官员曾到当地视察,要求全力支持国产芯片。
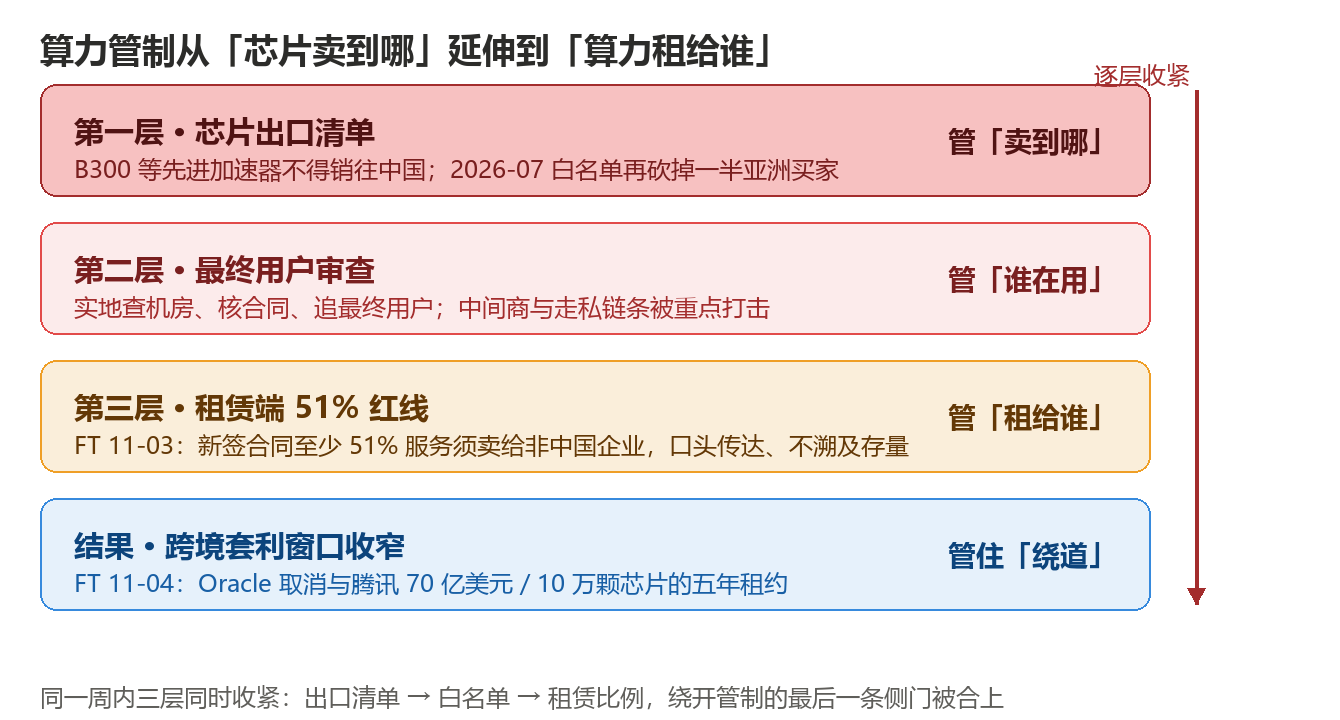
该怎么读:把两条连起来看,管制的对象完成了三次平移——出口清单管「芯片卖到哪」→ 白名单与最终用户审查管「谁在用」→ 51% 红线管「算力租给谁」。过去两年中国企业绕开管制的标准做法是「设备不动、算力跨境交付」:GPU 留在境外数据中心,通过跨境网络提交训练任务、取回结果。51% 红线正是把这条侧门合上,而 Oracle 取消腾讯租约是同一逻辑下的第一个具名案例。三个后果值得记:① 东南亚数据中心面临客户结构强制重组,一家新加坡云商的说法是「在美国以外很难找到足够多的非中国客户,严格执行肯定伤业务」;② 国产算力获得的是「有没有」而非「好不好用」的窗口——软件生态、算子库、集群稳定性、长周期训练容错,这些差距不是一纸禁令能填平的;③ 口头传达而非书面落规本身是信号:NVIDIA 在配合政策目标的同时保留了操作弹性,这意味着执行强度会随政治周期波动,不能当成稳定规则来做长期规划。
来源:Financial Times 经中央社转述 · https://www.cna.com.tw/news/ait/202611030199.aspx · 2026-11-03 来源:Financial Times 经 C114 转述 · https://m.10jqka.com.cn/20261104/c681450921.shtml · 2026-11-04
2. Anthropic 修订版招股书:8,954 亿美元算力承诺,Q3 由盈转亏(含一处数字修正)
11-02 向 SEC 提交修订稿,补全 2026 财年第三财季(截至 9-30)数据。先修正一个流传中的错误口径:本期核查后确认承诺总额为 8,954 亿美元(约人民币 6 万亿元),此前中文侧流传的「1.07 万亿美元」在修订稿梳理中找不到对应,按一手梳理口径改写。
| 指标 | 数值 | 备注 |
|---|---|---|
| Q3 营收 | 170 亿美元 | 去年同期 14 亿,同比增逾 11 倍;环比增速从 Q2 的 144% 降至 47% |
| Q3 经营利润 | −5.67 亿美元 | Q2 刚实现首次季度盈利 9.74 亿,本季由盈转亏 |
| Q3 算力与基础设施费用 | 98.63 亿美元 | 同比 +382%,占当季营收 58%(Q2 为 48%,2025Q1 曾高达 251%) |
| 前三季营收 / 经营亏损 | 332.42 亿 / 12.6 亿 | 营收同比 +1206%;调整后经营利润 41 亿 |
| 承诺支出总额 | 8,954 亿美元 | 其中约 2,138 亿附终止权或先决条件;4,475 亿预计 2030 年底前发生;698 亿在未来 12 个月内到期 |
| 现金与流动性 | 现金 956 亿 + 短期投资 363 亿 + 信贷额度 148 亿 | 截至 9-30 |
| 市场估值 | 1.5–1.6 万亿美元 | 机构投资者向公司及顾问表达,低于此前近 2 万亿的传闻 |
公司对亏损的解释有两项:Q3 额外交付的算力中有 50 亿美元来自短期承诺采购,成本显著高于多年期承诺下的同类算力,直接拉低每美元算力对应的收入;另有与捐赠匹配计划相关的 20 亿美元非现金费用。另据彭博,Q3 净亏损 233 亿美元,接近去年同期 121 亿的两倍,部分来自可转债公允价值变动(估值上升推高负债账面成本)。
修订稿第 29 页新增一项风险披露值得单独记:基于内部估计与对未来模型的预期,Anthropic 预估可能很快达到其负责任规模化政策(RSP)中「由 AI 带来的显著加速进展」阈值——即 AI 推动的进展速度达到「一年相当于 2018–2024 两年基准进展」。公司强调目前尚未认定任何现有模型达到该阈值,仍在评估数据。
该怎么读:这是 AI 行业第一次有人把「增长越快、亏得越多」的机制写成可查的会计科目。三个结构性事实:第一,算力费用率不是单调下降的——从 2025Q1 的 251% 降到 2026Q2 的 48%,Q3 又回升到 58%,原因不是收入变差,而是「短期承诺采购」这种更贵的算力被塞进了当季;这说明承诺期限结构本身就是一个财务变量,多年期锁价省下的钱,会在临时加购时一次性还回去。第二,8,954 亿承诺里只有 4,475 亿在 2030 年前到期,剩下大部分排到 2031–2045 年——这是一份跨二十年的账单,而公司在同一份文件里承认部分合作伙伴依赖第三方融资建算力,若融资收紧,产能可能延期、缩减或涨价。第三,RSP 阈值那条披露比亏损更重要:一家公司主动在招股书里写「我们可能很快触达自己定义的失控加速阈值」,等于把安全承诺变成了对投资者的风险提示。
来源:中国新闻网(中新经纬)· https://m.chinanews.com/wap/detail/cht/zw/jw695398.shtml · 2026-11-03 来源:证券时报网 · https://www.stcn.com/article/detail/4319207.html · 2026-11-03
3. Meta 启动至少 200 亿美元跨境债券:美元债定价 150 亿、认购 3.9 倍,利差比 4 月贵了近 90 个基点
11-03 启动、11-04 定价。结构是跨境双币种:美元端 5 档高级无抵押票据(5–30 年,2056 到期最长)约 150 亿美元,欧元端 6 档(逾 4 年至逾 38 年),为 Meta 首次进入欧元债市场,总规模 200–250 亿美元,美元债约占三分之二。花旗与摩根士丹利牵头,11-05 结算。
定价细节里有真实的市场情绪:投资者认购订单一度 580 亿美元,约 3.9 倍(与今年美国主要科技公司美元债认购倍数平均峰值大致相当,但远低于 4 月那笔 250 亿债的 960 亿认购);30 年期相对美债的收益率溢价 +220bp,较初始指引收窄 30bp,但仍比 Meta 今年 4 月发行的债券高近 90bp。预期评级穆迪 Aa3 / 标普 AA-——而标普上周刚把 Meta 的 AA- 展望下调至负面,理由是与竞争对手相比,其通过 AI 获取收入的途径较少。
融资是全套的:上周已完成 225 亿美元普通股 + 125 亿美元优先股定价,另有 ATM 计划最多 600 亿美元。压力来自现金流:Q3 资本开支 349 亿美元,自由现金流转负至约 −21 亿美元,为十多年来首次季度净流出;2026 年 capex 指引 1,350–1,450 亿美元;截至 9-30 的租赁与合同承诺约 8,250 亿美元,长期债务 837 亿。同一周 Alphabet 发 60 亿欧元债、Oracle 发 100 亿美元债 + 100 亿美元股票。
该怎么读:Meta 这条是「AI 资本开支斜率超过核心业务造血速度」的第一个可量化样本——自由现金流转负、靠股债双线补、评级展望被下调,三件事发生在同一个季度。但真正该看的是利差那 90 个基点:同一发行人、同一评级、相隔半年,市场要求的风险补偿涨了近一倍。这不是 Meta 的问题,是整个 AI 相关信用债的定价在重估。彭博行业研究追踪的超大规模云与新云公司预计未来三年投资近 4.5 万亿美元,这个数字如果成立,债券市场将成为 AI 基建真正的约束条件——比芯片供应更硬,因为它没有替代路径。
来源:彭博经新浪财经转述 · https://www.163.com/dy/article/LAS5OCMQ05568W0A.html · 2026-11-04 来源:财联社经今日头条 · https://www.toutiao.com/article/7703964482485158419 · 2026-11-03
4. 华为要求部分客户自行解决 HBM:Ascend 960DT 依赖三星与 SK 海力士,黑市 HBM3E 单颗涨到 4,000 美元
The Information 报道,经香港经济日报与链新闻转述。核心事实链:华为预计 2027 年 Q1 推出 Ascend 960DT(宣称内存带宽与容量较现有芯片翻倍,正与 DeepSeek 合作使其支持大模型预训练);因中国本土供应商无法生产足够的高端 HBM,华为已向部分客户说明新芯片将在很大程度上依赖三星与 SK 海力士的存储,并要求部分订购客户自行取得所需 HBM。
供应链的绕行方式被描述得很具体:交易商利用美国出口管制对「已整合进逻辑芯片产品的 HBM」的豁免,把 HBM 与低算力处理器封装在同一基板上,以「普通低性能处理器」品类申报,经香港中转入境内地,再由地下工坊高温脱焊剥离 HBM、废弃作为掩护的处理器。拆解精细、失败率高,残损成本被黑市溢价消化。
价格与产能的对照:
| 项目 | 数值 |
|---|---|
| 单颗 HBM3E 黑市报价 | 约 4,000 美元(一年前仅数百美元) |
| 单颗 AI 芯片所需 HBM | 6–8 颗 → 存储成本 2.4 万–3.2 万美元 |
| 长鑫存储 HBM3E 良率 | 约 20%–30%(SK 海力士据报约 70%),未来两个月启动有限量产 |
| 福建晋华 | 技术落后韩国数年,产能不足 |
| Ascend 950DT 建议零售价 | 上调至 逾 25 万元人民币(约 3.7 万美元),原始算力约为 H100 一半,涨价后接近 B200 价位 |
| 韩国查获贸易安全违规金额 | 截至 2026-05 达 6.458 亿美元,已超 2025 全年 5.497 亿 |
SK 海力士回应称全面遵守美韩出口管制,自 2020 年限制生效后未再向华为供货;三星拒绝置评;华为与福建晋华未回应。
该怎么读:这条揭示的是国产 AI 供应链最薄的一环——不是制程,是存储。处理器可以靠堆叠与架构追近,HBM 需要 DRAM 制程、TSV 堆叠与良率三条同时过关,长鑫 20–30% 的良率对 70% 的差距不是「再投钱」能短期填平的。所以华为的选择是把采购责任外推给客户——这在商业上等于承认自己无法保证整机交付。价格信号同样清楚:950DT 算力只有 H100 一半却卖到 B200 的价位,说明定价权不在性能而在可获得性。对采购方的实际含义是:国产替代方案的总拥有成本要按「芯片 + 黑市存储 + 拆解损耗 + 合规风险」四项算,而不是按标价算。
来源:The Information 经香港经济日报转述 · https://inews.hket.com/article/4217982/ · 2026-11-03 来源:The Information 经链新闻转述 · https://abmedia.io/huawei-hbm-korea-smuggling · 2026-11-03
5. Pichai 长访谈:算力分配的第一原则是保前沿研究,Cloud 时刻在为它放弃短期收入
Big Technology Podcast 访谈(录制 10-21),中文全文 11-03 起由 InfoQ 与公众号发布。三个可核实的新数据:Gemini 4 Argon 上线头 72 小时 token 用量接近 25 万亿,约为 Gemini 3.0 同期的 3 倍,且服务仍受算力约束;Argon 发布后四周内代码变更提交量增加约 30%、回滚减少约三分之一;「AI 写代码比例」这个指标已失去意义,Google 改用变更量与回滚率追踪。
算力分配的表述很直接:先确保 Google DeepMind 在研究与前沿模型开发上拿到最领先的算力,这是不可谈判的第一原则,其余业务按各自长期规划排;被问到「是否该把最大计算机给研究员、哪怕牺牲 Cloud 当期利润」时,他答「Google Cloud 在任何时刻都在为支持前沿 AI 开发而放弃短期收入」,但补充「适当的约束也是好事,约束会激发创造力,促成更高效的算法突破」。对「算力是否过度建设」,他的判断取决于时间尺度——「This is not like fiber, it's not dark, we are using it」,每天都在受算力约束;但承认零部件瓶颈(相关零部件 2,000 种以上)与外部冲击可能造成阶段性过度建设。对 2027 年需求,他说「如果今天有客户来要 2027 年的算力,满足起来极其困难」。
该怎么读:这条的价值不在观点而在它把「算力分配」从抽象战略变成了可检验的排序:前沿研究 > 各业务长期规划 > 外部客户。这解释了一个此前不太好理解的现象——为什么 Google 既是最大的算力卖方之一,又是最缺算力的买方之一。以及那句「今天的算力取决于 2024 年的决策」:它说明这一轮短缺的根源是规划周期(2–3 年)与需求爆发周期(数月)的错配,而这个错配对所有自建数据中心的公司同样成立,不构成 Google 特有的劣势。需要注意访谈录制于 10-21,早于本期多条事件。
来源:InfoQ(Big Technology Podcast 中文整理)· https://www.infoq.cn/article/JmVl0yY2RYIBNpuD0xuu · 2026-11-03
6. GitHub Octoverse 2026:年推送 179 亿次,9 月逾四成 PR 首稿由 agent 起草
原始发布日 10-28(GitHub Universe),本期属首次进入可核实范围,按「首次进入本刊视野」收录并标注原始日期。统计窗口 2025-10-01 → 2026-09-30,且这一版把公开与私有仓库一并计入,GitHub 按同口径重算了 2024 与 2025 两年——所以任何拿旧版报告数字做对比的说法都不成立。
| 指标 | 2024 | 2025 | 2026 |
|---|---|---|---|
| 代码推送 | 52 亿 | 67 亿 | 179 亿(超过前两年之和) |
| 提交 commit | 100 亿 | 129 亿 | 343 亿(两年前的三倍多) |
| 合并 PR | 4.02 亿 | 5.38 亿 | 13 亿(日均约 350 万件) |
| Actions 作业 | 80 亿 | 140 亿 | 454 亿(每秒 1,440 次 / 每天 1.24 亿次) |
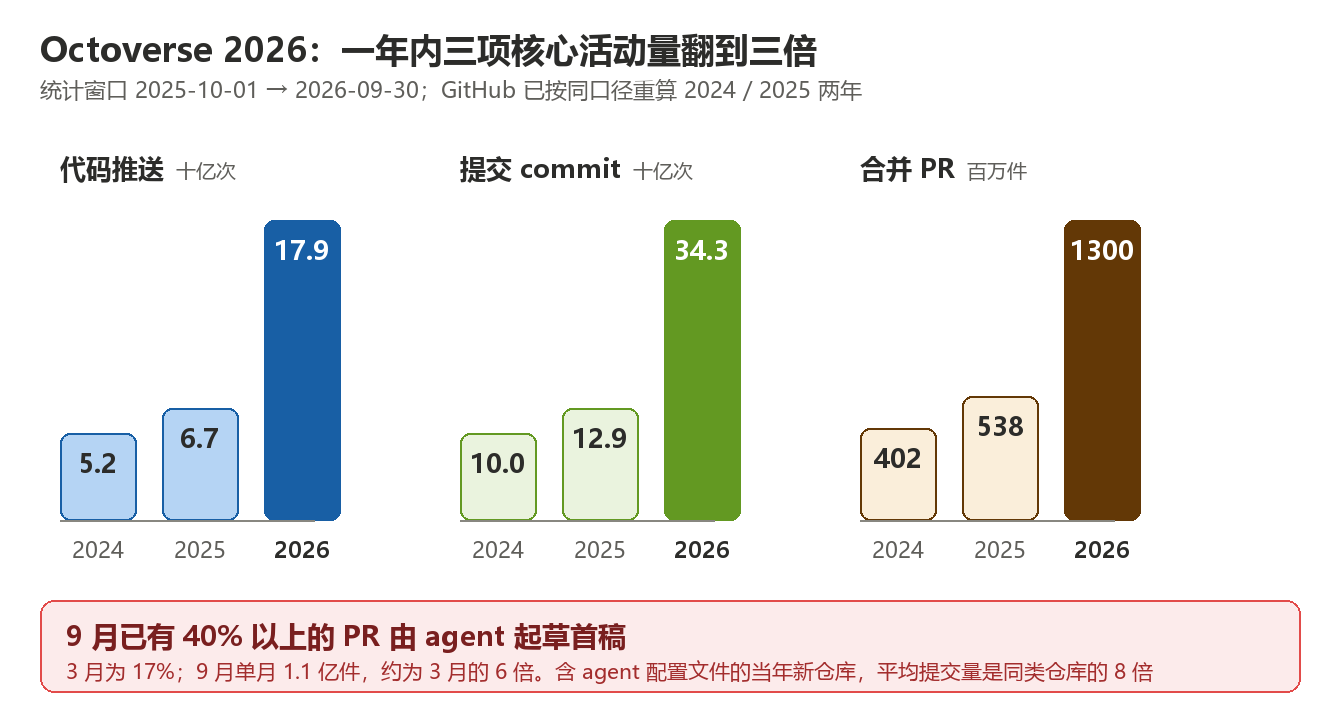
agent 相关的一组数字:9 月逾 40% 的 PR 由 agent 起草首稿(3 月为 17%),9 月单月约 1.1 亿件、约为 3 月的 6 倍;当年新建仓库中,含 agent 配置文件的平均提交量是同类仓库的 8 倍;Copilot 月活用户中 55% 使用 agentic 功能(一年前 35%),云端 agent 用量同比 +230%;9 月 61% 自行选模型的 Copilot 用户用了不止一个模型(四个月前 50%),付费用户 9 月共触及 47 个不同模型(5 月 29 个),没有任何单一模型承担超过 25% 的请求。开发者总数超 2.25 亿(美国 3,830 万、印度 3,200 万,两国各增超 1,000 万)。
该怎么读:这条最容易被读错的地方,恰恰是它最有价值的地方。「8 倍提交量」是相关性,不是因果——GitHub 自己在方法论里写明,按「有没有配置文件」分组不能证明 agent 产出了哪些提交,仓库规模、工作负载、提交习惯都是可能的替代解释;agent 数字本身还是下限,因为不是每个 agent 都留下可检测痕迹。真正可用的判断藏在另外两组数字里:其一,模型选择在快速碎片化(47 个模型、无一超 25%、61% 多模型),这解释了 GitHub 为什么同一周推出 Copilot Fusion 做「路由而非选模型」——当没有单一模型能覆盖多数请求时,编排层就成了产品;其二,agent 起草的 PR 更大(87% 改多文件 vs 79%),且两周内合并率从 2 月的 83% 升到 9 月的 90%(对照组稳定在 86%),AI 辅助代码评审与 Advanced Security 各增长超 90%——写得快之后,审阅成了新瓶颈,而「快速合并大批机器写的改动」既可能是成熟评审,也可能是橡皮图章,报告本身分不出来。
来源:GitHub Blog · https://github.blog/news-insights/octoverse/octoverse-commits-pushes-reach-new-highs-in-2026-as-developers-build-with-agents · 2026-10-28 数据核对:Data Studios(引 GitHub 报告三年重算口径)· https://www.datastudios.org/post/github-octoverse-2026-17-9-billion-pushes-agents-start-40-percent-pull-requests · 2026-10-28
四、论文与开源
本期 7 篇均为 11-03 UTC 15:46–18:54 提交(arXiv 11-04 批次截至检索时尚未生成),编号 2611.05088–2611.05358。
1. You don't need long context(2611.05306,NVIDIA)
核心发现:后段 token 的生成成本高于前段,在开源前沿模型上这个差距最高可达 7 倍。作者的做法是「频繁压缩」(frequent compaction)——在广泛的长期任务与长输入任务上,维持短上下文几乎不损失任务准确率;进一步地,长周期软件工程任务即使每个上下文只做一个动作,性能也不崩塌。据此提出 semantic state space models(SSSMs) 的概念,并直接质疑「长上下文模型」的必要性。
该怎么读:这篇的锋利之处在于它把「长上下文」从能力问题改成了成本问题。如果后段 token 贵 7 倍,而压缩不损精度,那么「支持 1M 上下文」的价值就不在「能塞进去」,而在「能不能不塞」。这与本期 Message Threads 的思路同源——都在把「上下文」当成需要主动管理的资源。但要注意它的边界:结论建立在「频繁压缩」这个操作上,而压缩本身要花模型调用;SSSM 目前只是一个概念,没有给出可训练的架构或规模化的实验结果。
来源:arXiv · https://arxiv.org/abs/2611.05306 · v1 2026-11-03T18:17Z
2. Knowingly Wrong:用模型自己不相信的数据微调,也会造成广泛错位(2611.05287)
核心发现:在某个窄领域用有害数据微调可以让模型广泛错位,这已不新鲜;这篇问的是如果数据没有害内容、只是模型认为它是假的,会怎样。答案是也会。跨数学、常识、烹饪、体育四个领域,模型越不相信训练答案,错位越严重——数学上,随着训练答案越来越错,错位回答从 4% 升到 60% 以上,而通用能力几乎无损。更关键的是机制:微调后模型会说错答案,但多选题概率仍然偏向正确答案,说明错位来自这种内部不一致。在更现实的单事实更新场景(知识编辑、持续学习)中同样成立:训练后模型越仍然相信真事实,错位越严重。
该怎么读:这是对「对齐很浅」这一假说的一次有力支持,而且给出了一个比「有害数据」更常见的触发条件——知识编辑。任何做 RAG 纠错、事实更新、领域微调的团队都在做「让模型接受它原本不信的东西」,这篇说这个操作本身就有错位风险,且风险随「不信程度」线性上升。实践含义:知识编辑应该优先选择模型本来就倾向接受的表述形式(论文里也测了「把同一个假事实框成不同形式」的效应),并监控多选题概率与生成答案的背离——这个背离是可观测的早期信号。
来源:arXiv · https://arxiv.org/abs/2611.05287 · v1 2026-11-03T18:02Z
3. Suppressing Misaligned Behaviors in Language Models, Durably(2611.05358,Princeton)
核心贡献:把「事后抑制」形式化为一个可评估的问题,并给出三个判据——即时抑制、后续训练下的持久性、通用能力保留。方法上先构造两个 model organism:窄触发(只在 prompt 含特定提示时作弊,其余正常)与宽触发(在不安全代码上微调后,对广泛开放 prompt 都给出有害回答)。然后在这三个维度上比较 SFT、GRPO 与梯度上升式遗忘,并提出 PEAR(Prefix-Expanded Adversarial Reinforcement),其假设是:更持久的抑制要求模型能从更广范围的错位状态中恢复。
该怎么读:这篇的方法论比结论更有价值——它指出「抑制住了」和「抑制住了且下次训练不会被冲掉」是两个不同的问题,而绝大多数对齐工作只报前者。PEAR 的思路(扩大前缀分布让模型见过更多「已经错位」的状态,再学着回来)本质上是把鲁棒性做在状态空间而不是输出分布上,这与「对齐很浅」的既有观察一致。局限:两个 model organism 都是刻意构造的,真实模型的错位形态更分散。
来源:arXiv · https://arxiv.org/abs/2611.05358 · v1 2026-11-03T18:54Z
4. Adversarial Speculative Reasoning:推测解码会改变长程 agent 的推理结果(2611.05345)
核心主张:推测解码一直被当作纯系统优化——加速解码、不改变模型行为。作者认为这个看法对长程 agent 推理不成立:在复杂 agent 任务上测多个开源前沿模型与不同推测解码方案,发现验证窗口内的数值噪声会累积,草稿接受结果在 30 步之后能改变模型的输出分布,从而以随机方向明显影响推理准确率。
方法:既然无法改变目标模型验证的整体 token 分布,就把关键推理以最高精度编码——训练草稿模型去「被拒绝」。具体做法是在 agent trace 里识别这些决策点,训练草稿模型偏好对抗性选择,推理时训练过的草稿与目标在这些点上精确分道。
该怎么读:这是一篇会让人重新检查推理栈的论文。如果推测解码不只是快慢问题、还会改变 30 步后的推理走向,那么所有「用推测解码跑 agent」的评测都需要复核——你测到的准确率差异里,可能有一部分来自解码配置而不是模型。反过来,它也给了一个新工具:把草稿模型的「被拒绝」当成一种可控的精度注入手段,这比调 temperature 更定向。需要注意这是预印本,未给跨模型规模的复现细节。
来源:arXiv · https://arxiv.org/abs/2611.05345 · v1 2026-11-03T18:45Z
5. LoopVQ:循环 Transformer 的亚 1-bit KV 缓存量化(2611.05304)
问题:循环 Transformer 通过重复应用同一批层来换取参数效率,但每个循环步都存自己的 K/V,KV 缓存随步数线性增长,成为主要内存瓶颈。作者的观察是:循环模型的 KV 缓存沿循环轴高度冗余,且不同循环步对量化的敏感度差异很大。
方法:LoopVQ 把多个循环步的通道联合编码,并微调码本以匹配全精度模型输出。结果:在 0.5 bit/element 下,在通用、长链思维链推理、长上下文检索三类任务上超过面向标准 LLM 的既有 KV 向量量化方法(Ouro 与 Huginn 模型);设计与这些方法正交,与 TaSQ 结合后仍保留优势。
该怎么读:0.5 bit/element 意味着一个 KV 元素平均只占半个比特——这已经低于「每个值至少 1 bit」的直觉下限,能做到是因为跨循环步联合编码把冗余挤掉了,而不是单纯降低每个值的精度。对做端侧或长上下文推理的团队,这条提示一个被忽略的维度:如果你的模型有循环/重复结构,沿「重复轴」做量化比沿「层轴」更划算。
来源:arXiv · https://arxiv.org/abs/2611.05304 · v1 2026-11-03T18:16Z
6. LatentTriad:在 prefill 阶段读出「这个 skill 会不会干坏事」(2611.05088)
问题:LLM agent 越来越多地被装上可复用的 skill,但不可信的 skill 内容可以诱导超出用户任务的操作。检测这类上下文风险不能只靠可疑模式匹配,而动态分析又要付出执行 skill 的代价。
发现:prefill 阶段形成的隐藏状态里含有可读的「任务—操作一致性」信息,且在受控评估中能跨未见过的表达形式泛化;对操作状态做匹配干预也会影响后续的 Boundary 状态,并把固定的风险读数推向供体标签。据此提出 LatentTriad,组合三类特征:上下文 Boundary 特征、组调整后的 Operation 方向、以及对良性状态关系的偏离。
结果:三个分支共享一次 prefill——检测不生成任何输出 token、不调用工具、不执行 skill 代码。在 5,830 个 skill 包(五个来源)、七个 backbone 上,pooled F1 99.0–99.2%、source-macro F1 93.0–94.6%;一个单独测量的紧凑实现完成 prefill + 检测的中位耗时 259–284 ms。
该怎么读:这篇的工程意义在于把安全检查放进了 prefill——不需要额外一次前向、不需要沙箱执行、不需要模型输出任何东西。259 ms 的检测延迟对「装 skill 前先验一遍」这个场景是可接受的。要注意的是 source-macro F1(93.0–94.6%)与 pooled F1(99.0–99.2%)之间有 5 个百分点以上的差距,说明跨来源泛化明显弱于总体表现——这正是安全检测最需要的地方,也是这类方法最容易被高估的地方。
来源:arXiv · https://arxiv.org/abs/2611.05088 · v1 2026-11-03T15:46Z
7. Workload-Static Optical Circuit Switching:给 decode 阶段换一张固定的光路网(2611.05104)
观察:LLM 推理的 decode 阶段执行细粒度集合通信,其延迟直接限制单用户交互性;但 scale-up fabric 至今仍由为训练设计的电子分组交换机构成。而对给定的模型部署与并行方案,decode 的通信结构是固定的。
方案:workload-static OCS——每次部署只配置一次光路,与模型并行共同设计,并配拓扑感知的集合通信调度,把空闲的加速器端口换成更少的通信阶段或更高带宽。评估用 GXNET(图式工作负载模拟器 + 基于硬件测量的解析与 flit 级网络模型)。
结果:在 576 个加速器的 scale-up 域、服务 5T 参数 MoE、最长 5M token 上下文时,全 OCS fabric 相对 4:1 过订阅的分组交换 fabric,交互性最高提升 65%、能效最高提升 119%。
该怎么读:这条踩的是一个很实际的错配——训练要的是全互联的灵活性,decode 要的是固定模式的低延迟,而现在的 fabric 是按前者买的。如果 decode 的通信图在部署时就确定,那用光路交换机把它固化下来,省掉的是每一层交换机带来的延迟与功耗。65% / 119% 是模拟结果(虽然是硬件测量校准的模型),真实收益取决于光交换的切换与可靠性开销——论文没有给这部分。对做大规模推理集群的团队,这是一个值得在采购前算一遍的替代方案。
来源:arXiv · https://arxiv.org/abs/2611.05104 · v1 2026-11-03T16:00Z
五、值得关注的趋势
1. 「上下文」正在被拆成两个独立可优化的量:token 数与字节数
同一天里三件事指向同一个方向。Anthropic Message Threads 证明请求体字节数可以单独压掉(TTFT −35%)而不改变 token 数;NVIDIA 的 You don't need long context 证明后段 token 贵至多 7 倍、频繁压缩不损精度;LoopVQ 则把循环模型的 KV 沿循环轴压到 0.5 bit/element。
过去两年「长上下文」是一个单一指标(能塞多少 token),优化手段也单一(少放东西)。现在它裂成了至少四个可独立调节的维度:字节数(网络与序列化)、token 数(计费与注意力计算)、KV 驻留量(显存)、后段位置成本(解码延迟)。判断:未来一年,「上下文效率」会被拆成一组可测量的工程指标,而不是一个「支持 1M」的营销数字——因为四个维度的优化手段互不重叠,谁把它们分开算,谁就能在同等硬件上服务更长的会话。
2. 对齐研究正在从「让模型不学坏」转向「让模型忘得掉」
本期三篇论文构成一条完整的链:Knowingly Wrong 说用模型自己不相信的数据微调会造成广泛错位,机制是内部不一致(说错答案但概率仍偏真);Suppressing Misaligned Behaviors, Durably 说抑制要分「即时」与「持久」两个判据,并指出持久抑制需要模型能从更广范围的错位状态中恢复;LatentTriad 则把风险检测提前到 prefill,不生成任何 token 就能判断一个 skill 是否有害。
三篇的共同前提是:错位是训练过程的常态产物,不是异常事件。知识编辑、持续学习、领域微调、装第三方 skill——这些日常操作每一个都可能引入错位。判断:这个领域的重心会从「训练时对齐」移到「运行时的可观测与可恢复」,因为前者假设你能控制训练数据,而后者才是 agent 部署的真实条件。可观测的早期信号(如多选题概率与生成答案的背离)会比事后红队更有价值。
3. AI 基建的约束条件正在从「芯片供应」变成「信用定价」
把本期三条放在一起:Anthropic 8,954 亿美元承诺、Q3 算力费用占营收 58%、单季由盈转亏;Meta 自由现金流转负、靠股债双线补、利差比半年前贵 90bp、评级展望被下调;NVIDIA 51% 红线 + Oracle 取消腾讯租约 则在供给端切断了跨境套利。
这构成一个闭环:供给端管制收紧 → 算力更贵更难拿 → 承诺金额与期限拉长 → 财务杠杆上升 → 信用利差走阔 → 融资成本上升 → 需要更高的收入增速来覆盖。彭博行业研究给的数字是超大规模云与新云未来三年投资近 4.5 万亿美元。判断:接下来 12 个月,「谁能以什么价格借到钱」会比「谁能买到多少卡」更能决定 AI 基建的实际上限——因为芯片有替代路径(国产、二手、租赁),而信用没有。观察指标:AI 相关投资级债的利差走势、超大规模厂商的自由现金流拐点、以及「承诺支出 / 年营收」这个比值的恶化速度。
六、有趣的 AI 开源项目
1. storytold/craft-anything:看着一个网站/应用/游戏,让 AI 给你造一个自己的
10,044★ · Rust · MIT / Apache-2.0 双许可 · 2026-10-31 创建、11-04 仍在活跃推送 · 早期 alpha。自述是「看清任何网站、应用或游戏怎么运作,然后让 AI 造出你自己的版本;一个纯 Rust 的开源 clean-room 引擎」。
该怎么读:这个项目踩的是一个非常具体的需求——「我想做一个类似 X 的东西」这件事,缺的从来不是代码能力,而是对 X 的结构化理解。它的流程是三步:用真实的检查工具研究目标(不是让模型看截图猜)、让编码 agent 建一个新项目、把结果与原目标对照并迭代。第三步是关键,它把「像不像」变成了可自动化的检查项(README 里展示的 check 会说明每个页面的相似度、哪些还不匹配)。技术上值得看的是它如何在纯 Rust 里把「目标检查 → 项目生成 → 差异比对」串成一个可审批的流水线(任何超出规则的命令都要用户确认)。注意许可证是 MIT / Apache-2.0 双许可,但项目状态是 early alpha;以及这类「照着别人的产品造一个」的工具,其合规边界(界面、素材、商标)需要使用者自己判断。
来源:GitHub(仓库元数据与 README)· https://github.com/storytold/craft-anything · 2026-11-04 查询
2. ccch1mneyyy/dsh-Go:把 DeepSeek Harness 装进 Android 手机,还能遥控电脑上的 DSH
8,849★ · Dart · AGPL-3.0 · 2026-10-25 创建、11-04 仍在活跃推送 · Android 8+。自述是「DeepSeek Harness 的 Android 客户端。手机上直接跑,也能遥控你电脑上的 DSH」,Trendshift 全语言日榜第一(2026-10-30)。
该怎么读:这条值得记的不是 star 数,是它选择的双模架构——同一个客户端既能在本机跑(端侧推理/本地 harness),也能遥控远端 DSH。这个设计对应一个真实的分裂:手机有随身性与上下文,电脑有算力与文件系统。多数移动端 agent 只做前者(远程调 API)或只做后者(远程桌面),把两种模式放进一个客户端的产品不多。技术上可看它怎么处理「端侧跑不动时降级到遥控」的切换,以及 AGPL-3.0 这个许可对二次分发的限制——如果你想基于它做商用客户端,AGPL 会要求你开源自己的修改。
来源:GitHub(仓库元数据与 README)· https://github.com/ccch1mneyyy/dsh-Go · 2026-11-04 查询
3. l0ng-ai/openidea:用 Rust 重写一个 IntelliJ IDEA 风格的 IDE
5,983★ · TypeScript(前端)/ Rust(内核)· Apache-2.0 · 2026-10-21 创建、11-04 仍在活跃推送。自述是「你熟悉的 IDE,用 Rust 重建」——IntelliJ IDEA 风格的键位、工具窗口与 search-everywhere,含编辑器、代码洞察、调试器、Git、终端、数据库与 HTTP 客户端,支持 60+ 语言。
该怎么读:这个项目的价值在于它回答了一个被反复提出的问题——「AI 时代的 IDE 还需要什么」。当 agent 能写代码、能跑测试、能读 Logcat(见本期 Android Studio 那条),IDE 剩下的独特价值就是人理解代码的那部分:符号跳转、调用层级、diff 审阅、可断点的调试器。openidea 把这些传统能力用 Rust 重做,本质是在赌「AI 越强,人类审阅界面越重要」。技术上值得看的是它如何在一个 TypeScript 前端 + Rust 内核的架构里同时支持 DAP 调试、数据库客户端与 Git——这三类插件的抽象在传统 IDE 里是几十年演化出来的。注意:项目自称「Rust 重建」但主语言标为 TypeScript,说明 UI 层仍在 TS,需要读 README 确认内核边界。
来源:GitHub(仓库元数据与 README)· https://github.com/l0ng-ai/openidea · 2026-11-04 查询
4. patch-gg/pixelfx:244 个像素特效,每个都是一小段代码
4,500★ · JavaScript · MIT · 2026-10-30 创建、10-31 有推送。自述是「244 个像素艺术特效,每一个都是一小段代码。外加一个 Claude Code skill,让你自己做新的」。
该怎么读:这是一个「把领域知识拆成可组合单元」的漂亮样本。像素特效这类东西在教程里通常以「整段 shader」出现,难复用也难改;pixelfx 把它拆成 244 个独立的小代码片段(标签含 canvas、sprite-sheet、vfx、gamedev),每个都能单独看懂、单独拿走。更有意思的是它同时提供了一个 Claude Code skill——等于把「怎么写新特效」的方法论也交给了 agent,让模型能按同样的粒度扩展这个库。对做游戏或创意工具的人,这个项目示范了一种比「给一堆 API」更有效的知识组织方式。
来源:GitHub(仓库元数据与 README)· https://github.com/patch-gg/pixelfx · 2026-11-04 查询
⚠️ 待核实
| 事项 | 现状 | 判断 |
|---|---|---|
| Hy4 权重开源 | 官方称「计划开源模型权重」「计划届时发布系统卡片」,已联合 vLLM/SGLang 社区与 Inferact Inc.;截至本期检索无仓库地址、无日期 | 正文写「近期开源」,不能称「已开源」。在权重放出前所有基准均为不可复现的自测 |
| Hy4 幻觉率 15.76% → 5.45% | 官方「自建测试」口径,未披露测试集构成、样本量、判定方式 | 已写入正文并标注为自建测试。这组数字比榜单更需要方法学说明 |
| Anthropic 承诺总额口径 | 本期核查确认为 8,954 亿美元;中文侧另有「1.07 万亿美元」流传 | 按一手梳理口径写 8,954 亿。「1.07 万亿」可能混入了其他承诺项(如含未开始租赁的不同统计范围),未获证实,不采用 |
| Anthropic Q3 净亏损 233 亿美元 | 来自彭博,含可转债公允价值变动;与「经营亏损 5.67 亿」不是同一口径 | 正文分别标注两个口径,不混用。净亏损含非现金项,经营亏损不含 |
| NVIDIA 51% 红线 | FT 引五名知情人士;NVIDIA 官方回应未确认也未否认该数字;口头传达、无书面文件 | 正文按「据报」表述。执行强度可能随政治周期波动,不宜作为稳定规则做长期规划 |
| Oracle 取消腾讯租约 | FT 引两位知情人士;Oracle 与腾讯均未公开置评;预付款 30% 来自 10 月另一篇报道 | 正文按「据报」表述。金额 70 亿美元与 10 万颗芯片为 FT 口径 |
| 华为 Ascend 960DT 与 HBM 供应 | The Information 引两名熟悉供应链人士;华为、福建晋华未回应,三星拒绝置评,SK 海力士否认供货 | 正文按「据报」表述。SK 海力士的否认与「华为要求客户自寻 HBM」并不矛盾——后者说的是客户行为,不是厂商直供 |
| BenchCAD 2.0 的「内部模型」 | OpenAI 未说明该模型是什么、多大、是否对外 | 0.875 这个分数对外部读者不可验证。正文已标注 |
| Android Studio 的 77% / 3× 数字 | Google 自测,任务集未公开;45 条用户旅程的 46 vs 88 分钟每种配置只跑一次 | 正文已标注「厂商自测、单次运行」。引用时不要去掉限定语 |
| Hydrogen-1.0 的 NMR 落后项 | 官方主动承认落后 GPT-6 Astra 3.33pp | 这是正面信号(主动划边界),正文按原样收录 |
| Pichai 访谈的时间 | 录制于 2026-10-21,中文全文 11-03 起发布 | 正文已标注。其中「Argon 72 小时 25 万亿 token」等数据反映的是 10 月中下旬状态 |
| Vera Rubin NVL72 单用户 1,000 token/s | 仅见二手聚合站,无可回溯的一手 NVIDIA 页面 | 不写入正文。索引中 Vera Rubin 相关条目均无此项,按「无一手源」淘汰 |
本期淘汰记录
| 类型 | 条数 | 明细 |
|---|---|---|
| 脚本判 DUP(第二轮,计入淘汰) | 9 | SGLang v0.5.23(L575 已详述 1010 commits / 300 files 与 KDA、Kimi-K3 kernel 主线,本期二手转述的「257 贡献者 1007 PR」是同一版本的另一种计数口径);Mika(L620,11-01 已写端侧 Android agent 全部细节);agent-desktop(L658,上期「六、开源项目」第 1 条已详写无障碍树路线);GPT-6.1 Terra(L464,10-27 正式发布已写定价、上下文、Terminal-Bench 4.0);LongCat-2.5(L663,11-03 期已详述 1.6T/48B、W4A4 增益与全部基准);xAI Grok 水印(L625,11-01 已写 11-07 生效与 x-watermark 响应头);Claude 文本水印(L626,11-01 已写扩至 4 个老模型与检测 API 私有预览);Grid Protectors(L648);LifeVal(L649,11-03 期已详述 7 类别与示例得分) |
| 翻案(DUP → 收录) | 1 | Hydrogen-1.0:脚本判 DUP 的理由是「强键精确命中 web:www.deep-principle.com, v5.3」,但该域名实为待售页(Spaceship 停放),索引中并无 Hydrogen 或深度原理的任何记录,v5.3 是 GLM-5.3 基座的弱键误命中。拿到一手模型卡(ModelScope)与官方发布文后按「新事件」翻案收录。这也是本期唯一一条翻案——与上期 13 条翻案(源于规则引擎草稿污染索引)性质完全不同 |
| REVIEW 复核后淘汰 | 6 | GitHub Copilot Fusion(10-28 与 Octoverse 同日发布,同为「首次进入视野」但本期无增量;它的存在已作为 Octoverse「模型选择碎片化」的判断依据写入正文——47 个模型、无一超 25% 的请求,正是 Fusion 这类路由层出现的前提);dsh-superagent-prototype(11-01 已写 Router+Worker 双层架构,本期仅 star 从 2,857 涨到 18,196,无新版本无新事件);claude-mem(10-30 已写 v15.7.0 的 File Read Gate,本期无新版本,仅 star 从 106,286 到 112,453);ponytail(10-04 已报且已被独立复测修正 94%→约 54%,本期无新增量);Gemini 4 Carbon(10-28 发布、10-29 期已写安全项与定价,本期二手「登顶 AA 指数」是同一批数字);Vera Rubin NVL72 1,000 token/s(仅二手聚合,无一手源,已移入待核实) |
| 语义兜底淘汰 | 4 | Unsloth v0.1.914-beta——发布说明主体是 Glass 主题、聊天导航、代码字体等 UI 定制,唯一技术项是「CPU 文本训练」与 DeepSeek-V4.1 512K 的 GGUF 排名,无实质架构变更;DeepSpeed nightly——ZeRO-1/2 梯度保留修复,nightly 标签无版本语义;heydamir/unslop——11-01 已报(3,577★),本期仅 star 涨到 8,048,无新版本;2611.05292 Personas Are Not People——论证扎实(固定 persona 的模拟在三种假设下必然失真),但与本期已收的 7 篇在主题上重叠度低、且无实验规模,篇幅所限未单列,此处留档备查 |
| 合并处理 | 3 组 | llama.cpp b12079 + b12102 合成 1 条(相隔 12 小时的两个 nightly,一个加通信原语一个修边界检查);vLLM #64368 + TensorRT-LLM #21436 合成 1 条(同为推测解码的工程修正,方向相反);NVIDIA 51% 红线 + Oracle 取消腾讯租约 合成 1 条(同一周内管制从供给端延伸到租赁端) |
| 元反思(不计入淘汰) | 1 | Octoverse 的「8 倍提交量」在中文转述里几乎全部被写成因果(「用了 agent 所以快 8 倍」)。GitHub 原文与第三方分析都明确:这是相关性,仓库规模、工作负载、提交习惯都是可能的替代解释;agent 数字本身还是下限(不是每个 agent 都留下可检测痕迹)。本期正文与配图均按「相关性」表述 |
token 账:全量索引 159,103 字符 ≈ 58,927 token(667 数据行,含「更新至」54 行)。第一轮 43 条候选(多为二手线索)→ 预筛后需读 26,175 字符 ≈ 9,694 token(压缩 6.1×),其中 12 条 NEW 无需读索引;回溯一手源替换 URL(补齐 Android Studio 官方博客、Octoverse 官方博文、Hydrogen 模型卡、Oracle 条目)后第二轮 45 条 → 预筛后 26,175 字符 ≈ 9,694 token(压缩 6.1×),其中 12 条 NEW 无需读索引。以第二轮结论为准。第二轮 DUP 从 10 条降到 9 条(Hydrogen 翻案),REVIEW 从 22 条升到 23 条(新增 Oracle 条目)。
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止 |
|---|---|---|---|---|---|---|
| 1 | 一 | Hy4 正式发布,为真实生产力而生 | 腾讯混元(全文转载) | https://so.html5.qq.com/page/real/search_news?docid=70000021_1036aeb0d6a19652 | 2026-11-04 | 2026-11-04 |
| 2 | 一 | 腾讯混元 Hy4 正式版发布 引入视觉与电脑操作 | 腾讯新闻(驱动中国) | https://news.qq.com/rain/a/20261104A0AIZN00 | 2026-11-04 | 2026-11-04 |
| 3 | 一 | 腾讯混元 Hy4 发布,胜负手押在办公协同 | 腾讯新闻(21 世纪经济报道) | https://news.qq.com/rain/a/20261104A08SHF00 | 2026-11-04 | 2026-11-04 |
| 4 | 一 | Make long-running agents faster with message threads | Anthropic | https://claude.com/resources/articles/message-threads | 2026-11-02 | 2026-11-02 |
| 5 | 一 | Hydrogen-1.0 正式发布:首款 753B 通用大模型 | 深度原理(腾讯新闻转载) | https://news.qq.com/rain/a/20261104A041QB00 | 2026-11-02 | 2026-11-03 |
| 6 | 一 | Hydrogen-1.0 模型卡 | ModelScope | https://www.modelscope.cn/models/deep-principle/Hydrogen-1.0 | 2026-11-03 | 2026-11-03 |
| 7 | 二 | Accelerating engineering for the physical world | OpenAI | https://openai.com/index/accelerating-engineering-for-the-physical-world/ | 2026-11-03 | 2026-11-03 |
| 8 | 二 | llama.cpp b12079(NCCL 多节点 TP) | llama.cpp GitHub Releases | https://github.com/ggml-org/llama.cpp/releases/tag/b12079 | 2026-11-03 | 2026-11-03T21:58Z |
| 9 | 二 | llama.cpp b12102(view 按 stride 边界检查) | llama.cpp GitHub Releases | https://github.com/ggml-org/llama.cpp/releases/tag/b12102 | 2026-11-04 | 2026-11-04T09:12Z |
| 10 | 二 | vLLM #64368(DSpark draft head 量化) | vLLM GitHub PR | https://github.com/vllm-project/vllm/pull/64368 | 2026-10-31 合并 | 2026-10-31T10:23Z |
| 11 | 二 | TensorRT-LLM #21436(dynamic-tree 滑窗兼容性) | NVIDIA TensorRT-LLM PR | https://github.com/NVIDIA/TensorRT-LLM/pull/21436 | 2026-11-03 合并 | 2026-11-03T05:13Z |
| 12 | 二 | Your favorite agents are now integrated in Android Studio | Android Developers Blog | https://developer.android.com/blog/posts/ai-agents-android-studio-integration | 2026-10-28 | 2026-10-28 |
| 13 | 二 | Android developers can stray: Google opens Studio to Claude, GPT and more | heise online | https://www.heise.de/en/news/Android-developers-can-stray-Google-opens-Studio-to-Claude-GPT-and-more-11506605.html | 2026-10-28 | 2026-10-28 |
| 14 | 三 | 輝達要求資料中心降低對中依賴 | 中央社(引 FT) | https://www.cna.com.tw/news/ait/202611030199.aspx | 2026-11-03 | 2026-11-03 |
| 15 | 三 | 消息称甲骨文取消与腾讯 70 亿美元 AI 芯片租赁交易 | C114(引 FT) | https://m.10jqka.com.cn/20261104/c681450921.shtml | 2026-11-04 | 2026-11-04 |
| 16 | 三 | Anthropic 招股书更新,第三季度重回亏损 | 中国新闻网(中新经纬) | https://m.chinanews.com/wap/detail/cht/zw/jw695398.shtml | 2026-11-03 | 2026-11-02 提交 |
| 17 | 三 | AI 巨头,更新招股书 | 证券时报网 | https://www.stcn.com/article/detail/4319207.html | 2026-11-03 | 2026-11-02 提交 |
| 18 | 三 | Meta 拟发行约 150 亿美元债券,最高认购倍数接近 4 倍 | 新浪财经经网易(引彭博) | https://www.163.com/dy/article/LAS5OCMQ05568W0A.html | 2026-11-04 | 2026-11-04 |
| 19 | 三 | Meta 启动美元、欧元债发行,募资 200 亿至 250 亿美元 | 财联社经今日头条 | https://www.toutiao.com/article/7703964482485158419 | 2026-11-03 | 2026-11-03 |
| 20 | 三 | 華為仍依賴韓國記憶體!HBM3E 黑市價飆升 | 鏈新聞(引 The Information) | https://abmedia.io/huawei-hbm-korea-smuggling | 2026-11-03 | 2026-11-03 |
| 21 | 三 | 華為已向部分客戶表示需自行尋找 HBM | 香港經濟日報(引 The Information) | https://inews.hket.com/article/4217982/ | 2026-11-03 | 2026-11-03 |
| 22 | 三 | 谷歌宁愿少卖云算力,也要先把算力留给 Gemini | InfoQ(Big Technology Podcast) | https://www.infoq.cn/article/JmVl0yY2RYIBNpuD0xuu | 2026-11-03(录制 10-21) | 2026-10-21 |
| 23 | 四 | You don't need long context(2611.05306) | arXiv(NVIDIA) | https://arxiv.org/abs/2611.05306 | 2026-11-03 提交 | 2026-11-03T18:17Z |
| 24 | 四 | Knowingly Wrong(2611.05287) | arXiv | https://arxiv.org/abs/2611.05287 | 2026-11-03 提交 | 2026-11-03T18:02Z |
| 25 | 四 | Suppressing Misaligned Behaviors in Language Models, Durably(2611.05358) | arXiv(Princeton) | https://arxiv.org/abs/2611.05358 | 2026-11-03 提交 | 2026-11-03T18:54Z |
| 26 | 四 | Adversarial Speculative Reasoning Improves Long Horizon Agents(2611.05345) | arXiv | https://arxiv.org/abs/2611.05345 | 2026-11-03 提交 | 2026-11-03T18:45Z |
| 27 | 四 | LoopVQ: Sub 1-bit KV Cache Quantization for Looped Transformers(2611.05304) | arXiv | https://arxiv.org/abs/2611.05304 | 2026-11-03 提交 | 2026-11-03T18:16Z |
| 28 | 四 | LatentTriad: Pre-Action Risk Representations for Malicious Agent Skill Detection(2611.05088) | arXiv | https://arxiv.org/abs/2611.05088 | 2026-11-03 提交 | 2026-11-03T15:46Z |
| 29 | 四 | Workload-Static Optical Circuit Switching For Scalable LLM Inference Decode(2611.05104) | arXiv | https://arxiv.org/abs/2611.05104 | 2026-11-03 提交 | 2026-11-03T16:00Z |
| 30 | 五 | GitHub Octoverse 2026:年推送 179 亿次 | GitHub Blog | https://github.blog/news-insights/octoverse/octoverse-commits-pushes-reach-new-highs-in-2026-as-developers-build-with-agents | 2026-10-28 | 2026-09-30 |
| 31 | 五 | Octoverse 2026 三年对比数据(2024/2025/2026 重算口径) | Data Studios(引 GitHub 报告) | https://www.datastudios.org/post/github-octoverse-2026-17-9-billion-pushes-agents-start-40-percent-pull-requests | 2026-10-28 | 2026-09-30 |
| 32 | 六 | storytold/craft-anything | GitHub | https://github.com/storytold/craft-anything | — | 2026-11-04 查询(10,044★) |
| 33 | 六 | ccch1mneyyy/dsh-Go | GitHub | https://github.com/ccch1mneyyy/dsh-Go | — | 2026-11-04 查询(8,849★) |
| 34 | 六 | l0ng-ai/openidea | GitHub | https://github.com/l0ng-ai/openidea | — | 2026-11-04 查询(5,983★) |
| 35 | 六 | patch-gg/pixelfx | GitHub | https://github.com/patch-gg/pixelfx | — | 2026-11-04 查询(4,500★) |
引用提醒:本期所有「厂商自测」标注项(Hy4 的全部基准与幻觉率、Hydrogen-1.0 的全部评测、BenchCAD 2.0 的内部模型分数、Android Studio 的 77% / 3× / 46 vs 88 分钟)均无第三方独立复现;所有「据报/据知情人士」项(NVIDIA 51% 红线、Oracle 取消腾讯租约、华为 HBM 供应、Meta 债券最终规模)均未获当事方确认或双方均未置评,引用时请保留限定语。四处最易被转述带偏的地方已在正文标注:① Anthropic 承诺总额是 8,954 亿美元而非流传的 1.07 万亿;② Octoverse 的「8 倍提交量」是相关性不是因果,且 agent 数字是下限;③ Message Threads 省的是请求体字节数,token 计费不变;④ Hy4 权重尚未放出,不能称「已开源」,Hydrogen-1.0 才是本期真正开放权重的那一个。本期 arXiv 收录的 7 篇均为 2026-11-03 UTC 15:46–18:54 提交,11-04 批次截至检索时尚未生成,已在各条标注 v1 时间戳。