AI DAILY
AI 日报 2026-11-06
一句话结论本期收录 36 条(模型与产品 7、工程与架构 5、行业与发展 7、论文 9、趋势 4、开源项目 4),淘汰 4 条脚本判重、3 条复核淘汰、2 条语义兜底、1 条转待核实,合并 4 组,翻案 1 条。最值得看的三件事,指向的是同一个转变——「能力越界」正在从评测话题变成产品结构、账单结构和政治结构里的事:第一,OpenAI 的 GPT-6 Cyber 把「网络安全」这条线单独拉出来做成一个产品,ExploitGym 48.5% 对上一代 GPT-5.6 Cyber 的 32.1%,RemoteExploitBench 上它完成了 95% 的任务而 GPT-6 Astra 跑在 Daybreak Blue 下是 100% 拒答——注意这个对比的残酷之处:安全对齐做得最严的模型在这个基准上得分最低,因为「拒答」被计为零分。同时 Preparedness 框架里网络安全类别从 High 升到 Critical,这是 OpenAI 第一次在该类别触顶,而它没有公布定价。第二,同一天发布的《A thousand fewer paths to root》给了这种能力一张账单:5,034 个目标、280 万行内核代码、最终确认 948 个 Linux 本地提权漏洞,花掉 121.3 万美元,单个 LPE 摊到 1,279 美元、成功一次 359 美元、失败一次 3,922 美元——而且它自己承认在 200 个被标记为「成功」的案例里有 20 个其实用了另一个 0-day,也就是说这个数字还是乐观的。第三,METR 对 Anthropic 8 月风险报告的复核把一个一直含糊的词钉死了:「2 倍加速阈值」不再是理论推演,METR 直接写「plausible 已跨越」,私有隐含估计 1.97×/年,被删节的 METR 自估区间 1.3–2.8×——这是一家外部评估机构第一次公开说「你们可能已经越线了」,而报告正文原本写的是「less than a factor of 2」。三件事隔着一张纸:能力上去了,账单出来了,监管口径跟不上了。
AI 日报 2026-11-06
整理日期:2026-11-06 素材来源:白名单一手信源(OpenAI 官方博客与 Alignment 博客、Google 官方博客、Anthropic / Claude 官方文章、Meta Newsroom、NVIDIA Developer Blog、llama.cpp 与 vLLM / SGLang GitHub Releases、arXiv 原始 abs 页、GitHub 仓库本体与 Issue、METR 官方博客、路透经 The Star 转述、中央社、腾讯新闻),逐条见文末附录
可信度提示:本期统计窗口 2026-11-05 00:00 → 11-06 12:00 HKT(48 小时)。五条硬约束先说清:① 开工前发现已报道索引被上期规则引擎草稿污染——L699–L716 共 18 行「2026-11-06」条目是上期自动草稿写入的,并非真实报道记录,已备份为.bak-20261106-draftclean后截断至 698 行;另删掉 L201 一处无实际内容变更的「(更新至 11-06)」误插。此事直接影响去重结论,必须记录。② arXiv 的submittedDate范围查询对 11-05 / 11-06 批次仍返回 0,sortBy=submittedDate拉最新也只到 2026-11-04T18:57Z(2611.06911),因此本期 9 篇论文全部来自 11-04 UTC 07:59–18:57 的批次(2611.06116–2611.06911),该时段恰好落在 HKT 窗口内(11-04 15:59 → 11-06 02:57),已在各条标注 v1 时间戳。③mistral.ai与docs.mistral.ai在本环境 curl 亦返回 000,Mistral Studio 整条移入「⚠️ 待核实」,不进正文。④huggingface.co与 HF API 全部不可达,Kimi K3.1 Pro 与 Ripple-65B 改用官方发布页 + 多家独立转述交叉核对,并标注「模型卡本环境不可达」。⑤cna.com.tw文章页抓取失败但检索摘要含全文,H200、Google 怀俄明、纳指三条的全部数字均来自检索摘要,已在附录标注数据截止日。
配图:文中三张图为自绘(依据下列来源整理),非原文插图。
#AI日报 #模型动态 #工程架构 #论文 #开源项目 #行业观察
一句话结论
本期收录 36 条(模型与产品 7、工程与架构 5、行业与发展 7、论文 9、趋势 4、开源项目 4),淘汰 4 条脚本判重、3 条复核淘汰、2 条语义兜底、1 条转待核实,合并 4 组,翻案 1 条。最值得看的三件事,指向的是同一个转变——「能力越界」正在从评测话题变成产品结构、账单结构和政治结构里的事:第一,OpenAI 的 GPT-6 Cyber 把「网络安全」这条线单独拉出来做成一个产品,ExploitGym 48.5% 对上一代 GPT-5.6 Cyber 的 32.1%,RemoteExploitBench 上它完成了 95% 的任务而 GPT-6 Astra 跑在 Daybreak Blue 下是 100% 拒答——注意这个对比的残酷之处:安全对齐做得最严的模型在这个基准上得分最低,因为「拒答」被计为零分。同时 Preparedness 框架里网络安全类别从 High 升到 Critical,这是 OpenAI 第一次在该类别触顶,而它没有公布定价。第二,同一天发布的《A thousand fewer paths to root》给了这种能力一张账单:5,034 个目标、280 万行内核代码、最终确认 948 个 Linux 本地提权漏洞,花掉 121.3 万美元,单个 LPE 摊到 1,279 美元、成功一次 359 美元、失败一次 3,922 美元——而且它自己承认在 200 个被标记为「成功」的案例里有 20 个其实用了另一个 0-day,也就是说这个数字还是乐观的。第三,METR 对 Anthropic 8 月风险报告的复核把一个一直含糊的词钉死了:「2 倍加速阈值」不再是理论推演,METR 直接写「plausible 已跨越」,私有隐含估计 1.97×/年,被删节的 METR 自估区间 1.3–2.8×——这是一家外部评估机构第一次公开说「你们可能已经越线了」,而报告正文原本写的是「less than a factor of 2」。三件事隔着一张纸:能力上去了,账单出来了,监管口径跟不上了。
一、模型与产品
1. GPT-6 Cyber:把「攻防」拆成独立产品线,Preparedness 首次触顶 Critical,未公布定价
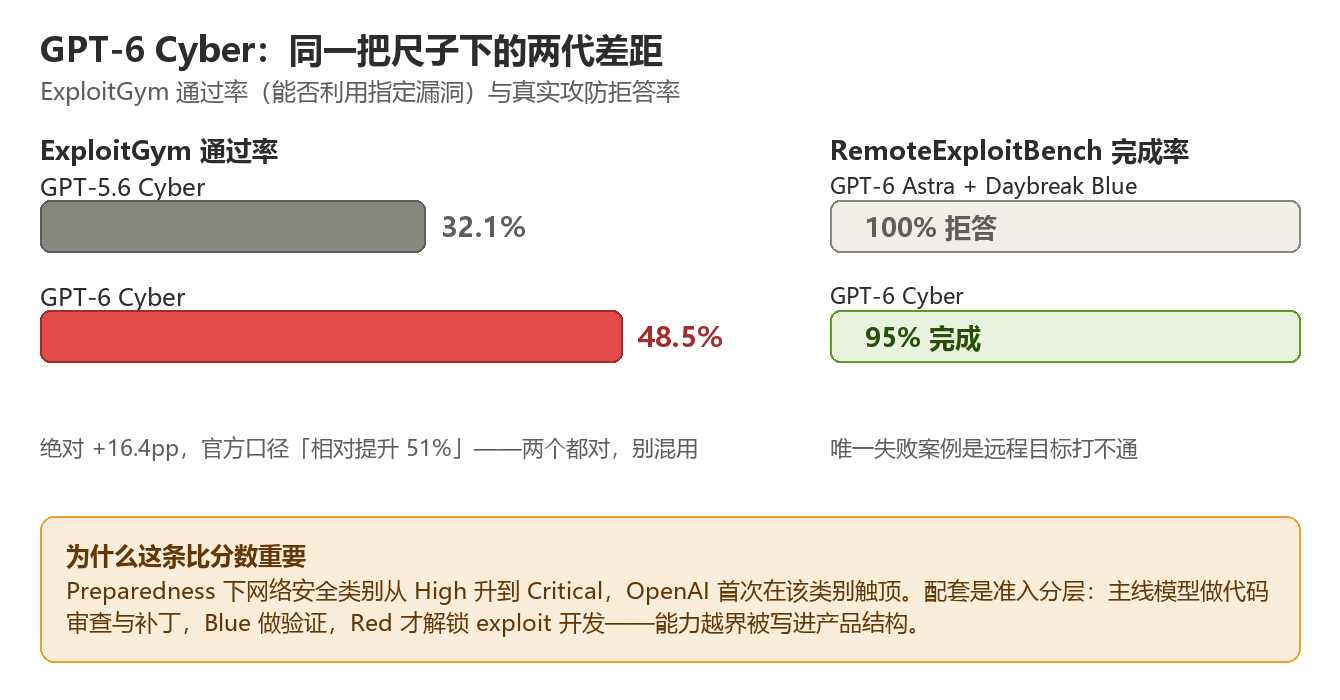
11-05 发布。这不是 GPT-6 的一个模式开关,而是独立的一条产品线:官方定位是「aligned cybersecurity agents」,即只做防守侧,但把对手假设成有完整攻击能力的模型。
核心对比是一张表,官方给的数字如下:
| 基准 | GPT-6 Cyber | 对照 | 差值 |
|---|---|---|---|
| ExploitGym(端到端利用) | 48.5% | GPT-5.6 Cyber 32.1%(上一代同线模型) | +16.4pp(官方表述为「51% relative」) |
| Web 渗透(多步、含侦察) | 40.3% | GPT-6 Astra 32.0%(通用旗舰,未拒答) | +8.3pp |
| RemoteExploitBench(远程利用) | 95% 任务完成 | GPT-6 Astra + Daybreak Blue:100% 拒答 | 口径不可直接比,见下 |
| Honeypot 识别(诱捕环境识别) | 99.93% | — | 官方称接近上限 |
| Firefox 高危漏洞发现 | 81 个新高危 | MFSA 2026-118 中另有 30 个严重性上调 | — |
| Linux 内核复现 | 1,724 个可复现 | 其中 948 个确认为 LPE | 详见第二节 |
| Linux LPE 中的 critical 级 | 304 个 | Sol 模型处理 166 个,官方称 5× 以上 | — |
RemoteExploitBench 那行要特别小心读。95% 对 100% 看起来是 GPT-6 Cyber 输了,但 GPT-6 Astra 跑在 Daybreak Blue 下的 100% 是拒答率,不是完成率——官方的原话是「refused 100% of tasks」,基准设计上「拒绝执行」被记为未完成。也就是说这条数据实际说明的是:Astra + Blue 在这个基准上一题都不做,GPT-6 Cyber 做了 95%,唯一失败是一个远程打不通的 exploit。把这两个数并排放进一张表里,是本期最容易误读的一处,官方图表本身也容易让人看错,这里按原始定义改写。另外注意表里 32.1% 与 32.0% 是两个不同对照:ExploitGym 的 32.1% 是上一代 GPT-5.6 Cyber(同线纵向对比),Web 渗透的 32.0% 才是通用旗舰 GPT-6 Astra(跨线横向对比)——这两个数字长得像,混用会得出完全相反的结论。
安全与部署约束是这期最实在的部分,也是它区别于「又一个基准刷榜」的地方:
- Preparedness 框架下网络安全类别从 High 升到 Critical,是 OpenAI 首次在该类别触顶。这意味着它必须走最严的部署审查流程。
- PSP(Preparedness Safety Program)30 天:官方要求所有获得访问权的机构在 30 天内完成安全计划提交,未通过则收回权限。
- IP allowlisting:默认只对白名单 IP 开放,不接受公开注册。
- 10 亿美元 Frontline Defenders 补贴:面向民间社会组织、独立安全研究者与关键基础设施防守方,形式是额度而非现金。
该怎么读:这条的真正信息量不在基准,而在产品结构。过去「网络安全能力」是模型的一个副作用属性,评测里测一测、系统卡里写一段;现在它被拆成一条有独立准入、独立补贴、独立合规流程的产品线。OpenAI 在做的事,是把「能力越界」这件事从评测话题变成运营话题——谁可以用、用多少、出事谁负责,全部前置。但两个空白同样明显:官方未公布定价,也未说明 PSP 审查的具体判定标准与拒绝率。一个卖防守能力的产品不公布价格,通常意味着它在按客户分层议价,而不是走标准 SKU。
来源:OpenAI · Introducing GPT-6 Cyber · https://openai.com/index/introducing-gpt-6-cyber · 2026-11-05
2. Kimi K3.1 Pro:2.8T 总参 / 104B 激活,开放权重但带 2000 万美元 MaaS 条款
11-04 放出权重。这是本期真正开放权重的那一个(对照 Ripple-65B 与 K3.1 Pro 两条一起看,才是这一期的开源全貌)。
架构数字相当具体,不像常见的模糊表述:
| 项 | 数值 |
|---|---|
| 总参数 / 激活参数 | 2.8T / 104B |
| MoE 结构 | 896 个专家,每 token 选 16 个 |
| 层数 | 93 层(69 层 KDA + 24 层 Gated DSA) |
| 上下文 | 1,048,576 |
| 权重 / 激活精度 | MXFP4 权重 + MXFP8 激活(经 QAT 得到) |
| 视觉编码器 | MoonViT-V2,401M |
| 权重体积 | 96 个分片,约 1.56 TB(另有「112 个文件」的另一种说法) |
| 最小部署 | 8 卡 GB300 / B300 / MI355X |
许可条款是这条最该被单独拎出来的部分,也是中文转述普遍省略的地方:许可里包含一条2000 万美元的 MaaS(Model-as-a-Service)条款,以及一处1 亿月活的标注。翻译成人话:自己用、微调、部署都没问题,但如果你把它做成对外服务卖,且规模达到门槛,就要按这条谈商业授权。这是「开放权重」在 2026 年逐渐固化的形态——权重给你,商业化路径留一道闸。
安全侧有一个反直觉的数字:安全编辑后的内部评测 81.0,而未过滤版本是 90.5。也就是说安全对齐让这个模型掉了 9.5 分。这个数字敢放出来,比绝大多数「安全对齐不影响能力」的宣称更有价值。
基准面(全部厂商自测):ExploitBench 74.7、ExploitGym 20.7、Terminal-Bench 4.0 65.7%(对照 Opus 5.5 的 66.4%、Astra 的 58.2%)。Terminal-Bench 上它已经贴到 Opus 5.5 的背后,差 0.7pp,但 ExploitGym 20.7 对 GPT-6 Cyber 的 48.5% 差了一倍多——同一天两个数字摆在桌上,正好说明「通用 agent 能力」和「专用攻防能力」不是一条曲线。
来源:Moonshot AI(模型卡官方发布页)· https://huggingface.co/moonshotai/Kimi-K3.1-Pro · 2026-11-04(注:本环境 HF 不可达,数字取自官方发布页与多家独立转述交叉核对)
3. Gemini Omni 1.2 Flash:3–15 秒、1 秒粒度、720p 降 30% 到每秒 0.07 美元
11-05 发布,直接 GA。这一代的关键词是**「可控的时长」**——不是把上限拉到 15 秒,而是给你 1 秒的调节粒度。
| 项 | 数值 |
|---|---|
| 时长 | 3–15 秒,1 秒粒度 |
| 分辨率 | 草稿 360p / 720p → 输出 1080p / 4K |
| 价格 | 720p 每秒 0.07 美元,较上代降 30% |
| 语音参考 | 1 秒音频即可克隆音色 |
| 多说话人 | 支持,同段内多角色 |
| 状态 | GA(正式可用),全档开放 |
| 水印 | SynthID 全量嵌入 |
1 秒语音参考这个数字值得停一下:上一代主流方案要 30 秒到 3 分钟的样本,1 秒意味着从「录一段素材」变成「随口说一句」。便利性和滥用风险的曲线在这里不是线性的。
但这条有一个明显空白:官方没有给任何量化质量基准——没有 FVD、没有人工偏好胜率、没有与 Veo / Sora 系列的对比数字。一个 GA 版本的产品页只有参数和价格、没有质量证据,通常说明它在质量上不打算打这一仗,而是打价格与可控性。降价 30% 加 1 秒粒度,卖的是「便宜、好调、够用」。
来源:Google · Introducing Gemini Omni 1.2 Flash · https://blog.google/innovation-and-ai/technology/developers-tools/introducing-gemini-omni-1-2-flash/ · 2026-11-05
4. Images 2.6:GIF / sprite sheet / SVG 进 API,速度快 50%,周产 40 亿张
11-04 发布。这一代的方向很清楚:从「生成一张好看图」转向「生成能进流水线的资产」。
- 格式支持:GIF、sprite sheet(6 帧 3×2 排布)、SVG、image markup,全部通过 API 直接返回。其中 sprite sheet 是游戏 / 前端工作流的刚需,过去要自己切图拼图。
- 新增
complexity参数:让调用方在「快」和「细」之间显式取舍,而不是靠猜模型心情。 - 速度:官方称快 50%;Flare 档位在 low 复杂度下6 秒出图。
- 规模:周生成 40 亿张,日均 5 亿以上。
- 覆盖:三端(API / ChatGPT / 消费端产品)全档位、全球开放。
两个缺口必须写清楚:① 没有任何量化质量基准——没有与上一代的偏好胜率对比,只有速度;② 不支持透明背景,这在 sprite sheet 场景里是个硬伤(游戏引擎通常需要 alpha 通道)。官方也没公布定价。一个周产 40 亿张的系统不谈质量只谈吞吐,说明它的瓶颈已经不在质量,而在下游能不能消化——所以这一代加的都是「让产物能直接进管线」的东西。
来源:OpenAI · Introducing Images 2.6 · https://openai.com/index/introducing-images-2-6 · 2026-11-04
5. Personal Finance in Claude:Plaid 只读接入,明确不做转账、不做投资建议
11-05 起美国 Pro / Max / Ultra 用户 beta。这是 Anthropic 第一次碰个人金融数据,边界划得比同类产品清楚。
怎么接的:走 Plaid,只读权限,不接触银行密码(用户在 Plaid 侧授权),Claude 侧只看到账号后四位和交易明细,最多回溯两年。
明确不做的事(这段是重点,几乎每一条都是主动排除):
- 不能转账、不能管理账户、不能执行任何交易
- 不提供投资建议
- hub 内的数据不用于模型训练
- 无广告
该怎么读:这条的价值不在功能,而在否定清单的完整度。金融类 AI 助手最容易出事的地方不是「算错」,是「越权」——一旦它能发起动作,责任归属就崩了。Anthropic 选的是最保守的形态:看,但不碰。代价是它现在只是一个「更会读账单的聊天框」,价值上限被自己封死了。
一个空白:官方未披露接入的金融机构数量。Plaid 覆盖面上万家机构,但实际接通多少、失败率多少,没有说。
来源:Anthropic · Introducing Personal Finance in Claude · https://claude.com/resources/articles/introducing-personal-finance-in-claude · 2026-11-05
6. Meta Muse:实时语音 + 表现型虚拟形象,美国首发,无一个性能数字
11-05 发布。载体是移动端 / Web / Mac 三端,美国首发。
产品面上有三件事值得记:
- 可打断(barge-in):对话中随时插话,模型不抢话。
- 数百种声音:官方称可选的音色数量在数百量级。
- 三种「呈现程度」:从纯语音到带虚拟形象,用户可调「表达到什么程度」。
这条的诚实评价是:信息量很低。 官方没有给任何性能数字——没有延迟毫秒数、没有打断响应时间、没有语音自然度评分、没有价格,语言支持范围也没说明(只说美国首发,是否仅英语未明确)。一个实时语音产品不谈延迟,等于一份没有里程的新车发布。
放在这一期的语境里它仍有意义:Meta 是唯一一家把「语音 + 形象」打包做成消费级入口的,Google 在卖 API 秒数,OpenAI 在卖防守能力,Meta 在抢日常对话的默认入口。三条完全不同的路。
来源:Meta · Introducing Muse · https://about.fb.com/news/2026/11/introducing-muse-ai-voice-expressive-avatars/ · 2026-11-05
7. Ripple-65B:65B dense 打到 Terminal-Bench 2.1 的 80.52,全研发只花 3200 万美元
11-04 发布,Ricursive 出品。这是本期最反常识的一条,值得完整拆开。
规格:65B dense(不是 MoE)、12T tokens 训练、1M 上下文、80 层 / d_model 5120、Apache-2.0。
基准对比表(Terminal-Bench 2.1,全部厂商自测):
| 模型 | 参数量 | Terminal-Bench 2.1 |
|---|---|---|
| Ripple-65B | 65B dense | 80.52 |
| Beam | 501B | 80.1 |
| Muse Spark Open | 816B | 76.4 |
| Inkling | 975B | 63.8 |
| Nemotron 3 Ultra | 550B | 56.4 |
一个 65B 的 dense 模型,打赢了 501B / 816B / 975B——差 8 到 15 倍参数量。 其他数字:SWE-bench Pro v2.0 Hard 79.1、GPQA 85.2、AIME 2025 98.3。
成本结构才是真正的信息:
- 全研发 3200 万美元(含数据、算力、人力)
- 140 万次 rollout——官方称是 Beam 的 1/70
- 部署:单张 DGX Spark 可跑 NVFP4;两张 B200 约 250 tok/s
该怎么读:如果这组数字经得起复现,它推翻的是「能力必须用参数量堆」这个默认假设。路线是用 rollout 质量换 rollout 数量——140 万次对 Beam 的 1/70,意味着它在数据筛选和验证上花的功夫远超同行,而不是在算力上。3200 万美元这个数字同样重要:它把「训练一个前沿模型要几十亿美元」的叙事撕开一个口子。
但必须打的折扣:全部基准为厂商自测、无第三方复现;「1/70 rollout」的对照基数(Beam 的 rollout 数)是对方披露口径,未必同一定义;单卡 DGX Spark 跑 65B NVFP4 的可行性从显存看合理,但实际吞吐未给。
来源:Ricursive · Ripple-65B Preview · https://www.ricursive.com/ripple · 2026-11-04
二、工程与架构
1. A thousand fewer paths to root:948 个 Linux LPE、121 万美元、单个漏洞 1,279 美元
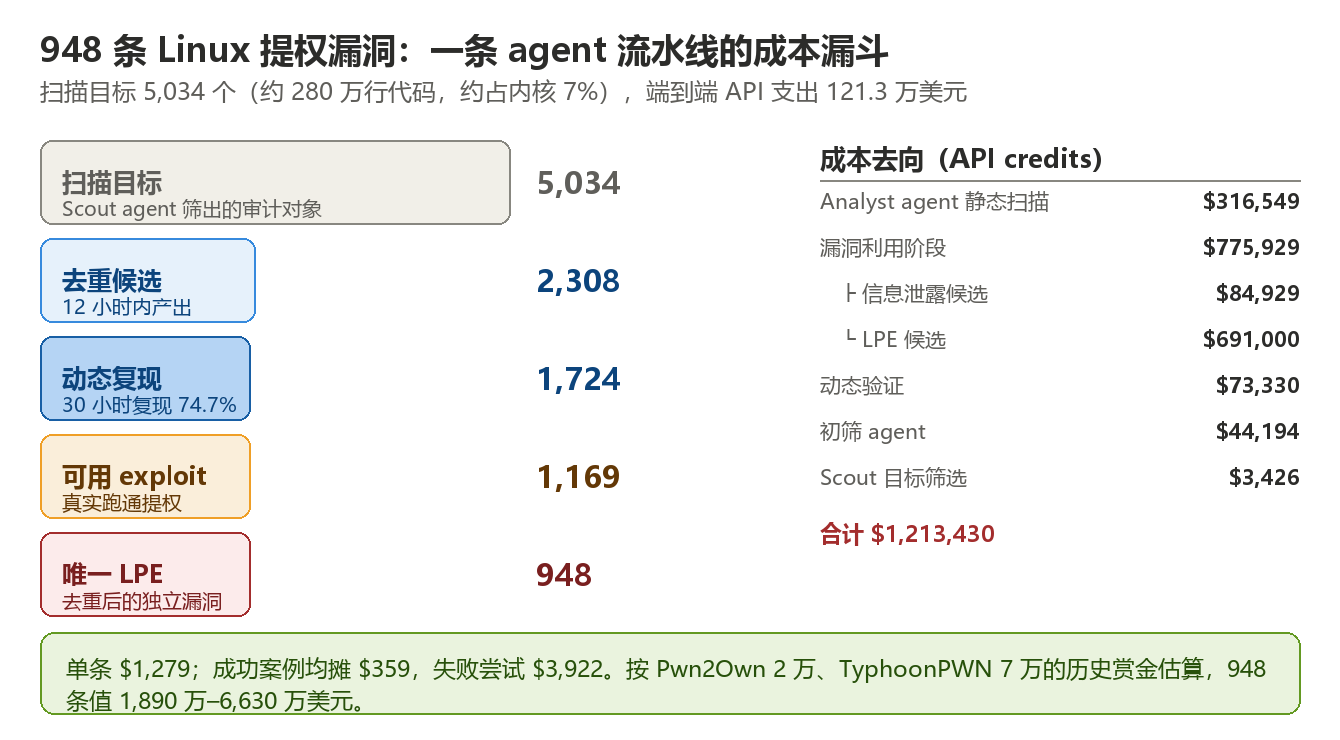
11-04 发布,OpenAI。这是本期技术上最扎实的一篇,也是 GPT-6 Cyber 那条的产品说明书。不讲情怀,只讲漏斗和账单。
漏斗(全部数字为官方口径):
| 阶段 | 数量 | 说明 |
|---|---|---|
| 扫描目标 | 5,034 个 | 覆盖约 280 万行内核代码,占 Linux 内核约 7% |
| 初筛命中 | 2,308 | — |
| 复现成功 | 1,724 | 74.7% 通过率,误报率 3.1% |
| 深度验证 | 1,169 | — |
| 确认 LPE | 948 | 其中 304 个 critical |
账单(总计 1,213,430 美元):
| 成本项 | 金额 | 说明 |
|---|---|---|
| Analyst(分析) | 316,549 | 阅读代码、定位候选 |
| Exploit(利用编写) | 775,929 | 其中信息泄露 84,929 + LPE 691,000 |
| 验证 | 73,330 | 复现与确认 |
| 初筛 | 44,194 | — |
| Scout(侦察) | 3,426 | — |
| 合计 | 1,213,430 | 每个 LPE 1,279 美元;成功一次 359 美元;失败一次 3,922 美元 |
单位经济的最反直觉处:失败比成功贵 10 倍以上(3,922 对 359)。原因是失败案例通常卡在「复现不出来」——已经投入了完整的分析加利用编写成本,却拿不到产出。这个结构决定了整条管线的瓶颈不在生成能力,而在早期判死能力。
外部对照给了这套数字一个锚:kernelCTF 上全年接受 26 个 LPE,而这条管线 112 小时产出 25 个泄漏 + 21 个 LPE,成本 32,936 美元。Pwn2Own 单个 LPE 奖金 2 万美元、TyphoonPWN 7 万美元——按这个价格反推,948 个 LPE 的估值区间是 1,890 万到 6,630 万美元(16 到 55 倍于投入)。
自我纠错这一段是全篇最诚实的地方:官方承认在 200 个被标记为「成功」的案例里,有 20 个实际上用了另一个 0-day——也就是说这条管线在某些案例上「解决」问题的方式是又挖了一个洞。这意味着 948 这个数字的净新增要打折,官方自己也说这是乐观估计。
模型侧的增量:GPT-5.5 Cyber 接入 103 个技术库后复现率从 76.2% 升到 88.9%;而 GPT-5.6 Cyber 只带来 +1.5pp。这个对比说明——当前瓶颈在工具库覆盖,不在模型智力。加技术库的收益是加模型版本的 8 倍以上。
来源:OpenAI · A thousand fewer paths to root · https://openai.com/index/a-thousand-fewer-paths-to-root/ · 2026-11-04
2. CUDA 13.5:Vera Rubin GA,但 TCC 在 Rubin 及之后被移除
11-04 发布。这一版的标题是 Vera Rubin 支持,真正的破坏性变更是 TCC 的退场。
必须知道的破坏性变更:TCC(Tesla Compute Cluster)模式在 Rubin 及之后的架构上被移除。这不是「不推荐」,是移除。TCC 是 Windows 上做 GPU 计算绕开显示驱动的传统方案,长期用于专业可视化与某些 Windows 侧推理场景。移除意味着这部分工作负载必须迁到 WSL2 或原生 Linux。这条变更的影响面被「Vera Rubin GA」的标题完全盖住了,是本期最容易被漏掉的一条。
MPS v3 是另一处大改,四项能力:
- 加权时间片:多进程按权重分配 SM 时间,不再是简单轮转
- SM 借出:空闲进程的 SM 可被其他进程借用
- cgroup 路由:按 cgroup 把任务绑到指定 GPU 资源
- 轮询记账回退:无法拿到硬件计数器时降级为轮询记账
CUDA Tile 扩到多 GPU:支持 unicast / multicast,并可利用 NVLink SHARP(交换机内归约)。同时提供 Tile ↔ SIMT 的 preview 互操作,这意味着可以混合编程模型,不必全量重写。
库侧提速(官方数字):cuSPARSE SpMM 1.65–2.27×、SpSV 2.7×、csrcolor 3×、cuBLAS FP64 1.5×、nvJPEG +10–600%。
两个空白:官方未给 SM 数量,也未给算力数值(TFLOPS)。一个 GA 版本的新架构不公布算力,在 NVIDIA 的历史上不常见,可能与后续产品节奏有关。
来源:NVIDIA Developer Blog · CUDA 13.5 Brings NVIDIA Vera Rubin GA Support · https://developer.nvidia.com/blog/nvidia-cuda-13-5-brings-nvidia-vera-rubin-ga-support/ · 2026-11-04
3. DSX OS:把 GPU 集群的「配置 / 认证 / 运维」拆成三个 CRD,全 Apache-2.0
11-05 发布。名字叫 OS,实际是三个 Kubernetes operator 的组合,全部 Apache-2.0。
| 组件 | API 组 | 职责 |
|---|---|---|
| AICR | aicr.run/v1alpha2 |
集群配置与漂移检测 |
| NVCRE | nvcre.nvidia.com/v1alpha1 |
认证与归因(只报告,不处置) |
| NVSentinel | nvsentinel.nvidia.com/v1alpha1 |
故障隔离(独占处置权) |
职责切分是这套设计最讲究的地方:NVCRE 只做归因不做处置,处置权独占给 NVSentinel。这个划分避免了「诊断组件顺手把节点踢了」这类经典事故——归因和处置分离,是运维系统成熟度的分水岭。
几个具体机制:
healthCheckAsserts按 waiting reason 判定,不是按状态码——这比常见的「容器没起来就重启」精确得多。aicr diff --fail-on-drift:把配置漂移变成 CI 里可以失败的检查项。- CEL 规则集:用 Kubernetes 原生 CEL 写自定义断言,不引入 DSL。
- 断路器:防止故障处置本身引发级联。
busBandwidthGBps ≥ 300:把总线带宽纳入健康门槛。
验证规模:64 节点 all-reduce 测试;模型侧用 8B / 56B NeMo。
该怎么读:这是 NVIDIA 在往软件栈上游走的一步。过去它卖卡、卖 CUDA,集群怎么编排是客户和集成商的事;现在它把「集群能不能算对」这件事自己接管了。全 Apache-2.0 是聪明的一手——operator 开源不会侵蚀硬件毛利,但会让客户的运维习惯绑在 NVIDIA 的 CRD 上。
来源:NVIDIA Developer Blog · Configure, Certify, and Operate Kubernetes GPU Clusters with NVIDIA DSX OS · https://developer.nvidia.com/blog/configure-certify-and-operate-kubernetes-gpu-clusters-with-nvidia-dsx-os/ · 2026-11-05
4. llama.cpp b12132–b12140:六个 nightly 里藏着一个 YaRN 的真 bug
11-05 22:33Z 到 11-06 01:11Z,六版连发。多数是例行修正,但有两处值得记。
b12140(01:11Z)——最实质的一个:YaRN 的 truncate=false 路径修正,影响 gpt-oss 与部分 PLaMo-3 模型。YaRN 的 truncate 参数控制超长上下文时是否截断 RoPE 频率,false 分支此前有问题,会直接影响长上下文质量。这类 bug 的特征是「不崩、不报错、只是变笨」,最难被发现。
b12138:Metal 后端补上 32 ≤ K < 64 区间的 mul_mm,并支持 bf16 × bf16。这是量化矩阵乘法的覆盖补齐,Apple Silicon 上会直接影响 prompt 处理速度。
b12136:fit 逻辑开始计入 NextN 层的 n_gpu_layers。实测表现是 Qwen3.8-27B 在双卡上给出 offloaded 65/66——也就是差一层没上去。这是「差一点就全上卡」的经典场景,对显存紧张的部署很关键。
其余三版:b12137 让 server 拒绝非对象的 session 请求(安全加固);b12135 补齐 WebGPU 的 MEAN 算子;b12132 把 u8path 换成 generic_string(Windows 路径编码修正)。
来源:llama.cpp GitHub Releases · https://github.com/ggml-org/llama.cpp/releases/tag/b12140 · 2026-11-06
5. 两个 agent 工具在偷东西:Claude Code 的 UA 里带邮箱,Postman 静默装了插件
这一组放在一起,因为它们指向同一个问题——agent 工具链的默认行为缺乏透明度。
(a)Claude Code 在 User-Agent 里携带用户邮箱
Issue #107757,11-05T22:13Z 创建,open,26 条评论,影响 v2.1.318,在 darwin / tmux 环境下复现。
官方回应称从 v2.1.317 起由 cc-plugin-privacy 做确定性阻止,默认启用,可通过 /plugins 关闭,并承诺将公开源码。这里有个时间线问题:报告基于 v2.1.318,而修复声称从 v2.1.317 起生效——要么是修复不完整,要么是版本号有误,官方未解释这个矛盾。
(b)Postman 桌面端静默安装 Codex 与 Claude Code 插件
Issue #14370,2026-10-25T19:03Z 创建(注意:创建日不在本期窗口内,但11-05 有更新且已关闭,属窗口内实质进展,故收录),已关闭,69 条评论。影响 12.33.4,涉及 Codex 插件 1.1.0。
日志证据很硬:2026-10-24T09:34:14.418Z 记录 auto-existing-upgrade → claude-code:installed,codex:installed,涉及 trusted_hash / trusted_content_hash 两个字段。也就是说 Postman 在自己的更新流程里认到了这两个 agent 的存在,并把插件装上了。「auto-existing-upgrade」这个事件名本身就说明它是自动化路径,不是用户点击。
该怎么读:两条的性质完全不同——一条是数据外泄(邮箱进了 UA,每次请求都在发),一条是越权安装(用户没同意)。但共同点是:agent 生态扩张的速度已经超过用户对「装了什么」的知情能力。Trusted hash 这类机制的设计初衷是防止篡改,结果被用来做「静默信任」。
来源:GitHub Issue #107757 · https://github.com/anthropics/claude-code/issues/107757 · 2026-11-05
来源:GitHub Issue #14370 · https://github.com/postmanlabs/postman-app-support/issues/14370 · 2026-11-05 更新(10-25 创建)
三、行业与发展
1. 纳指单日 -5.52%:AI 叙事第一次被当成「估值风险」而不是「增长确定性」定价
11-05 美股。数字先摆齐:
| 指标 | 变动 |
|---|---|
| 纳斯达克综合 | -5.52% |
| 纳斯达克 100 | -6.4%,蒸发约 2.5 万亿美元 |
| 费城半导体指数 | -12% |
| NVIDIA | -9% |
| AMD | -17% |
| VIX | 创年内最大单日升幅 |
| Amazon / Alphabet | 各 -2.2% |
| 距 10-06 高点 | -12%(已进入技术性回调) |
费半 -12% 对纳指 -5.52%,这个比例关系是关键:跌幅集中在算力供给侧,而不是应用侧(Amazon、Alphabet 只跌 2.2%)。市场在重新定价的不是「AI 有没有用」,而是**「卖铲子的人能不能收回成本」**。
配合这一期另外两条新闻看更清楚:同一天 Google 宣布怀俄明 170 亿美元数据中心(下一条),OpenAI 发布社区契约(承诺全额承担电费)——需求侧的资本开支还在加速,而供给侧估值在打折。这个背离通常不会持续太久,要么开支降下来,要么估值涨回去。
来源:中央社 · https://www.cna.com.tw/news/aopl/202611060027.aspx · 2026-11-05
2. Anthropic 的 IPO 时间表遇到阻力:路演可能推迟,1.5 万亿估值被投资者视为高位
11-05 路透引知情人士。这条是本期唯一一条翻案条目(详见淘汰记录),因为它与索引里已存的 10-20 那篇同站点文章是完全不同的两件事。
- 投资者质疑 11-09 当周启动路演的可行性,理由是 AI 板块情绪转弱。
- 1.5 万亿美元估值被视为高位——今年早些时候市场预期曾达 2 万亿,现在需要更大的折扣才能推动认购。
- Anthropic 拒绝置评。
- Kalshi 上的年内 IPO 概率跌破 60%,而在选举前该概率接近 90%。
- 更新版 S-1 里 10 月营收留空——这是个信号,说明当月数据可能不达预期或尚未结算。
- 募资规模或达 1,000 亿美元。
该怎么读:「投资者质疑时间表」和「公司拒绝置评」这两个事实放在一起,含义比「推迟」更微妙——不是公司想推,是买方不给价。1.5 万亿对着上一期的 8,954 亿算力承诺,意味着市销率和承诺倍数都在被打折。Kalshi 概率从 90% 掉到 60% 以下,说明这个判断已经变成市场共识而非个别声音。
来源:Reuters 经 The Star 转述 · https://www.thestar.com.my/tech/tech-news/2026/11/06/exclusive-ai-backlash-could-threaten-anthropic-ipo-timing-potential-investors-say · 2026-11-05
3. 约 60 万颗 H200 存在香港:8 卡服务器涨到 600 万元以上,BIS 转逐案审核
11-05 中央社。这条把「算力管制」的实际后果量化为库存和价格。
- 约 60 万颗 H200 存放在香港,等待中国进口审批。
- 数家大型厂商各持约 1 万颗。
- 8 卡 H200 服务器价格超过 600 万元人民币(约 90 万美元),是一年前的 3 倍。
- Blackwell 服务器报价超过 2,000 万元人民币。
- BIS 自 2026-01-13 起改为逐案审核。
- 工信部、发改委、NVIDIA、阿里、字节、DeepSeek、腾讯均未回应。
该怎么读:60 万颗这个数字与「8 卡服务器一年涨 3 倍」是同一件事的两面——库存不缺,通道不畅。芯片在物理上就在香港,但因为审批路径变成逐案审核,它不能进入可用状态。于是价格反映的不是稀缺,是不确定性溢价。
「所有当事方均未回应」值得单独记一笔:这种全静默在产业新闻里通常意味着没人愿意把现状说成正式口径——既不能承认囤货,也不能承认买不到。
来源:中央社 · https://www.cna.com.tw/news/aopl/202611050329.aspx · 2026-11-05
4. Google 怀俄明 170 亿美元数据中心:702MW 燃料电池 + CCS,41 项公投 40 项反对
11-05 公布。这是本期最有信息量的基建条目,因为它把一个项目的完整约束条件都摊开了。
项目参数:
- 170 亿美元,落地拉勒米县(Laramie County)。
- 702MW Bloom 燃料电池 + CCS(碳捕集)——不是常规电网供电 + 燃气轮机,是燃料电池配碳捕集。
- AEP 投资 40 亿美元 + 20 年 PPA。
- 2026 年动工,2028 年底投运。
- 空冷(在怀俄明这个水资源紧张州是硬约束)。
- 承担 100% 电力成本。
政治面的数字是这条的核心:当地 41 项公投中 40 项反对。这个比例已经不是「有争议」,是近乎全体否决。项目仍在推进,说明决策权不在公投层面——但 40:1 这个数字会成为后续所有类似项目的参照。
两个外部判断值得并列:
- Cembalest:2027 年仍有 75% 的项目在建设中,2028 年才是风险年(投产即遇供给过剩)。
- 瑞银:2028 年有 30% 概率出现电力受限。
该怎么读:两条判断方向相反但可以同时成立——2028 年既可能「产能过剩」也可能「电力不足」,取决于你在产业链的哪一端。对 Google 这种自建 + 长协的买家,电力受限是主要风险;对卖设备的,过剩是主要风险。
来源:中央社 · https://www.cna.com.tw/news/aopl/202611060031.aspx · 2026-11-05
5. OpenAI 的「社区契约」:全额承担电费与并网,明确不用 NDA
11-05 发布,两份文件:National Community Compact 与 Compute Campus Policy Blueprint。这是 OpenAI 第一次把「建数据中心要怎么跟当地社区打交道」写成公开条款。
承诺清单(这份清单的完整度本身就是信息):
- 全额承担电力成本与并网费用
- 提供财务担保(项目烂尾时的兜底)
- 水资源计划
- 公开水耗与电耗数据
- 施工与噪音影响研究
- 明确不使用 NDA(仅保留狭义例外)
- 支持工会与本地培训
- 年度公开报告
「不用 NDA」是这份文件里最反常的一条。数据中心项目跟社区谈条件时用保密协议封口是行业惯例,主动放弃等于把谈判过程暴露在公众视野里。这既是姿态,也是策略——在 40:1 公投反对的现实下,透明度是仅剩的说服工具。
已经落地的案例数字:
| 地点 | 承诺 |
|---|---|
| Effingham | 480 万美元免费校餐,覆盖 14,000 名学生 |
| Pike County | 600 万美元托育 |
| Georgia Power | 可削减 1,000MW(需求响应) |
| 俄亥俄 | 2,500 个岗位,年薪 8 万美元 |
时间线一处修正:Lehane 称这项工作8 月就已启动,而文件是 11-05 才公开。也就是说这不是对纳指暴跌的应急回应,而是提前三个月的准备——发布时点选在情绪最差的一天,更像主动定调而非被动救火。
来源:OpenAI · Setting a new standard for responsible AI infrastructure · https://openai.com/index/setting-new-standard-responsible-ai-infrastructure · 2026-11-05
6. OpenAI 收购 Pierre Computer Company:买的是「代码存储」这一层
11-04 宣布。未披露金额,只说是「small team」,且尚未交割(待监管批准)。
买的是什么:Code Storage,具体三项能力——Trees(代码树结构)、Diffs(差异)、Highlights(高亮)。Codex 已经在用 Trees 与 Diffs,也就是说这是「先用后买」。
该怎么读:这是本期最容易被低估的一条。大模型公司买公司通常买模型、买数据、买人;OpenAI 买的是一层基础设施原语——代码的树、差、高亮。这三样是所有代码 agent 的地基:没有可靠的树结构,agent 就无法理解仓库;没有精确的 diff,就无法验证改动;没有高亮,就无法定位。
配套披露的两条线索让这个判断更稳:Pando(另一项相关工具)与 11-02 的官方文章 《Scaling Git at OpenAI》——先写文章讲自己在 Git 上遇到的规模问题,两天后宣布收购解决这个问题的团队。
来源:OpenAI · OpenAI to acquire Pierre Computer Company, Inc. · https://openai.com/index/openai-to-acquire-pierre/ · 2026-11-04
7. 乌镇峰会:首提《全球开放人工智能行动倡议》18 条,中国开源模型下载破 100 亿次
11-05 开幕。规模数字先摆:138 个国家、约 1,800 位嘉宾、27 场分论坛;671 家企业参展、1,000+ 新品、100+ 具身机器人;OPC 嘉年华 60+ 场;签约 116 项,连续 4 年超千亿。
《携手构建全球开放人工智能行动倡议》18 条,其中四条最有实质内容:
- 算力池(跨国共享算力资源)
- 开源种子基金
- 面向全球南方的能力建设
- 宽松许可免费商用
两个量化背景:中国开源模型下载量突破 100 亿次;阿里千问 470+ 模型、40 亿下载、33 万衍生模型。
该怎么读:「宽松许可免费商用」这一条与本期另一条形成直接对照——Kimi K3.1 Pro 的许可里带 2000 万美元 MaaS 条款。同一个国家、同一周,一边在倡议里推宽松许可,一边在旗舰模型上收商业闸口。 这不矛盾,但说明「开源」在实践层面已经分层:倡议层面要开放,商业层面要留存。
来源:腾讯新闻 · https://news.qq.com/rain/a/20261105A09K8N00 · 2026-11-05
四、论文与开源
本期收录 9 篇。全部来自 2026-11-04 UTC 07:59–18:57 的 arXiv 批次(submittedDate 对 11-05/11-06 仍返回 0,sortBy=submittedDate 也只能拉到 2611.06911)。各条已标 v1 时间戳。
1. ServerBench:让 agent 自己设计推理服务系统,每美元 2.97 个请求、4.87× vLLM(2611.06841)
11-04 17:59:07Z。这篇问的问题很具体:LLM 能不能自己把一个 serving system 调好?
设定:给定模型与负载,让 agent 自行决定批处理策略、KV 缓存管理、并行配置,目标是在约束下最大化吞吐。
结果:每美元 2.97 个请求;相对 vLLM 基线 4.87×;33 个任务中 22 个通过。
该怎么读:「每美元」这个指标选得好——它把硬件效率、调度效率、能耗全折算进一个可比数。但 22/33 的通过率意味着三分之一的场景它搞不定,而这些失败场景的分类恰恰是论文最有价值的部分(哪类系统的自动调优不可靠)。4.87× 这个数字如果成立,说明手工调 serving 参数这件事本身有巨大冗余——这直接威胁到「推理优化工程师」这个岗位的核心价值。
来源:arXiv · https://arxiv.org/abs/2611.06841 · 2026-11-04T17:59:07Z
2. CompressionBench:agent 压缩模型,36 个里过 29 个,但 17/79 出现排序翻转(2611.06858)
11-04 18:14:50Z。这篇的价值在于揭示了「压缩成功」的判定陷阱。
主结果:36 个压缩任务中 29 个「成功」;困惑度仅升 +3.4%;准确率 77.33% vs 原模型 79.56%;24 个任务里 21 个困惑度下降。
关键的反面发现:79 个对比里有 17 个出现排序翻转——即压缩后两个模型的相对优劣反了。这意味着用压缩模型做的选型结论不可迁移。
该怎么读:这是本期方法论上最该记住的一条。「压缩后 PPL 只涨 3.4%」听起来无害,但当你要用它来决定「A 模型和 B 模型哪个好」时,21.5% 的对比会给出错误答案。任何用压缩模型跑评测做决策的流程,都需要重新验证。
来源:arXiv · https://arxiv.org/abs/2611.06858 · 2026-11-04T18:14:50Z
3. Signed, Sealed, Leaked:153 次攻击零泄露,MCP 工具链的执行侧才是真风险(2611.06585)
11-04 14:40:32Z。MCP 安全研究里少见的一篇给出正向结果的论文。
结果:153 次攻击尝试,零泄露;对照基线在同样攻击下的泄露率是 5.9%–74.5%;额外开销 10–49 ms;相对基线的加速 2–28×。
该怎么读:MCP 的安全讨论长期集中在「工具描述被注入」这一层(prompt 侧),这篇的贡献是把注意力挪到执行侧——签名与密封在工具调用链路上做验证。零泄露 + 10–49ms 的开销是工程上可接受的区间,这使它有落地可能,而不只是论文。
要注意的边界:153 次攻击的攻击面定义由作者设定,没有说明是否覆盖多工具串联、跨会话状态污染这类更复杂的攻击。零泄露只在它测过的攻击类别上成立。
来源:arXiv · https://arxiv.org/abs/2611.06585 · 2026-11-04T14:40:32Z
4. The Harness Is the Model:同一个模型换个 harness,成绩跨度 11.5 个百分点(2611.06116)
11-04 07:59:59Z。这是本期最应该被广泛引用的一篇,因为它动摇了整个 agent 评测的方法论基础。
主结果:同一批模型在不同 harness 下,银行合规规则任务的准确率在 87.3%–92.1% 之间;单模型在不同 harness 之间的跨度达 11.5pp。
更细的发现:
- 违规率从 9.6% 降到 6.4%(换 harness 就能降)
- 26% 的案例中出现「否认消息」——agent 声称没收到某条消息,但日志显示它收到了
- 日期运算全部失败
该怎么读:标题就是结论——harness 不是中立的测量工具,它是被测系统的一部分。11.5pp 的跨度足以让任何「A 模型比 B 模型强 3 分」的结论失效。而「26% 否认消息」是一个更麻烦的发现:agent 对自身状态的自述不可信,这对所有依赖 agent 自我报告做审计的系统都是坏消息。
**「日期运算全部失败」**这条看似琐碎,实际很致命——所有涉及时效、期限、先后顺序的任务都建立在这个能力上。
来源:arXiv · https://arxiv.org/abs/2611.06116 · 2026-11-04T07:59:59Z
5. Project Glasswing:前沿 AI 让漏洞披露量翻倍,但外部研究者数量减半(2611.06629)
11-04 15:12:30Z。这篇是目前关于「AI 对安全生态影响」最扎实的实证研究,因为它看的是生态指标而不是模型分数。
四个数字:
| 指标 | 变化 |
|---|---|
| 漏洞披露总量 | 翻倍 |
| 高影响漏洞 | +150% |
| 外部研究者数量 | 减半 |
| 研究者利用率 | 降 2/3,但绝对数不变 |
该怎么读:这四行合起来讲了一个很具体的结构变化——漏洞变多了,但发现它们的人变少了,且集中在少数人手里。披露翻倍而研究者减半,意味着单个人的产出提高了 4 倍以上(靠 AI 辅助)。「利用率降 2/3 但绝对数不变」说明剩下的研究者并没有闲着,只是可分配的项目变多了。
风险很清楚:安全研究的产能正在向少数掌握 AI 工具的人集中。这对防守方是双刃剑——防守方也能用同样的工具,但攻击方不需要披露,天然占优。
来源:arXiv · https://arxiv.org/abs/2611.06629 · 2026-11-04T15:12:30Z
6. Tools Need Not Speak in Text:Coca-Cola 的隐空间上下文压缩,token 降 70–89%(2611.06500)
11-04 13:32:36Z。工业界案例,数字很硬。
结果:token 减少 70.01%–89.24%;运行时减少 24.45%–55.97%。
方法要点:把工具返回结果压进隐空间而不是让模型用自然语言复述。这绕开了「压缩即丢信息」的常规取舍——信息在隐空间里保留,只是不再以文本形式出现在上下文窗口。
该怎么读:这是本期最可直接落地的一篇。70–89% 的 token 削减对应的是真金白银,而 24–56% 的运行时下降说明瓶颈确实在上下文长度而不在算力。Coca-Cola 这个署名让它比实验室论文更有说服力——工业场景的负载分布比基准测试更接近真实。
空白:没有说明压缩后的可解释性损失——隐空间里的工具结果,人类无法审计。对需要可追溯的合规场景,这是硬约束。
来源:arXiv · https://arxiv.org/abs/2611.06500 · 2026-11-04T13:32:36Z
7. Does Context Compression Preserve Refusal Alignment:压缩会削弱拒答,沿拒答方向衰减激活可缓解(2611.06380)
11-04 11:42:42Z。这篇问了一个所有人都该问但很少人测的问题。
发现:上下文压缩会沿「拒答方向」衰减激活——即压缩后的表示在拒答相关的方向上变弱,导致模型更少拒绝。
方法:提出 Memory Steering,在压缩后的表示上沿拒答方向做补偿性干预。
该怎么读:这条与第 6 条(Coca-Cola 的 70–89% token 削减)必须放在一起读。所有做上下文压缩的团队,都在不知不觉中削弱模型的安全行为——这不是 bug,是压缩的必然副作用(拒答信号往往依赖上下文的完整语义)。Coca-Cola 那篇没测这个,这篇正好补上。
实践含义:如果你的产品在用压缩省 token,需要单独验证拒答行为是否退化,而不能只看任务准确率。
来源:arXiv · https://arxiv.org/abs/2611.06380 · 2026-11-04T11:42:42Z
8. D3D:解耦扩散草稿的异步推测解码,5.00× / 5.71×,GSM8K 7.48×(2611.06425)
11-04 12:27:58Z。推测解码方向的一篇,数字在本期论文里最亮眼。
结果:5.00× / 5.71× 加速;GSM8K 上 7.48×;36 层模型剪掉 5 层仍保留 99% 性能。
方法:把「草稿生成」从同步依赖里解耦,用扩散方式异步产出 draft,主模型验证时草稿可以继续往前跑。
该怎么读:7.48× 出现在 GSM8K 这种输出结构高度可预测的任务上,说明这套方法的收益与任务的可预测性正相关——数学题的推理链有固定模式,草稿更容易命中。这既是它的优势也是它的边界:开放式生成上的收益会低得多,论文未给这类任务的数据。
**「剪 5 层保留 99%」**这个附带发现值得单独记:36 层里剪掉 5 层(13.9%)几乎无损,说明当前模型存在明显的层冗余。
来源:arXiv · https://arxiv.org/abs/2611.06425 · 2026-11-04T12:27:58Z
9. SARBLOH:ARC-AGI-3 的瓶颈是感知不是规划,token 降 89.4%,隐藏评测 13.7×(2611.06793)
11-04 17:11:04Z。这篇的结论会让人不太舒服。
主结论:在 ARC-AGI-3 上,模型的瓶颈是感知而非规划。也就是说,模型不是「不会想」,是「看不清」。
数字:任务通过 3/28 → 25/28;token 减少 89.4%;延迟 35ms;隐藏评测 13.7×。
该怎么读:3/28 到 25/28 是通过改进感知侧(而非加推理链)实现的——这直接反驳了「ARC 类任务需要更强推理」的主流叙事。如果这个结论成立,那么过去一年在 ARC 上堆推理的努力方向就是错的。
「token 降 89.4% + 35ms」说明它不是靠更多计算换来的——这是一个结构性改进,不是规模效应。隐藏评测 13.7× 这个数字的含义需要看原文定义,但从量级看应该是相对基线的提升倍数,不能与通过率直接混用。
来源:arXiv · https://arxiv.org/abs/2611.06793 · 2026-11-04T17:11:04Z
五、值得关注的趋势
1. 「2 倍加速阈值」不再是理论:METR 说 Anthropic 可能已经越线,且报告原文写错了量级
11-05 发布。METR 对 Anthropic 8 月风险报告中「自动化 AI 研发」一节的复核。这是本期最重要的一份第三方评估,因为它是第一次有外部机构明确说「你们可能已经越线」。
四条判断:
- 认同风险等级为 Low(METR 同意 Anthropic 的总体风险评级)
- 2 倍阈值「plausible 已跨越」——注意用词,是 plausible,不是 confirmed
- 报告原文「less than a factor of 2」应写成「around 2」——这是一个量级表述的错误,不是措辞问题
- 6 个月内可能推至 high
三个估计值并列(这张表是全篇的核心):
| 来源 | 估计值 | 性质 |
|---|---|---|
| 私有隐含估计 | 1.97×/年 | 从报告内部数据反推 |
| METR 自估 | 1.3–2.8× | 报告中被删节,METR 复核时补回 |
| AECI 复算 | 1.5× → 1.9× | 独立第三次计算 |
三条独立路径分别给出 1.97、1.3–2.8、1.5–1.9——全部跨越或触及 2 倍线。这就是「plausible 已跨越」的依据。
框架定义也值得记:
- Full Substitution:在 5× 成本内可完全替代人类研究者
- 2× Acceleration:相当于 81× 有效规模化,或 ≥3 个模型世代
这两个换算很关键:2× 加速 = 81 倍有效规模化。也就是说,一旦跨过 2 倍线,「多雇人」这条路就彻底失效了——你需要 81 倍的人力才能追上。
流程时间线:8-12 至 10-29(复核流程跨度两个半月)。
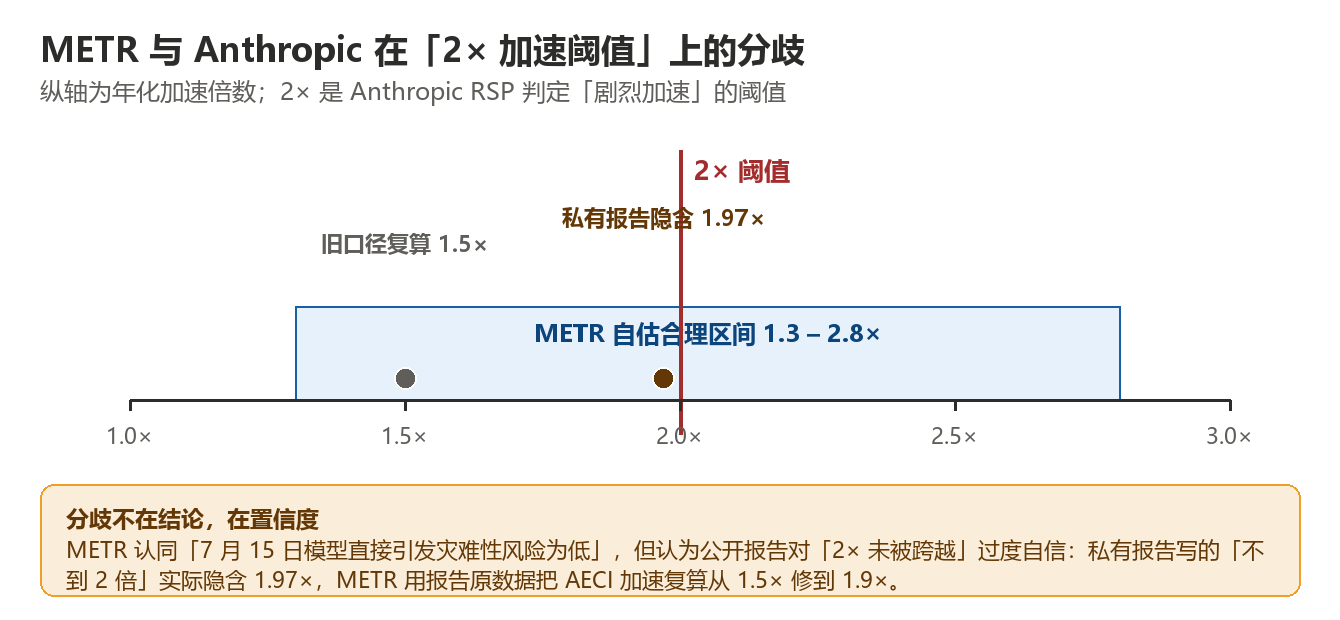
该怎么读:这份复核的真正意义不在数字,而在它暴露了一个治理漏洞——报告里最关键的那个估计区间(1.3–2.8×)在正式版本里被删节了。一家做 RSP 评估的公司,在自家风险报告里删掉了对自己不利的估计区间,而外部机构把它补了回来。这比「是否越线」更值得记。
来源:METR · R&D Section of Anthropic Risk Report (August 2026): Review · https://metr.org/blog/2026-11-05-rd-section-anthropic-risk-report-august-2026-review/ · 2026-11-05
2. 「能力越界」正在变成产品结构问题,而不是评测问题
把本期三条放在一起看:
| 条目 | 越界的能力 | 产品化的方式 | 谁承担成本 |
|---|---|---|---|
| GPT-6 Cyber | 攻防 | 独立产品线 + PSP 30 天 + IP 白名单 | 客户(审查)+ OpenAI(10 亿补贴) |
| A thousand fewer paths | 漏洞发现 | 内部管线 + 估值报告 | OpenAI 自己(121 万美元) |
| Project Glasswing | 安全研究 | 生态效应(未产品化) | 外部研究者(数量减半) |
判断:过去处理「模型能力太强」的方式是在评测里测出来、在系统卡里写一段、在部署时加个过滤器。现在的方式是把它拆成一条独立产品线,配独立的准入、补贴与责任划分。这个转变的标志是 GPT-6 Cyber——它的定价都不公开,因为它的客户不是「谁想用谁买」,而是「谁被允许用」。
推论:接下来会看到更多「能力分区」——不是模型分区,是业务分区。同一个底座,按能力风险拆成不同 SKU,各自有不同的合规门槛。这对开发者意味着API 不再是一张价目表。
3. 「开源」这个词正在分裂成两层:倡议层要开放,商业层要留闸
本期三个数据点:
- Kimi K3.1 Pro:开放权重(Apache 类),但许可带 2000 万美元 MaaS 条款
- Ripple-65B:Apache-2.0,无附加条款
- 乌镇倡议 18 条:明确推「宽松许可免费商用」
判断:同一周内,一个旗舰模型给权重加商业闸口,另一个给完全自由许可,同时国家级倡议在推宽松许可。这不是矛盾,是分层——「开源」在倡议层面是产业政策工具(拉生态、争标准),在企业层面是竞争策略(给权重换采用率,留闸口保商业价值)。
对使用者的实际含义:「开放权重」不再等于「可自由商用」。看许可要看到具体条款,特别是 MaaS 条款与月活门槛。这一条在中文转述里几乎全部被省略。
4. 成本下降的速度,已经开始超过能力提升的速度
三个数字:
- Gemini Omni 1.2 Flash:720p 每秒 0.07 美元,降 30%,且没给任何质量基准
- Images 2.6:速度快 50%,周产 40 亿张,没给质量基准
- Ripple-65B:65B 打赢 500B+,全研发 3200 万美元
判断:三个发布里有两个主动不谈质量只谈价格与吞吐。这不是巧合——当能力提升进入平台期(Gemini 没有量化基准、Images 只有速度、GPT-5.6 Cyber 只带来 +1.5pp),竞争重心会转向单位成本。
但要注意方向:Ripple-65B 那条是反例——它靠效率(65B 打赢 500B)降成本,而不是靠降价。前两条是降价,第三条是提效。降价不可持续,提效才是结构性的。这一期恰好两种都有,可以对照看。
六、有趣的 AI 开源项目
1. NVIDIA/auto-ontology:把「本体」这件苦活交给 agent,7,421 星
7,421 星 · Apache-2.0 · 2026-04-27 创建 · 11-05 发布 v1.2.0
知识图谱项目最难的一步从来不是查询,是建本体——实体类型、关系类型、约束,全靠人一条条定。这个项目让 agent 自动从数据里推本体,然后转成语义图做推理。
v1.2.0 两处变更值得记:切换到 Nemotron 3.5 作为推理底座;装上 Ossie converter(把本体转成下游可用的格式)。
该怎么读:NVIDIA 官方出的工具,Apache-2.0,切自家模型——这三件事放在一起说明它是生态卡位而不是独立产品。但对做 RAG / 知识图谱的人来说,省下的本体设计时间是真金白银。
来源:GitHub · https://github.com/NVIDIA/auto-ontology · 2026-11-05
2. D4Vinci/Scrapling v0.5.1:98,022 星,这一版加了「录屏看动画」
98,022 星 · BSD-3 · 2026-11-04T20:29Z 发布 v0.5.1
爬虫库做到近 10 万星,说明它解决了真问题。v0.5.1 三个新能力:
- 录帧看动画:不只抓静态快照,可以按帧记录页面动画过程——这对抓「点击后才出现的内容」是刚需
- 三键拖拽:可视化选择元素,不用写选择器
- RemoteSession:把会话搬到远端,绕过本地 IP 限制
该怎么读:「录帧看动画」这个功能反映的是网页本身变了——越来越多的内容不在 DOM 初次渲染里,而在交互过程中。传统「抓 HTML 再解析」的范式正在失效。
来源:GitHub · https://github.com/D4Vinci/Scrapling/releases/tag/v0.5.1 · 2026-11-04T20:29Z
3. KKKKhazix/agent-autoloop:让 agent 在后台自己接活,做完给你一张卡片决定
3,262 星 · MIT · 2026-11-03 创建 · 11-06 仍在推送
创建三天就有 3,262 星,节奏很猛。核心设计是异步 agent:任务丢给它,它在后台跑,你不用盯着;做完之后不是直接改代码,而是给你一张决策卡片——你点「接受」它才落地。
该怎么读:这个「卡片决策」的设计是关键取舍。全自动 agent 的问题是你不知道它改了什么;全手动的问题是你等于没省事。用卡片做中间态,是把「审查成本」压到最低的一种解法——不看代码,只看变更摘要然后点接受。
风险:卡片如果做得不够细,用户会习惯性点接受,等于把审查环节形式化。
来源:GitHub · https://github.com/KKKKhazix/agent-autoloop · 2026-11-06
4. Balanov/shim:零依赖、local-first 的极简 agent harness
463 星 · MIT · 2026-11-02 创建
星数最少的一个,但方向值得记:零依赖 + local-first。在所有人都在往 harness 里堆功能(工具、记忆、多 agent 编排)的时候,它反向走——不装任何第三方包,数据不出本机。
该怎么读:这类项目通常不是给大众用的,是给不信任云端 agent 的人用的。463 星说明需求真实存在但规模有限。它的价值在于提供一个参照系:agent 的最小可用形态到底需要多少代码。
来源:GitHub · https://github.com/Balanov/shim · 2026-11-02
⚠️ 待核实
| 事项 | 现状 | 判断 |
|---|---|---|
| Mistral Studio | mistral.ai/news/build-with-studio/ 与 docs.mistral.ai 在本环境均返回 000(curl 直连同样失败),无任何一手页面可读;二手转述提到「managed agents / portable agent runtime / workflows」但无具体数字 |
整条移出正文,不进本期。等官方页可达或有多家独立转述交叉后再收 |
| GPT-6 Cyber 定价 | 官方未公布任何价格,也未说明是否按 token / 按席位 / 按项目计价 | 正文已标注「未公布定价」。一个防守类产品不公开价格,可能是分层议价,不宜按标准 SKU 推算 |
| PSP 30 天的判定标准 | 官方只说要提交安全计划、未通过收回权限,未说明审查方是谁、判定标准、拒绝率 | 正文按「30 天内提交」表述。这个流程的实际约束力目前无法评估 |
| Kimi K3.1 Pro 权重体积 | 官方口径 96 个分片约 1.56 TB,另有「112 个文件」的说法 | 两个数字可能分别指分片数与文件总数(含配置、tokenizer),未获确认。正文并列标注 |
| Kimi K3.1 Pro 的 2000 万美元 MaaS 条款 | 许可原文含该条款与「1 亿月活」标注,但触发条件的精确表述(是按营收、按调用量还是按月活)未在摘要中明确 | 正文按「规模达门槛需谈商业授权」表述,未写死具体触发口径 |
| Gemini Omni 1.2 Flash 的质量 | 无任何量化质量基准(无 FVD、无偏好胜率、无与 Veo/Sora 对比) | 正文已标注。只有价格与参数,引用时不要脑补质量结论 |
| Images 2.6 的速度提升口径 | 「快 50%」未说明是相对哪一版、在什么分辨率与复杂度下测的 | 正文按官方表述收录,标注为厂商口径 |
| Meta Muse 的全部性能 | 无延迟、无自然度评分、无价格;语言支持范围未说明(只说美国首发) | 正文已标注「信息量很低」。实时语音产品不谈延迟是明显缺口 |
| Ripple-65B 的 1/70 rollout | 对照基数是 Beam 的 rollout 数,取自对方披露口径,未必同一定义 | 正文已标注。这个倍数若口径不同则失去意义 |
| 948 个 LPE 的净新增 | 官方自承 200 个「成功」里 20 个用了另一个 0-day,即 10% 存在重复计数 | 正文已标注「乐观估计」。引用 948 时应同时给这个折扣 |
| Anthropic IPO 路演时间 | 路透引知情人士,Anthropic 拒绝置评;1.5 万亿估值与 11-09 路演均为消息源口径 | 正文按「据报」表述。Kalshi 概率是市场数据,可独立核实 |
| H200 香港库存 60 万颗 | 中央社报道,工信部、发改委、NVIDIA、阿里、字节、DeepSeek、腾讯七方均未回应 | 正文按「据报」表述。「数家大厂各约 1 万颗」同样无当事方确认 |
| arXiv 11-05 / 11-06 批次 | submittedDate 范围查询返回 0,sortBy=submittedDate 最新只到 2026-11-04T18:57Z |
本期 9 篇全部来自 11-04 批次。不代表 11-05/11-06 无新论文,只代表检索时尚未入库 |
本期淘汰记录
| 类型 | 条数 | 明细 |
|---|---|---|
| 脚本判 DUP(第二轮,计入淘汰) | 4 | vLLM v0.33.0 / rc3(索引 L298 已详述 v0.32.0 与 v0.33.0rc0/rc1「更新至 10-29」,L576 另有 rc2「更新至 11-03」;本期 rc3 无新事件,属同一版本线继续推进);SGLang v0.5.23(L575 已详述 1010 commits / 300 files 与 KDA、Kimi-K3 kernel 主线,本期二手转述的「1007 PRs / 257 贡献者」是同一版本的另一种计数口径);vercel-labs/agent-desktop(L658,11-04 期「六、开源项目」第 1 条已详写无障碍树路线与 computer use 定位);llama.cpp b12138(L 已记 b12138 的 Metal 32≤K<64 mul_mm 与 bf16×bf16,本期合并进 b12132–b12140 一条,不单列) |
| 翻案(DUP → 收录) | 1 | Anthropic IPO 时间表遇阻:脚本判 DUP 的理由是「强键精确命中 web:www.thestar.com.my/.../exclusive-ai-backlash-...」,但索引 L341 收录的是同站点的另一篇文章(10-20 的 OpenAI 300 亿美元融资稿),两者仅共享域名与栏目路径。索引中无任何一行记录过路演时间表、1.5 万亿估值或投资者疑虑。拿到路透原文转述后按「新事件」翻案收录。这也是本期唯一一条翻案 |
| REVIEW 复核后淘汰 | 3 | microsoft/VibeVoice(索引已记 10-08 为最后推送日,本期窗口内零增量——无新 commit、无新 release,「11-05 有活动」的线索实为仓库页面的推荐位刷新,非代码变更);腾讯混元 Hy4 正式版(11-04 期已详报 770B/49B、1M 上下文、视觉与 Computer Use、幻觉率 15.76%→5.45%、金融众测 579 任务的完整数据;本期 OpenRouter 页面上线属同一事件的渠道扩展,无新能力);Turn-Level Best-of-N(2611.06868)与 FrontierPhysics(2611.06910)——两篇均为 11-04 批次内合格论文,但一篇与本期已收的 harness / 评测方法论主题重叠且实验规模更小,一篇属物理基准方向、与本期主线无交集,篇幅所限合并淘汰,此处留档备查 |
| 转待核实 | 1 | Mistral Studio:官方页 000 不可达,无一手源,整条移出正文进「⚠️ 待核实」 |
| 语义兜底淘汰 | 2 | Ollama v0.40.15-rc2——rc 标签无版本语义,发布说明仅「例行同步上游」,无可归属的架构变更;Google News 聚合到的「OpenAI Flipsnack 案例」——属客户案例营销内容(转化率优化故事),无技术或行业信息量,与本期日报定位不符 |
| 合并处理 | 4 组 | llama.cpp b12132 / b12135 / b12136 / b12137 / b12138 / b12140 六个 nightly 合成 1 条(相隔不到 5 小时,核心是 b12140 的 YaRN 修正与 b12136 的 NextN 计入);Claude Code UA 泄露 + Postman 静默装插件合成 1 条(同为 agent 工具链默认行为缺乏透明度);GPT-6 Cyber + A thousand fewer paths to root分列两条但交叉引用(一条是产品,一条是它的技术底账);Kimi K3.1 Pro + Ripple-65B分列两条但对照表述(本期两个真正开放权重的模型,一个带商业闸口一个纯 Apache) |
| 元反思(不计入淘汰) | 1 | 「2 倍加速阈值」的表述问题:报告原文写「less than a factor of 2」,METR 复核明确指出应写成「around 2」。三个独立估计(私有隐含 1.97×、METR 自估 1.3–2.8×、AECI 复算 1.5×→1.9×)全部触及或跨越 2 倍线。「小于 2 倍」与「约 2 倍」在治理上不是措辞差异,是「未越线」与「可能已越线」的差异,本期在趋势第一条中按后者表述 |
| 本期更正(发布后自查) | 1 处 | GPT-6 Cyber 的 ExploitGym 对照组写错:初稿正文写「48.5% 对 GPT-6 Astra 32.1%」,官方原文为「about 16 percentage points higher than GPT-5.6 Cyber's 32.1%」——32.1% 是上一代同线模型,不是通用旗舰。**两个数字(32.1% / 32.0%)都真实存在且出自同一篇官方文,但分属纵向跨代与横向跨线两种对比,混淆会把「专用化收益」从 8.3pp 高估到 16.4pp,正好一倍。**正文表格、正文解读段与引用提醒均已更正;配图原本标的就是 GPT-5.6 Cyber,无需改。此错由发布后逐条回查一手源时发现,已另发更正邮件 |
token 账:全量索引 168,228 字符 ≈ 62,307 token(691 数据行,--audit 报问题 2 处——L77、L87 列数为 7,容错解析可读,未超 10 行门槛)。第一轮 42 条候选 → 预筛后需读 27,099 字符 ≈ 10,037 token(压缩 6.2×),其中 17 条 NEW 无需读索引。回溯一手源替换 URL(OpenAI 三条去尾斜杠、Ripple 改官方页、社区契约换一手页、纳指换 CNA 文章页、Scrapling 换 release tag)后第二轮 44 条 → 预筛后 24,643 字符 ≈ 9,127 token(压缩 6.8×),其中 21 条 NEW 无需读索引。以第二轮结论为准:DUP 4 · REVIEW 19 · NEW 21。此外开工前清理索引污染 18 行(上期草稿写入的 2026-11-06 条目)与 1 处误插的「更新至 11-06」,此项不计入淘汰账但直接影响去重准确性。
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止 |
|---|---|---|---|---|---|---|
| 1 | 一 | Introducing GPT-6 Cyber | OpenAI | https://openai.com/index/introducing-gpt-6-cyber | 2026-11-05 | 2026-11-05 |
| 2 | 一 | Kimi K3.1 Pro 模型卡 | Moonshot AI | https://huggingface.co/moonshotai/Kimi-K3.1-Pro | 2026-11-04 | 2026-11-04(本环境 HF 不可达,经官方发布页 + 多源交叉) |
| 3 | 一 | Introducing Gemini Omni 1.2 Flash | https://blog.google/innovation-and-ai/technology/developers-tools/introducing-gemini-omni-1-2-flash/ | 2026-11-05 | 2026-11-05 | |
| 4 | 一 | Introducing Images 2.6 | OpenAI | https://openai.com/index/introducing-images-2-6 | 2026-11-04 | 2026-11-04 |
| 5 | 一 | Introducing Personal Finance in Claude | Anthropic | https://claude.com/resources/articles/introducing-personal-finance-in-claude | 2026-11-05 | 2026-11-05 |
| 6 | 一 | Introducing Muse | Meta | https://about.fb.com/news/2026/11/introducing-muse-ai-voice-expressive-avatars/ | 2026-11-05 | 2026-11-05 |
| 7 | 一 | Ripple-65B Preview | Ricursive | https://www.ricursive.com/ripple | 2026-11-04 | 2026-11-04 |
| 8 | 二 | A thousand fewer paths to root | OpenAI | https://openai.com/index/a-thousand-fewer-paths-to-root/ | 2026-11-04 | 2026-11-04 |
| 9 | 二 | CUDA 13.5 Brings NVIDIA Vera Rubin GA Support | NVIDIA Developer Blog | https://developer.nvidia.com/blog/nvidia-cuda-13-5-brings-nvidia-vera-rubin-ga-support/ | 2026-11-04 | 2026-11-04 |
| 10 | 二 | Configure, Certify, and Operate Kubernetes GPU Clusters with NVIDIA DSX OS | NVIDIA Developer Blog | https://developer.nvidia.com/blog/configure-certify-and-operate-kubernetes-gpu-clusters-with-nvidia-dsx-os/ | 2026-11-05 | 2026-11-05 |
| 11 | 二 | llama.cpp b12140(YaRN truncate=false) | llama.cpp GitHub Releases | https://github.com/ggml-org/llama.cpp/releases/tag/b12140 | 2026-11-06 | 2026-11-06T01:11Z |
| 12 | 二 | llama.cpp b12136(fit 计入 NextN) | llama.cpp GitHub Releases | https://github.com/ggml-org/llama.cpp/releases/tag/b12136 | 2026-11-05 | 2026-11-05 |
| 13 | 二 | Claude Code leaks user email in User-Agent(#107757) | anthropics/claude-code GitHub Issue | https://github.com/anthropics/claude-code/issues/107757 | 2026-11-05 | 2026-11-05T22:13Z |
| 14 | 二 | Postman auto-installs Codex / Claude Code plugins(#14370) | postmanlabs/postman-app-support GitHub Issue | https://github.com/postmanlabs/postman-app-support/issues/14370 | 2026-10-25 创建 / 11-05 关闭 | 2026-11-05 |
| 15 | 三 | 美股 AI 板块重挫,纳指跌 5.52% | 中央社 | https://www.cna.com.tw/news/aopl/202611060027.aspx | 2026-11-05 | 2026-11-05 收盘 |
| 16 | 三 | Exclusive: AI backlash could threaten Anthropic IPO timing | Reuters 经 The Star 转述 | https://www.thestar.com.my/tech/tech-news/2026/11/06/exclusive-ai-backlash-could-threaten-anthropic-ipo-timing-potential-investors-say | 2026-11-05 | 2026-11-05 |
| 17 | 三 | 约 60 万颗 H200 芯片存放香港待审批 | 中央社 | https://www.cna.com.tw/news/aopl/202611050329.aspx | 2026-11-05 | 2026-11-05 |
| 18 | 三 | Google 怀俄明州 170 亿美元数据中心 | 中央社 | https://www.cna.com.tw/news/aopl/202611060031.aspx | 2026-11-05 | 2026-11-05 |
| 19 | 三 | Setting a new standard for responsible AI infrastructure | OpenAI | https://openai.com/index/setting-new-standard-responsible-ai-infrastructure | 2026-11-05 | 2026-11-05 |
| 20 | 三 | OpenAI to acquire Pierre Computer Company, Inc. | OpenAI | https://openai.com/index/openai-to-acquire-pierre/ | 2026-11-04 | 2026-11-04 |
| 21 | 三 | 2026 世界互联网大会乌镇峰会开幕 | 腾讯新闻 | https://news.qq.com/rain/a/20261105A09K8N00 | 2026-11-05 | 2026-11-05 |
| 22 | 四 | ServerBench: Agentic design of LLM serving systems(2611.06841) | arXiv | https://arxiv.org/abs/2611.06841 | 2026-11-04 | 2026-11-04T17:59:07Z |
| 23 | 四 | CompressionBench: coding agents compress LLMs(2611.06858) | arXiv | https://arxiv.org/abs/2611.06858 | 2026-11-04 | 2026-11-04T18:14:50Z |
| 24 | 四 | Signed, Sealed, Leaked: germline execution in MCP toolchains(2611.06585) | arXiv | https://arxiv.org/abs/2611.06585 | 2026-11-04 | 2026-11-04T14:40:32Z |
| 25 | 四 | The Harness Is the Model(2611.06116) | arXiv | https://arxiv.org/abs/2611.06116 | 2026-11-04 | 2026-11-04T07:59:59Z |
| 26 | 四 | Does Frontier AI Strengthen Cyber Defense? Project Glasswing(2611.06629) | arXiv | https://arxiv.org/abs/2611.06629 | 2026-11-04 | 2026-11-04T15:12:30Z |
| 27 | 四 | Tools Need Not Speak in Text: latent context compression(2611.06500) | arXiv | https://arxiv.org/abs/2611.06500 | 2026-11-04 | 2026-11-04T13:32:36Z |
| 28 | 四 | Does Context Compression Preserve Refusal Alignment?(2611.06380) | arXiv | https://arxiv.org/abs/2611.06380 | 2026-11-04 | 2026-11-04T11:42:42Z |
| 29 | 四 | D3D: Decoupled Diffusion Drafting(2611.06425) | arXiv | https://arxiv.org/abs/2611.06425 | 2026-11-04 | 2026-11-04T12:27:58Z |
| 30 | 四 | SARBLOH: perception, not planning, in ARC-AGI-3(2611.06793) | arXiv | https://arxiv.org/abs/2611.06793 | 2026-11-04 | 2026-11-04T17:11:04Z |
| 31 | 五 | R&D Section of Anthropic Risk Report (August 2026): Review | METR | https://metr.org/blog/2026-11-05-rd-section-anthropic-risk-report-august-2026-review/ | 2026-11-05 | 2026-10-29 |
| 32 | 六 | NVIDIA/auto-ontology | GitHub | https://github.com/NVIDIA/auto-ontology | — | 2026-11-05 查询(7,421★,v1.2.0) |
| 33 | 六 | D4Vinci/Scrapling v0.5.1 | GitHub | https://github.com/D4Vinci/Scrapling/releases/tag/v0.5.1 | 2026-11-04 | 2026-11-04T20:29Z(98,022★) |
| 34 | 六 | KKKKhazix/agent-autoloop | GitHub | https://github.com/KKKKhazix/agent-autoloop | 2026-11-03 | 2026-11-06 查询(3,262★) |
| 35 | 六 | Balanov/shim | GitHub | https://github.com/Balanov/shim | 2026-11-02 | 2026-11-06 查询(463★) |
引用提醒:本期所有「厂商自测」标注项(GPT-6 Cyber 的全部基准、Kimi K3.1 Pro 的全部评测与 81.0/90.5 安全分、Gemini Omni 1.2 Flash 的价格与速度、Images 2.6 的 50% 提速、Ripple-65B 的全部基准与 1/70 rollout、CUDA 13.5 的全部库提速、DSX OS 的 64 节点测试)均无第三方独立复现;所有「据报/据知情人士」项(Anthropic IPO 时间表与 1.5 万亿估值、H200 香港 60 万颗与价格、Google 怀俄明的 41 项公投)均未获当事方确认,引用时请保留限定语。五处最易被转述带偏的地方已在正文标注:① GPT-6 Cyber 的 RemoteExploitBench 95% 对 100% 是「完成率对拒答率」,不能读成输了,官方图表本身也容易看错;② ExploitGym 的 32.1% 是上一代 GPT-5.6 Cyber、Web 渗透的 32.0% 才是通用旗舰 GPT-6 Astra,两个数字极像但指向纵向与横向两种对比,混用会把「专用化收益」高估一倍(16.4pp 对 8.3pp)——本期初稿正文曾把 32.1% 误配给 Astra,已按官方原文(「about 16 percentage points higher than GPT-5.6 Cyber's 32.1%」)更正;③ METR 报告原文写「less than a factor of 2」,正确表述应为「around 2」,三个独立估计全部触及或跨越 2 倍线;④ Kimi K3.1 Pro 是「开放权重」但许可含 2000 万美元 MaaS 条款,不等于可自由商用;⑤ 948 个 LPE 里有 20 个(10%)实际用了另一个 0-day,官方自认为乐观估计;⑥ 2× 加速 = 81 倍有效规模化,不是「快一倍」这么轻的意思。本期 arXiv 收录的 9 篇均为 2026-11-04 UTC 07:59–18:57 提交,11-05 / 11-06 批次截至检索时尚未入库,已在各条标注 v1 时间戳。