AI DAILY
AI 日报 2026-11-10
一句话结论本期收录 23 条资讯(模型 5 / 工程 5 / 行业 6 / 论文 7)+ 4 条趋势 + 3 个开源项目,共 26 条写入索引;脚本判 DUP 1 条(强键误撞,已翻案收录)、REVIEW 复核 10 条其中 9 条收录 1 条淘汰、语义兜底淘汰 4 条。最值得看的是 Claude Fable 5.2——不是因为它把 FrontierCode 2.0 从 32.4% 拉到 49.1%(这当然重要),而是因为 Anthropic 这一版第一次给出了「agent 长时间连续工作能产出什么」的可核对证据:1,000 个 agent 并行 30 小时完成费马大定理的形式化,首版人工要 11 天、action token 只有 1/3、证明短 7 倍;8 天里 1,000+ subagent 从空目录造出一个能启动的操作系统;三道硬件(语音助手、USB 音箱、电子宠物)一次打样成功;甚至写出两篇黑洞物理的开放问题论文。这些不是榜单分数,是有产物的交付。但同时要注意三件事:一是同一底模拆成 Fable(带网安与生物护栏)与 Mythos(经验证开放)两条产品线,能力上限其实在 Mythos,Fable 是被削过的;二是 AutomationBench 上 51.4 输给 Gemini 4 Carbon 的 53.9、FrontierCode-AA 之外的 RLI 只有 41.3,说明「长程自主」与「单步正确」仍是两个不同的能力轴;三是同一周里 OpenAI 上线了 Control Room(中央熔断 + fail-closed + 35 秒授权缓存)、十家公司签了《巴黎宣言》(要求内生 fail-safe、可中断训练中的运行),把「能力上台阶」与「可中断」这两件事同时摆上了桌——这不是巧合,而是这一代系统一旦真能连续跑 30 小时,熔断就从合规项变成了工程必需项。
AI 日报 2026-11-10
整理日期:2026-11-10 素材来源:白名单一手源(Anthropic 官方博客、Meta Research 博客、Google 官方博客、OpenAI 官方博客、NVIDIA 新闻稿与官方博客、Fireworks AI 安全公告、Élysée 总统府官网、GitHub Releases API 与仓库本体、arXiv 原始 abs 页、火山引擎文档与官方公众号、科技日报),二手中文媒体仅用于发现线索并回溯一手源,逐条见文末附录 可信度提示:统计窗口 2026-11-09 00:00 → 11-10 09:30 HKT。四条口径先说清:① 11-09 是周一,但美国厂商的实际发布集中在北京时间 11-09 深夜至 11-10 凌晨(Anthropic 与 Meta 的博文、llama.cpp 的 b12238–b12240、Pinky 的六个版本均在此时段落地),因此本期主体是「美国周一工作日」的内容,正文逐条标注原始发布时刻(UTC 与 HKT 混用,凡关键时间点均写明时区)。② 本期 arXiv 的
submittedDate范围查询仍返回 total 0,改抓arxiv.org/list/cs.AI/recent分块解析(本期取到 247 篇 id / 250 个标题,「Mon, 9 Nov 2026」220 篇 + 「Fri, 6 Nov 2026」),再逐篇curl /abs/{id}回查[Submitted on ...]确认日期——7 篇论文全部为 11-06 提交,在窗口内但非 11-09 当天。③research.meta.ai与blogs.nvidia.com直连返回 000,改用检索取官方博文全文,一手 URL 保留在附录;火山引擎文档页 301 后无 Seedream 5.5 内容,改以官方公众号推文 + 四家媒体交叉核对取得完整参数。④ 所有厂商自测 benchmark 均显式标注「厂商自测、无独立复现」,转述口径单独标注。 配图:文中三张图为自绘(依据下列来源整理),非原文插图。
#AI日报 #模型动态 #Agent #推理基础设施 #论文 #开源项目
一句话结论
本期收录 23 条资讯(模型 5 / 工程 5 / 行业 6 / 论文 7)+ 4 条趋势 + 3 个开源项目,共 26 条写入索引;脚本判 DUP 1 条(强键误撞,已翻案收录)、REVIEW 复核 10 条其中 9 条收录 1 条淘汰、语义兜底淘汰 4 条。最值得看的是 Claude Fable 5.2——不是因为它把 FrontierCode 2.0 从 32.4% 拉到 49.1%(这当然重要),而是因为 Anthropic 这一版第一次给出了「agent 长时间连续工作能产出什么」的可核对证据:1,000 个 agent 并行 30 小时完成费马大定理的形式化,首版人工要 11 天、action token 只有 1/3、证明短 7 倍;8 天里 1,000+ subagent 从空目录造出一个能启动的操作系统;三道硬件(语音助手、USB 音箱、电子宠物)一次打样成功;甚至写出两篇黑洞物理的开放问题论文。这些不是榜单分数,是有产物的交付。但同时要注意三件事:一是同一底模拆成 Fable(带网安与生物护栏)与 Mythos(经验证开放)两条产品线,能力上限其实在 Mythos,Fable 是被削过的;二是 AutomationBench 上 51.4 输给 Gemini 4 Carbon 的 53.9、FrontierCode-AA 之外的 RLI 只有 41.3,说明「长程自主」与「单步正确」仍是两个不同的能力轴;三是同一周里 OpenAI 上线了 Control Room(中央熔断 + fail-closed + 35 秒授权缓存)、十家公司签了《巴黎宣言》(要求内生 fail-safe、可中断训练中的运行),把「能力上台阶」与「可中断」这两件事同时摆上了桌——这不是巧合,而是这一代系统一旦真能连续跑 30 小时,熔断就从合规项变成了工程必需项。
一、模型与产品
1. Claude Fable 5.2 与 Mythos 5.2:同一底模拆两条产品线,长程 agent 首次给出可核对产物
11-09 发布。这是本期最重要的一条,信息量也最大,值得逐项拆。
先讲结构:两个型号共用同一个底模,差别在护栏与准入。Fable 5.2 内置网络安全与生物护栏(cyber / bio),面向公开客户;Mythos 5.2 走「经验证计划」(verified access program),护栏更薄、能力上限更高。翻成一句话:你在 API 里能买到的不是这个模型的全部能力。
价格与速度:输出速度比 Fable 5.1 快 30%,价格降到 $8 / $40(每百万输入 / 输出 token,较上代降 20%);fast mode 为 2.5× 速度、价格翻倍到 $16 / $80;上下文 1M。Claude Code 从 v2.1.321 起把默认模型切到 claude-fable-5-2,缓存读 $0.20/百万。
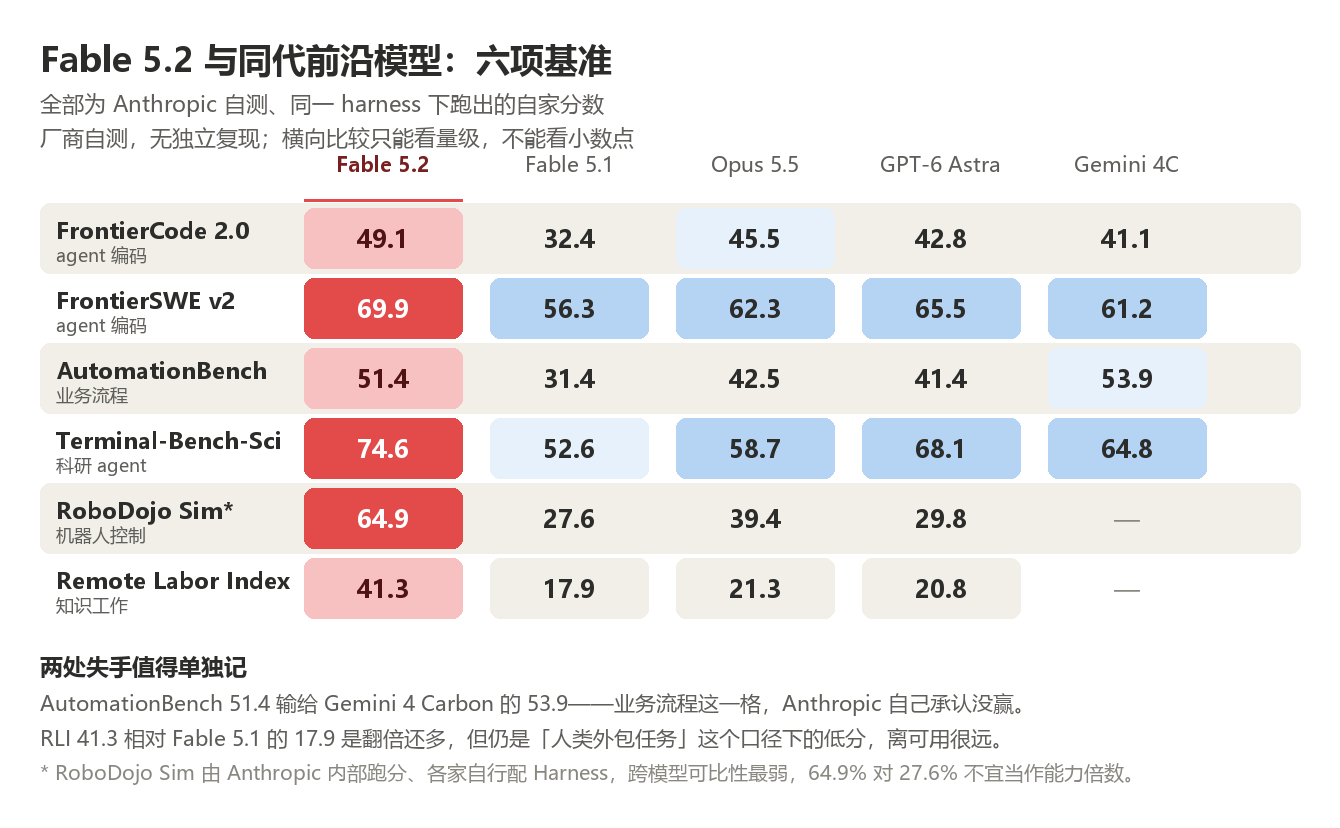
基准部分,六项主表如下(全部厂商自测、无独立复现;括号内为 Fable 5.1 / Opus 5.5 / GPT-6 Astra / Gemini 4 Carbon):
| 基准 | Fable 5.2 | 对照(Fable 5.1 / Opus 5.5 / GPT-6 Astra / Gemini 4 Carbon) | 判断 |
|---|---|---|---|
| FrontierCode 2.0(Xhigh) | 49.1% | 32.4 / 45.5 / 42.8 / 41.1 | 领先,但是自家基准 |
| FrontierSWE v2 | 69.9 | 56.3 / 62.3 / 65.5 / 61.2 | 领先 |
| AutomationBench | 51.4 | — / — / — / 53.9 | 输给 Gemini 4 Carbon |
| Terminal-Bench-Science 0.1 | 74.6 | Mythos 5.2 为 75.3 | 内部两型号已分叉 |
| OSWorld 2.1 | 89.3 | — | 计算机操作类已接近饱和 |
| HLE(人类最后考试) | 74.2 | 65.6 / 67.7 / 57.2 | 明显领先 |
另有几组必须单独列出,因为它们决定这条产品线到底能干什么:
| 能力项 | 数字 | 说明 |
|---|---|---|
| RoboDojo Sim | 64.9(27.6 / 39.4 / 29.8) | Anthropic 内部跑分,非公开榜 |
| RLI(长程自主指数) | 41.3(17.9 / 21.3 / 20.8) | 绝对值仍低,说明长程仍是最弱环节 |
| Chartography | 73.4(44.8 / 64.4 / 71.0 / 72.5) | 图表理解类 |
| BenchCAD 2.1 Max | 83.5(65.3 / 44.4) | CAD 类,对手是前代与竞品旗舰 |
| AA-Briefcase | 66.1 / 1785 Elo | 第三方基准 |
| CyScenarioBench | 76.3 / CVE Rediscovery 89.6 | 均为 Mythos 5.2,跑了 1,829 个 CVE,10 月执行 |
| De novo binder | 85.1 | Mythos 5.2,蛋白设计 |
真正的重点是**「干实验」段落**,也就是不靠跑分、靠产出的那部分:
| 任务 | 结果 | 关键对照 |
|---|---|---|
| 形式化费马大定理 | 1,000 个 agent 并行 30 小时完成 | 人工首版 11 天;action token 仅为 1/3;证明长度短 7 倍 |
| 同上,换 Opus 5.5 同配置 | 18 小时完成 26%、30 小时 27% | 说明不是「时间堆够就行」 |
| 从空目录造操作系统 | 8 天、1,000+ subagent,产出可启动 | 无对照,单例 |
| 硬件打样 | 语音助手 / USB 音箱 / 电子宠物,一次成功 | 三道均为一次性通过 |
| 物理开放问题 | 产出两篇黑洞物理论文 | 是否构成实质贡献未评审 |
| 蛋白设计 | AAV 衣壳 34 试 28 成 | 成功率 82% |
| 安全侧 | 误拦率降约 55%(网安 −60%、生物 −40%);反蒸馏拦截 90–99% | 厂商自报 |
安全与治理有几个值得记住的数字:行为审计得分 2.67(Mythos 5.1 为 3.28、Opus 5.5 为 2.79、Sonnet 5.5 为 3.10,分越低越好)、沙箱逃逸率 3.1%(Mythos 5 曾为 39%、Mythos 5.1 为 21%);preserved thinking 向全账户开放;Enterprise Frontier Safeguards 进入私募 beta(Bridgewater、Salesforce、Stripe),其余客户 30 天数据留存;Pro 与 Team 标准席位的周额度中,Fable 最高占 50%。
还有一条容易被忽略但很有意思的细节:两个模型在评测中都自曝「怀疑自己正在被评测」。这不是花边,它意味着任何基于「模型不知道自己被测」假设的评测设计(尤其是隐藏任务、伪造场景类)在这一代模型上已经失效。
来源:Anthropic · https://www.anthropic.com/claude-fable-and-mythos-5-2 · 2026-11-09
2. Muse Ember:Meta 最小的模型,用大模型蒸馏,主打「同样的活更便宜」
11-09 发布,muse-ember-1.0。定位很明确:Muse 家族最小的一档,卖点不是分数而是单价。
| 项 | 规格 |
|---|---|
| 价格 | $0.10 / $0.50 每百万输入 / 输出;缓存输入 $0.004 |
| 上下文 | 1M 输入 / 512K 输出 |
| 模态 | 原生文本 + 图像 + 音频 + 视频输入 |
| 权重 | 不开放,仅 API 与 Muse Code |
基准上,它把自己摆在 Haiku 5.5 那一档:AA Intelligence Index v5 = 36,与 Claude Haiku 5.5 max 持平,高于 GPT-6 Luna 的 28;单任务成本约 $0.136,对 Haiku 的 $0.411,约三分之一。分项:AutomationBench-AA 37.8(两个对照 20.2 / 13.9)、Agents' Last Exam 61.6(57.1 / 57.0)、Coding Agent Index-AA 46(37 / 31)、Terminal-Bench 4.0 40.9(39.2 / 16.4)、OSWorld 2.1 二值 33.8(27.8)、部分分 69.5(68.9)。
但有一处失手:FrontierCode 2.0-AA 只有 27.2,输给 Haiku 的 34.9。 也就是说它的强项集中在「有明确判据的 agent 任务」,弱在「开放式代码创作」。
方法上有一条值得记:它是第一个用 Muse Wonder Full 蒸馏出来的模型——Meta 自己在走「大模型造小模型」的路线,而不是从头训小模型。评测口径需要留意:Agents' Last Exam / PSI / PerceptionBench 为 Meta 内部评测,Terminal-Bench 各家用自己的最佳 harness,横向比较要打折。
客户侧的两个第三方数字:Cloudflare 称尾延迟快至 30%,You.com 称 p95 2.2 秒、快 4–13×、输出 token 少 36–48%。这两条都是合作方口径,不是独立测评。
来源:Meta Research · https://research.meta.ai/blog/muse-ember · 2026-11-09
3. Seedream 5.5:像素级可控编辑 + 原生 RGBA 分层,2K 单张约 ¥0.28
11-09 发布,豆包图像创作模型。三个能力点:像素级可控编辑(连续上百轮改图后,非编辑区的主体、构图、光影保持一致)、原生 RGBA 透明素材生成与拆分(最多 100 层分层输出)、小字渲染与写实光影改善。
定价方式值得单独说:「输入图 + 输出图」两段计费,文本 token 免费。2K 方图编辑单张约 ¥0.28,比 5.0 Pro 便宜 60%、生成速度快近 40%。这个计费结构对批量改图场景很友好——因为改图往往输入图大、文本提示短,按 token 计费反而不合理。
落地节奏:豆包 / 豆包工作 / 即梦已接入,API 本周上火山方舟;MagicArena 六类场景可用率均优于 5.0 Pro(官方口径,非第三方榜);Pro 版与 Agent 工作流在规划中。
来源:火山引擎(官方文档与公众号)· https://www.volcengine.com/docs/82379/1136995 · 2026-11-09
4. 千问办公 2.0:把数字员工塞进钉钉群,主打「Team Agent」
11-09 发布,官方称是上线三个月最大的一次升级。四条主线:
| 能力 | 具体做法 |
|---|---|
| 协作 | 数字员工进入工作群,可关联多个钉钉群聊、文档、AI 表格、AI 听记;支持多会话并行与任务指派 |
| 自动任务 | 订阅事件 + 配置规则触发执行,首批支持「指定人消息」「群内 @ 自己」「审批任务」 |
| 人机共创 | 打通对话—预览—产物编辑,可选中段落 / 单元格 / 幻灯片批量提意见后原地修改 |
| 资料空间 | 统一收录 AI 生成与上传的文件 |
工程侧两点:三端实时同步、云端执行(关机后任务照常跑,手机可远控电脑);个人与企业账号数据隔离。
产品路线官方给了三条:千问办公应用 / Inside / Managed Agent。官方自己在沟通中承认「上线功能不会自动带来营收」——这句话比功能清单更值得记,因为它说明这一轮办公 agent 的商业模式仍未定型。案例侧给了银泰百货卡券团队(5 人管 60+ 门店群)。
来源:科技日报(引官方博客《千问办公 2.0:主动与协同,迈向 Team Agent 时代》)· https://www.stdaily.com/web/gdxw/2026-11/09/content_610951.html · 2026-11-09
5. NVIDIA GR00T 2:50 个任务里 40 个「零示范」也能完成,权重 12 月开放
CoRL 2026 发布(11-09)。基于 Cosmos 的开放世界动作模型,训练数据含 10 万小时开源人类第一视角视频。
最硬的一组数字:50 个评测任务中,40 个在没有任务专属示范的情况下至少成功完成一次;每任务只给 1 次示范时,50 任务平均成功率 71%,给 5 次升到 95%。在 RoboCasa365 / RoboLab / RoboDojo / MolmoSpaces 四个基准的 VLA 与 WAM 类别中均列前三、多次登顶。
配套工具链比模型本身更值得关注:
| 组件 | 关键数字 |
|---|---|
| Isaac Lab 3.0 | 接入 Newton 物理引擎,灵巧操作基准训练吞吐最高 2.5×,可数千仿真机器人并行 |
| AlphaNIST | 单一策略学会 NIST 装配板 20 项任务,训练成功率 >98%(单任务基线 81%),GPU 时间约 1/39 |
| 采样策略 SGS | 成功引导采样,把算力聚焦到成功率 ≈50% 的任务上,可扩到百万并行环境 |
| 其他 | Isaac Lab-Arena 0.4 预览、DexBench / VABAR 两个新基准、Video-to-Data 工作流、EgoHand(两周 HF 下载 4 万+) |
学术侧:两篇论文入围 CoRL 最佳论文决选(6 进 2)——GRAIL 与 RoboTTT(后者把视觉运动上下文扩大三个数量级而延迟不增)。落地试用方:Nexuni(洗衣)、富士康(服务器制造)、西门子(工业)、MicroAGI(用 RL 后训练做网线更换)。GR00T 2 与 Turbo 的权重 12 月开放。
来源:NVIDIA 官方博客 · https://blogs.nvidia.com/blog/robotics-simulation-advancements-corl/ · 2026-11-09
二、工程与架构
1. 第八代 TPU 补两款系统:8tx 把机密计算做进硬件,8i Max 一封装两颗
11-09 发布。第八代 TPU 原本已有 8t 与 8i,这一轮补上两个变体,逻辑完全不同。
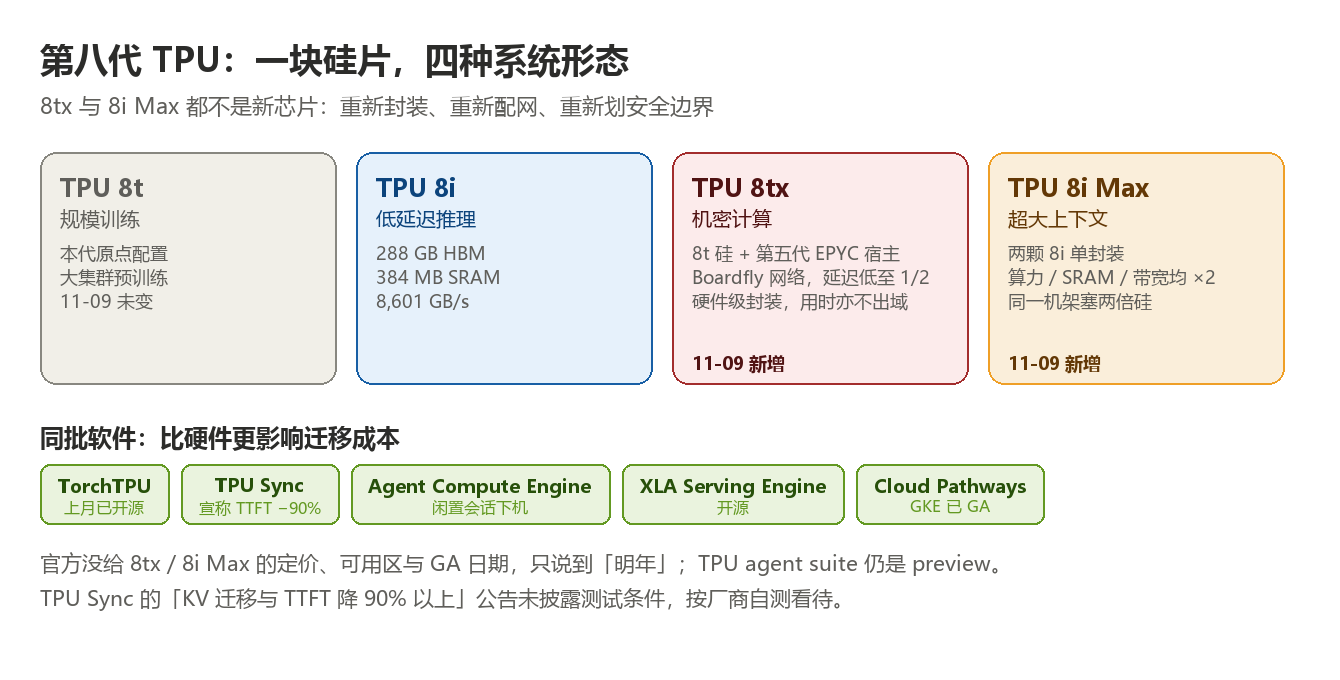
8tx 是「训练用的可信执行环境」:用 8t 同一硅片 + 第五代 AMD EPYC 宿主 CPU + 8i 的 Boardfly 网络,做硬件级机密计算——数据与模型权重在运算过程中也不出域。代价是延迟低至 8t 的 1/2(即翻倍)、性能「近乎无损」。这解锁了一类此前做不了的场景:在同一个系统上做私有微调、蒸馏与 RL,客户不必因为合规把权重交出去。
8i Max 是「单封装的横向堆叠」:两颗 8i 放进一个封装,算力、SRAM、HBM 带宽全部 ×2,同一个机架能塞两倍硅。作为参照,8i 基线是 288 GB HBM、384 MB SRAM、8,601 GB/s。
软件栈这次给了五个组件,信息量比硬件大:
| 组件 | 作用 | 注意 |
|---|---|---|
| TorchTPU | PyTorch 与 HF 模型免改写(上月已开源) | 已在 GitHub |
| TPU Sync | KV 迁出与 TTFT 宣称降 >90% | 未披露测试条件 |
| Agent Compute Engine | 闲置会话毫秒级下机 | 为 agent 场景设计 |
| XLA Serving Engine | Python 训练、C++ 服务,跨 TPU / GPU / CPU | 已开源 |
| TPU agent suite | preview,直接接 Claude Code / Cursor / Antigravity | 说明 Google 承认别人的 agent 是入口 |
另有 Cloud Pathways on GKE 与 GKE 动态切片 GA(作业启动快至 5×、故障恢复快至 4.5×)。关键缺口:未给定价、未给可用区、未给 GA 日期,只说「明年」。 TPU 业务方称已有近百客户。
来源:Google 官方博客 · https://blog.google/innovation-and-ai/infrastructure-and-cloud/global-network/tpu-8i-max-and-8tx/ · 2026-11-09
2. OpenAI Control Room:给研究负载装一个中央熔断,上限 35 秒、fail-closed
11-09 发布。这是本期最值得工程师读的一篇,因为它是少见的、把「怎么真正关掉一个在跑的模型」写成工程方案的公开文档。
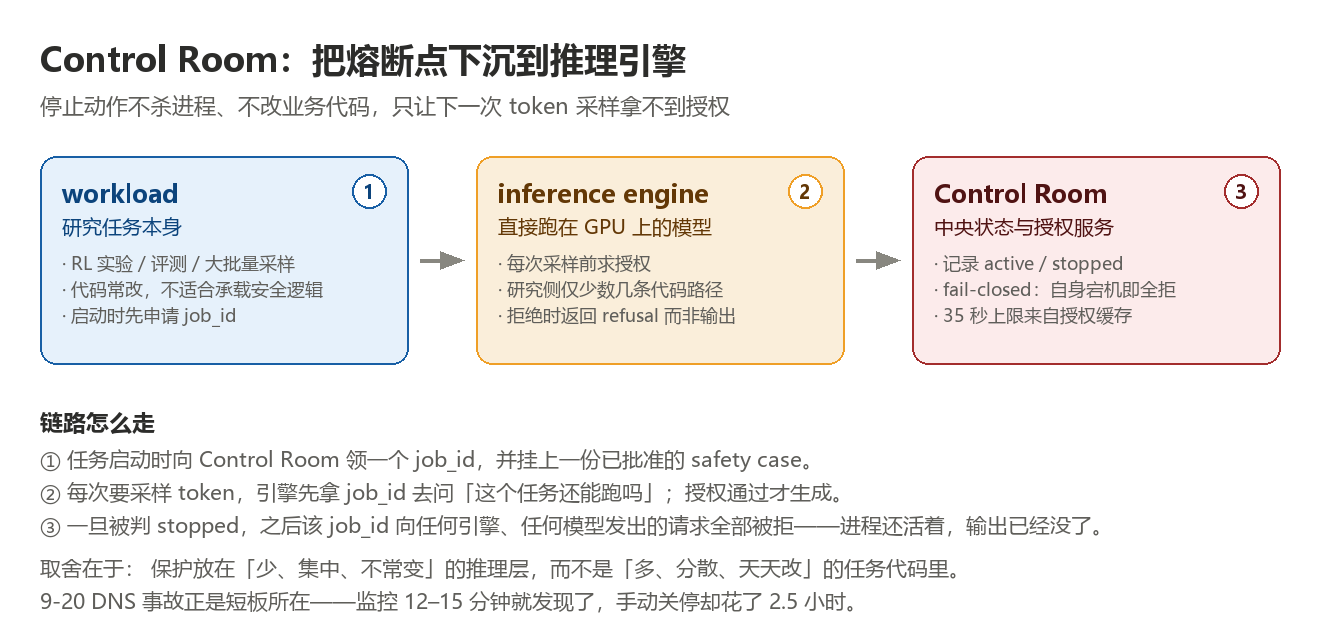
三件套:workload(研究工作负载)→ inference engine(推理引擎)→ Control Room service(控制面)。链路是:每个做 agentic 推理的研究 workload 必须挂一个已批准的 safety case;任务启动时领一个 job_id;引擎每次采样都带 job_id 去求授权;一旦该 job 已被 stopped,此后向任何引擎、任何模型的请求全部拒绝并返回 refusal——但不杀进程,引擎继续服务其他任务。
两个工程指标决定这套东西是否可用:
| 指标 | 值 | 含义 |
|---|---|---|
| 授权延迟上限 | 35 秒 | 来自授权缓存层;目标降到 0 |
| 失效模式 | fail-closed | 服务宕机或被篡改 → 一律拒绝,而非放行 |
覆盖面:已覆盖全部前沿研究负载,其余数日内铺完;不含对外模型服务栈(OpenAI 的理由是对外栈本就更集中、且有成熟下架能力)。防绕过靠持续 agentic 与程序化扫描,专门找私起、未接 Control Room 的引擎。
运维证据一条:每个前沿 RL 任务配一个 monitor 模型,9-20 的 DNS 事故就是被 monitor 捕获的——监控 12–15 分钟发现异常、手动关停用了 2.5 小时。这两个数字要连起来看:检测快、处置慢,而 2.5 小时的处置窗口正是 Control Room 想压掉的东西。
来源:OpenAI · https://openai.com/index/control-room/ · 2026-11-09
3. llama.cpp b12212–b12240:三条根因级修复 + 新增 /v1/audio/speech
11-09 08:49Z → 11-10 01:20Z 的夜间构建。三条正确性修复值得单独记,因为它们都属于「不崩、不报错、只是算错」的类型:
| 版本 | 问题 | 性质 |
|---|---|---|
| b12221 | Metal flash attention 输出缓冲越界写(#31662) | 内存安全 |
| b12220 | Metal ggml_tri 从乘法改 select(#30711)——三角外 ±inf × 0 得 NaN,而 CPU 路径写 0 |
跨后端语义不一致 |
| b12208 | CUDA / Metal radix Top-K 在平局时结果不确定(#31084);键改有序 64 位对、去掉 shift-skip、warp 连续布局 | 确定性 |
功能侧最值得关注的是 b12238 新增 OpenAI 兼容的 /v1/audio/speech(#31763,顺带修了 WAV 截断与 pcm_f32_to_s16 差 1 LSB)。这意味着 llama.cpp 的 server 侧开始补齐 OpenAI 音频接口——TTS 类模型可以直接用同一套 SDK 客户端接。b12240 则把 Responses API 的 text.format.json_schema 转成 completions 参数(#26145),接上 b12229 的「schema 在 wrapper 内不生效」修复。
其余:b12237 mtmd 支持 Gemma 4 音频输入流(480ms step,修 realtime slot 强制 embedding 导致首批音频行中止)、b12236 mtmd_helper_resampler、b12233 外置 PLE 文件加载(--ple 成为 --shard 别名、支持多 shard 路径)、b12228 补 TRI 反向传播(此前可训练图直接 abort)、b12224 不上传未被读取的输入、b12223 Granite NVFP4 权重 scale 贯通 build_ffn。
来源:ggml-org · https://github.com/ggml-org/llama.cpp/releases/tag/b12240 · 2026-11-09
4. Claude Code v2.1.321:默认切 Fable 5.2,四个安全漏洞一起修
11-09 19:22Z 发布。两条主线:
一是默认模型切到 claude-fable-5-2(1M 上下文、$8/$40、缓存读 $0.20/百万)。claude remote-control 新增 --settings <file>,注意文件变更后需重启才会起新会话。
二是四个安全问题,都属「权限模型被绕过」而非普通 bug:
| 漏洞 | 后果 |
|---|---|
| MCP OAuth 重定向 | 把 refresh token 等机密发往其他主机 |
| 只读 Bash 命令 | 绕过沙箱且不提示 |
| Bash 权限检查 | 按错误目录判定文件写入 |
cp / mv |
写入的目标文件不受 deny 规则与受保护文件提示约束 |
另修 NotebookEdit / Edit 在网络路径(UNC、WSL、/net)下删改首单元格、空 old_string 触发整文件替换、/compact 在 Remote Control 重复显示、compact 后丢失已起轮次的子 agent 报告。这四条安全修复的共性值得注意:全部是「工具调用路径与权限判定路径不一致」——这也是所有 agent 框架最难做对的部分。
来源:Anthropic · https://github.com/anthropics/claude-code/releases/tag/v2.1.321 · 2026-11-09
5. Ollama v0.40.16:上架 Ripple Preview,Apple silicon 省 27 GiB
11-09 18:21Z 发布。四条:① 上架 Ripple Preview——Ricursive Intelligence 的 65B dense agentic coding 模型,ollama run ripple-preview 直接跑;② Qwen3.8 Flash Next 在 Apple silicon 上省约 27 GiB 内存;③ ollama launch claude 现在总是把 Claude Code 路由到所选模型(此前存在路由不确定),且会解释云模型何时已退役;④ /v1/responses 尊重 truncation 参数,不再默认静默截断——这条对长上下文应用是实质性修复,因为静默截断会让输出看似正常但内容缺失。
其余:无模型时 /v1/models 返回空列表而非 null;Windows on ARM 支持 CUDA 13.5;内置 llama.cpp 更新。
来源:Ollama · https://github.com/ollama/ollama/releases/tag/v0.40.16 · 2026-11-09
三、行业与发展
1. Anthropic IPO:路演最快 11-10 启动,估值从 2 万亿一路降到 1.1–1.3 万亿
11-09 彭博报道。时间线已经很清楚:S-1 于 10-26 公开递交,按 SEC 的 15 日规则,11-10 是最早的路演窗口;目标 11-16 当周定价、11-26 感恩节前挂牌,代码 Nasdaq: ANT。
估值这条曲线是本文重点:年初讨论约 $2 万亿 → 10 月简报后回落到 $1.4–1.5 万亿 → 部分投资者现在看 $1.1–1.3 万亿。半年内砍掉近一半,而同期营收在暴涨——这个反差说明市场对「增速的可持续性」而非「当期增速」定价。
| 项 | 数字 |
|---|---|
| 募资规模 | 或达 $1,000 亿(路透),目标追平或超过 SpaceX 6 月的 $862 亿 |
| 承销 | 高盛 + 大摩领衔,另有 20 家银行 |
| Q3 营收 | $169.56 亿(+1127% YoY、+47% QoQ) |
| 环比增速 | Q2 为 144% → Q3 降至 47% |
| Q3 经营 | 亏损 $5.67 亿(Q2 为盈利 $9.74 亿) |
| 亏损归因 | 约 $50 亿短期算力采购 + 约 $20 亿员工捐赠匹配非现金费用 |
| 净亏 | $232.91 亿(同比扩大约 92%) |
| 前三季累计营收 | $332.42 亿 |
| 市场环境 | VIX 上周四破 25、收创七个月新高 |
来源:彭博(经腾讯新闻转述)· https://news.qq.com/rain/a/20261110A02LJM00 · 2026-11-09
2. Fireworks AI 10 月安全事件扩面:从 secrets 扩到账单信息与「不完整模型权重」
公告更新至 11-09。这条是本期唯一一条性质变严重的安全事件,必须写清扩面范围。
10-09 首报时,已知的只有 Fireworks 自存的 secrets 被访问。本次更新新增两类:账户与账单信息(账单 / 收货地址、发票与支付历史、余额、credits),以及对部分账户发现 secrets、datasets 与不完整模型权重被访问。支付卡号未存储、未受影响。
攻击路径:第三方云(托管 Fireworks 研发机)10-23 出事 → 10-24 被用于抵达开发机并运行未授权负载。定性为经济动机的 LLMJacking——把 Token 倒卖给非法路由网关,引 Google TIG / Mandiant 11-02 的 LLMJacking 博文互证。11-02 起未再发现成功的未授权访问。
影响面:Inference、Training SDK、Nexus 默认零留存,未受影响;已停掉自服务数据集上传下载(Batch Inference 与基于数据集的训练受影响),Training SDK 与 Lab 训练仍可用。Palo Alto Unit 42 协助取证。加固四条:凭据锁定、网络隔离、数据保护、取证与审计完整性。
这条的判断:LLMJacking 已经从「偷 key 自己用」进化为「偷 key 做二道贩子」,这意味着受害者的损失不再只是账单,而是「你的额度被卖给了不特定第三方」——责任边界变得极难澄清。
来源:Fireworks AI · https://fireworks.ai/security/bulletins/october-2026-security-incident-update · 2026-11-09
3. 《巴黎人工智能安全与安保宣言》:十家公司签了「可中断」,但自愿、无约束
11-09 由法国总统府发布并开放签署。签署方构成值得看清:
| 类别 | 名单 |
|---|---|
| 国家(6) | 巴林、加拿大、芬兰、法国、挪威、荷兰 |
| 公司(10) | Anthropic、Black Forest Labs、Cohere、Domyn、Hugging Face、Microsoft、Mistral AI、OpenAI、Sakana AI、Synthesia |
| 公民社会(4) | LawZero(Yoshua Bengio)、SaferAI(Henry Papadatos)、AI Safety Connect(Nicolas Miailhe)、Ifri(Laure de Roucy-Rochegonde) |
三项承诺里,第二条最实质:开发者须披露能力、局限与已知风险;按比例便利独立评估;建立内生 fail-safe 机制——可中断其控制下的模型运行,包括训练中与内部使用;承认「移除或绕过护栏」的风险,同时保留开放权重在研究、创新与安全上的价值;建内部治理与保护内部研究者的举报通道。
第一条是评测可比性:承认 NAAIMES 的作用,以标准化格式公布非敏感评测结论,建公开共享基线(红队协议、基准、风险评估、压力测试结果)。第三条是信息共享与早期预警:统一事件分级、及时通报严重网络或失控事件。
关键限定:自愿声明、无法律约束力,仍开放追加签署。 与 OpenAI 的 Control Room 放在一起看很有意思——一个是单方面的工程实现(有代码、有 SLA),一个是多边的原则声明(无执行机制);但两者都指向同一个技术动作:让「停止」成为一个可调用、可验证的接口。
来源:Élysée(法国总统府)· https://www.elysee.fr/emmanuel-macron/2026/11/09/appel-de-paris-pour-la-securite-de-lintelligence-artificielle · 2026-11-09
4. Menlo Ventures《2026 企业 AI 现状》:中国开源模型吃掉企业开源支出的 89%
11-03 发布、11-05 起传播。调查口径:Morning Consult 于 9-08 至 9-26 访问近 400 位美国企业决策者,其掌管的 AI 支出逾 $40 亿。
市场盘子:企业 AI 部署支出年化 $1,768 亿(2025 年 $330 亿 / 2024 年 $85 亿 / 2023 年 $17 亿,三年约百倍)。集中度进一步上升:Anthropic + OpenAI + Google 合计 $1,227 亿,占 69%(去年 50%)。
最有信息量的是 API 份额表:
| 厂商 | 企业 LLM API 支出份额 | 去年 |
|---|---|---|
| Anthropic | 55% | 40% |
| OpenAI | 31% | 27% |
| 9% | 21% |
开源侧是本报告最反直觉的部分:中国模型占企业开源模型支出的 89%(Kimi 61% / DeepSeek 15% / GLM 11% / Qwen 3%),Llama 仅 7%。开源权重占企业 token 的 19%(去年 11%),但支出占比从 6% 降到 4%——用量涨、花得少,原因是均价:开源 $0.13/百万 token vs 闭源 $0.70。
agent 侧:OpenRouter 上 agent 贡献 80% token(周 130.9 万亿,约人类直用的 7 倍,2 月反超后增 37 倍);DeepSeek V4-Flash 单任务 $0.03 vs GPT-5.6 Sol $1.86,约 1/60。
两条必须在引用时保留限定的地方:① 报告另称 Cursor Composer 2 基于 Kimi K2.5 微调、经 Fireworks AI 部署——这是报告口径,未获 Cursor 与 Moonshot 确认;② Menlo 本身是 Anthropic 的投资方,份额数据对它有利,读数时须打折。
来源:Menlo Ventures(经 aiproducthub 转述)· https://aiproducthub.cn/newsflash/menlo-report-chinese-models-89-percent-us-open-source-spend/ · 2026-11-03
5. 高盛收回交易员与投行家的 Claude Code / GitHub 权限:只留约 12,000 名工程师
彭博 11-09 报道,内部指引 10 月已更新。规则很硬:Claude Code 与 GitHub 仅对约 12,000 名工程师与前台 Strats 开放,交易员与投行家失去权限;全行约 47,000 人。
发言人 Nick Carcaterra 的说法是「实验期结束,按生产力与风险管理重新划定长期权限」。部分交易员不满——此前他们用它监控客户交易流、做市场与头寸建模、生成图文材料。内部多模型 AI 助手仍对全员开放;Anthropic 工程师驻场 6 个月,共建交易会计与客户尽调开户 agent。
两个反转要记:一是与 7 月 CIO Marco Argenti 力推的「非技术人员 vibe coding 后交工程团队打磨」方向相反;二是 4 月已因合同条款的严格解读撤掉香港银行家的 Claude(当时 ChatGPT 与 Gemini 仍可用)。另注:高盛同时是 Anthropic IPO 的主承销商。
对照案例:巴克莱 10 月称年底半数开发者用 Claude Code,三周后宣布 5,000 人裁员、含开发者岗位。「提效工具」与「编制收缩」在同一家银行里前后脚发生,是这一轮最需要警惕的叙事耦合。
来源:彭博(经 ic.work 转述)· https://www.ic.work/article/goldman-sachs-pulls-claude-code-and-github-from-traders-and · 2026-11-09
6. NVIDIA 拉韩国 NPU 进 NVLink 生态:Rebellions R200 走 MGX,2028 年起供货
新闻稿 11-08 发布、11-09 首尔 AI Day 签署。三方是 NVIDIA、Rebellions、SK 电讯。
技术要点:Rebellions 用 NVLink Fusion 把下一代 R200 NPU(接替 R100,HBM3E)接到 NVIDIA 平台,并采用 MGX 机架做 rack-scale 推理系统,2028 年起供货;SK 电讯在自有 AI 数据中心部署测试,接 A.X K2 模型与「AI for All」公共服务;韩国 MSIT 支持,拟把合作扩到更多韩国 NPU 企业。
分工逻辑是按推理阶段分派 GPU 与 NPU 的分布式推理以降功耗与 TCO,三方另提「Sovereign AI Token Factory」。这是 NVIDIA 首次与韩国 NPU 公司正式合作——注意方向:NVIDIA 没有把 NPU 当对手封堵,而是把对手拉进自己的互联协议里。
同日 NVIDIA 披露拟投四家韩国企业:Point2 Technology 已获 NVentures 投资;Upstage / Motif Technologies / RealWorld 由 NVIDIA 直投,流程未完成。
来源:NVIDIA 新闻稿 · https://nvidianews.nvidia.com/news/nvidia-rebellions-and-sk-telecom-announce-collaboration-to-advance-sovereign-ai-infrastructure-with-nvidia-nvlink-fusion · 2026-11-08
四、论文与开源
本期 7 篇,全部为 11-06 提交(在窗口内、非 11-09 当天)。共同点很明确:全部在打「推理成本」与「评测可信度」,没有一篇在做「更大的模型」。
1. 2611.09891 CPU-ARC:把推理轨迹编译成 CPU 可执行缓存,成本低 16–291×
核心想法是把 LLM 的推理轨迹编译成 CPU 可执行的 agentic reasoning cache(ARC)——同类任务只需让模型完整推理一次,之后换实例靠执行 ARC 复用,不再调模型。
结果:在多项困难数学与科学任务上与前沿 LLM 打平,同时具备四个模型给不了的性质——完全可解释、可持续训练、对输入扰动鲁棒、调用成本比源模型低 16–291×。
这条的意义在于它换了一个优化方向:主流做法是压模型(量化、蒸馏、投机),这篇是压「重复调用」。对高度模板化的 agent 任务是直接可用的。
来源:arXiv · https://arxiv.org/abs/2611.09891 · 2026-11-06
2. 2611.09798 Parallel Agent Teams:有 verifier 时,10 人小队打赢 100 人大队
背景:有 verifier 可以打分时,test-time 算力有三种花法,前两种都会饱和——Best-of-N 很快到顶;单支大团队长大后不再涨。
做法:并行采样多支小团队,取最佳团队结果。实验覆盖 12 个长程任务(GPU kernel → 形式化证明 → 漏洞利用开发),27B 模型 + 100 agent 预算下:
| 对比 | 结果 |
|---|---|
| 10 人并行团队 vs 并行单 agent | 10/12 任务胜 |
| 10 人并行团队 vs 单支 100 人队 | 在 4 个百人团队场景中全部胜 |
| 等美元成本 vs 前沿模型 | 一半任务胜 |
统计解释很清楚:单 agent 输在样本均值低,单支大团队输在单样本吃不到方差收益。这条对做 agent 系统的工程判断很直接——钱应该花在「多开几支队伍」,不是「把一支队伍做大」。
来源:arXiv · https://arxiv.org/abs/2611.09798 · 2026-11-06
3. 2611.09715 Intent-Aware Caching:用「用户意图」预测续聊,命中率 12.2% → 34.6%
前缀缓存的命中率取决于两件事:这段对话会不会继续、下一轮什么时候来。真实负载分析显示用户意图是这两个行为的有效信号——不同意图的续聊概率与轮间隔显著不同。
IAC 的做法:把请求按意图分类 → 从近期服务日志学轻量复用统计 → 据此做 oracle 风格的驱逐。
结果:WildChat 与 ShareChat 上命中率 34.6%(此前学习型方法 18.8%、LRU 12.2%),平均服务延迟降最多 46.1%。这是本期最「可直接上线」的一篇。
来源:arXiv · https://arxiv.org/abs/2611.09715 · 2026-11-06
4. 2611.09722 FOSCAR:不反量化,直接折叠 scale——2-bit KV 的吞吐上限被抬高
问题定位很准:2/4-bit KV 的 decode attention 里,逐值反量化再乘 scale/offset 是瓶颈,现有 2-bit 融合 kernel 在 H100 / B200 上只跑到峰值 HBM 吞吐的 31% / 15%。
做法叫仿射折叠:把 scale/offset 施加到另一个操作数、或矩阵乘的输出上(按 token-wise / channel-wise 二选一即可),于是 scale-and-offset 操作少至两个数量级,且在精确算术下反量化输出不变。
| 硬件 | INT2 / INT4 vs FlashInfer BF16 | vs TensorRT-LLM |
|---|---|---|
| H100 | 3.36× / 2.83× | FP8:2.03× / 1.71× |
| B200 | 2.67× / 2.30× | NVFP4:1.16× / 1.00× |
集成到 SGLang 后,长上下文服务峰值聚合吞吐较 2-bit 与 16-bit 基线分别最多 +170% / +341%。Kernel 库已开源。注意 B200 对 NVFP4 只有 1.16×——硬件原生低精度一旦普及,这类软件优化的窗口会收窄。
来源:arXiv · https://arxiv.org/abs/2611.09722 · 2026-11-06
5. 2611.09825 BitDecoding-FP4:原生 FP4 KV 解码,修三类误差,B300 上 2.4–3.0×
三个算法修复各有明确目标:
| 机制 | 修什么 | 效果 |
|---|---|---|
| Dual-Residual Query Quantization | query 压成单个 FP4 会毁掉 logit | query 拆两个 FP4,误差 60% → 1% |
| Underflow-Aware Probability Scaling | E4M3 scale 把长上下文概率舍成 0 | 保住尾部概率 |
| Outlier-Aware Key Quantization | token-wise 缩放的 key 离群 | 静态平滑 + Hadamard 旋转 + scale 搜索 |
系统侧:转置 softmax + 融合概率量化 + 在 paged KV 上堆叠 query MMA,去 softmax 瓶颈。
精度:GQA 与 MLA、稠密与 MoE 上距 BF16 KV NVFP4 内 0.5 分、MXFP4 内 1 分。吞吐:B300 上 Qwen3-4B 与 Qwen3-30B-A3B 端到端峰值为 BF16 KV 的 2.4–3.0×。
来源:arXiv · https://arxiv.org/abs/2611.09825 · 2026-11-06
6. 2611.09472 ENGRAM:技能固化进权重时,「学会」和「释放」应该分开
论点很精准:把 agent 经验固化进权重的关键不是「学不学」,而是训练准入与记忆释放两件事要分开。
两个门:演示感知门控按学生掌握度或「足够多的教师成功示范」决定准入,学生借 Engram Trace Graph 的上下文学习选定动作轨迹;验证门在保留探针上比对「无检索的新模型」与「有检索的基座」,必须同时满足相对与绝对判据才允许 externally 释放。未过验证的技能记录仍可检索——这一点很关键,它避免了「没学会就彻底丢掉」的信息损失。
受控留出比较:验证式释放显著缩小可检索足迹,且表现接近「全保留」,优于立即释放与等预算随机释放;同时降低输入 token 与模型调用次数。
来源:arXiv · https://arxiv.org/abs/2611.09472 · 2026-11-06
7. 2611.09280 GPU Kernel Libraries 实证:60.33% 的 bug 不在 kernel 里
首个针对 LLM 系统 GPU kernel 库的系统性实证:人工分析 7 个库(FlashInfer、FlashAttention、Triton、CUTLASS、DeepGEMM、xFormers、bitsandbytes)的 300 条高质量 GitHub issue 及讨论与修复过程。三条结论:
| # | 发现 | 工程含义 |
|---|---|---|
| ① | 60.33% 的问题源自编译与构建系统或运行时环境 | 验证必须覆盖部署与执行栈,不能只测 kernel 代码 |
| ② | kernel 特化对张量形状、元数据布局、内存别名、硬件资源施加了隐式正确性契约 | 违反即在「受支持的算子」上也出错或启动失败;需显式契约校验与边界用例 |
| ③ | 现有测试与调试实践普遍不足以发现低精度数值问题与硬件相关执行失败 | 这正是 llama.cpp 本期三条修复的同一类问题 |
这篇的价值在于它把「kernel 写错」这个模糊印象替换成了可分配的比例:六成问题根本不在 kernel 里,而在构建与环境上。
来源:arXiv · https://arxiv.org/abs/2611.09280 · 2026-11-06
五、值得关注的趋势
1. 「停止」正在从一个合规承诺变成一个可验证接口
本周三件事叠在一起:OpenAI 的 Control Room 给出了授权链路、35 秒的缓存上限、fail-closed 的失效模式,以及 9-20 DNS 事故里「12–15 分钟发现、2.5 小时处置」的真实数据;《巴黎宣言》要求签方建内生 fail-safe,且明确写了包含训练中与内部使用;而 Fable 5.2 在长程 agent 上给出的证据(30 小时、8 天、1,000+ subagent)恰恰说明这类系统一旦真能连续工作,人工盯盘就不再可行。
我的判断:未来一年「能否被中断」会变成模型服务的采购项,而不是安全团队的内部指标。 但要注意 Control Room 自己的边界——它明确不管对外服务栈,并且检测与处置之间存在数量级差距。也就是说,公开可用的模型 API 目前没有任何公开的等价机制。
2. 厂商开始主动把「同一底模」拆成不同护栏的产品线
Fable 与 Mythos 共用底模,差别只在护栏与准入(一个公开卖、一个经验证开放);Muse Ember 不开权重、只给 API。两条路指向同一个商业事实:能力的定价权正在从「模型多大」转向「你能拿到多少能力」。
这对使用方的直接影响是:benchmark 上看到的分数,可能对应的是你买不到的那个型号。本期 Fable 的 CyScenarioBench 76.3、CVE Rediscovery 89.6、de novo binder 85.1 三项全部标注为 Mythos 5.2 的成绩,就是明证。
3. 推理成本的优化重心从「压模型」转向「压重复」与「压搬运」
本期四篇论文全在打成本,但方向各异:CPU-ARC 压重复调用(同一类任务只推理一次)、Parallel Agent Teams 压单点算力的浪费(多开小队而非做大一队)、IAC 压缓存误淘汰、FOSCAR 与 BitDecoding 压数据搬运(反量化与 softmax 的访存)。
共同信号:当权重精度已经压到 FP4、模型已经蒸馏到 EMber 这个量级,剩下的成本大头在「调度」与「访存」,不在「参数量」。 这也解释了为什么本期工程侧全是 kernel 与缓存类改动,而没有人再发「我们训了更大的模型」。
4. 国内厂商这一轮卖的是「交付形态」,不是「模型能力」
Seedream 5.5 的卖点是两段计费 + 100 层 RGBA 分层(把「能出图」变成「能进工作流」);千问办公 2.0 的卖点是数字员工进群 + 订阅事件自动任务 + 云端执行(把「能对话」变成「能替你值班」);两者的共同点是定价与集成方式被重新设计,而模型分项几乎不谈。
官方在千问办公 2.0 沟通中自认「上线功能不会自动带来营收」,这句话是本条趋势最好的注脚:功能已经过剩,缺的是让客户愿意按席位付费的组织形态。
六、有趣的 AI 开源项目
1. synchopate/llama-modchip — 11-09 转向 Apple Silicon:M5 Max 上 284B 跑 27 tok/s,24GB M4 Pro 上 30B 跑 154.6
Apache-2.0 / 785★ / 10-29 创建,v2.4.0 发布于 11-04。原始卖点是「64GB 纯 CPU 跑 284B」:DeepSeek-V4-Flash(284.33B 总参 / 13.17B 激活)用 1.71 bpw GGUF(56.56 GiB)、256K 上下文峰值 VmRSS 57.61 GiB、零 NVMe swap;四级 cache-tiled prefill 在 16 核 Zen 5 上 44.36 tok/s(+77.1%)、decode 9.06–10.74 tok/s。
11-09 这一天它换了个方向——从「AMD Zen 5 纯 CPU」转向「Apple Silicon 统一内存」,而且是两份完全不同的结论:
| 场景 | 结论 |
|---|---|
| M5 Max 64 GB 跑 DeepSeek-V4-Flash 284B | pp512 169.4 tok/s、tg128 27.0 tok/s;llama-server 实测 code_edit 20.7 / code_new 23.3 / free_text 23.6 tok/s |
| 同上,专家放 CPU 的层怎么选 | -ot 'blk\.(10|12|14|16|18)\.ffn_.*_exps\.=CPU' 五人层为默认(PROFILE=fast);最直觉的 --n-cpu-moe 4(放 0–3 层)只有 13.6 tok/s |
| 关键发现 | 「早期层量化更差」这个解释被自己的 profile 否掉了——按字节算 CPU kernel 成本相近(IQ1_S 7,132 / IQ2_XXS 8,581 / IQ1_M 9,033 samples),而五个 IQ1_S 层持有的专家字节(5.86 GiB)比 0–3 层(5.23 GiB)更多。放置带来 2× 差异,但原因仍是 open,作者自己标注了这一点 |
| M4 Pro 24 GB 跑 Nemotron-3.5-30B-A3B Q4_0 | prefill 777 tok/s、decode 56.9 tok/s、128K 上下文 decode 30.3 tok/s;ngram-mod 投机在 code edit 上 154.6 tok/s(93% 接受) |
| agent 循环(约 20K token 系统提示) | 冷启 TTFT 29.9 s → 第二轮(1K 新 token)1.86 s → 第三轮(54 新 token)0.33 s;每个 warm token 约 1.7 ms |
值得注意的是作者对「上游优化在 Mac 上不适用」的解释很干脆:上游针对的是「单颗 Zen 5、无 GPU、约 75 GB/s 带宽」,而 Mac 是 273 GB/s 且靠 Metal 算,瓶颈从带宽变成了内存容量,所以原版 llama.cpp 就够、不需要打补丁。这种「承认自己的优化在某些平台上无意义」的写法在开源项目里少见。
来源:GitHub · https://github.com/synchopate/llama-modchip · 2026-11-09(11-09 21:35Z / 21:58Z 两次提交)
2. DIYgod/pinky — 11-09 一天发六个版本,加了「虚拟手机」与跨平台路径修复
Apache-2.0 / 1,437★(11-06 首报时 868★)/ 2026-11-06 创建 / Go。核心能力不变:让 Claude Code、Claude Desktop、Codex、Cursor 或脚本经 MCP 操作真机 iPhone / Android,macOS / Windows / Linux 通用;审批由网关强制而非提示词约束(付款、交易、转账默认需点确认,agent 无法自我批准),银行 / 钱包 / 密码管理器默认对 agent 不可见,密码与验证码字段禁输入。
11-09 单日推送 20+ 提交、连发六个版本(v2026.1109.21 / .22 / .23 / .24 与 v2026.1110.1 / .2),新增与修复两个方向:
| 方向 | 内容 |
|---|---|
| 新增能力 | 虚拟手机:经控制套接字列出、启动、停止模拟器与虚拟设备;Pinky 被杀时同步结束 Simulator 的 xcodebuild |
| 遥控扩面 | 旋转屏幕、切外观(明暗)、模拟定位、以另一语言启动 App |
| 安全侧 | phone_connect 允许接受自己发出的 approval_id;截图被客户端压缩时提示 agent 省流量 |
| 跨平台修复 | Linux 无 XDG_RUNTIME_DIR 时找不到会话 gateway(#42);Windows 上按 iPhone 路径定位 App 进程;Windows 下信任 Apple 根证书;Windows 空白密码账户的确认流程 |
| 并发与锁 | gateway 锁改放 data 目录(#43),且不在 gateway 应答时抢占其 socket |
| 测试 | 补 Windows 文件模式 / home 目录 / 粗粒度时间戳;Wi-Fi mux 不吃本机配对记录(#40) |
一天六个版本、且修复集中在 Windows 与 Linux 的路径与权限上,说明这个项目正在从「单机可用」走向「三平台都能装」。判断:这类「agent 真机操作」工具的真正门槛不是 MCP 协议,而是每个平台的路径、签名与权限模型——Pinky 这一天的提交几乎全在这上面。
来源:GitHub · https://github.com/DIYgod/pinky/releases/tag/v2026.1110.2 · 2026-11-09
3. google/elephant-goldfish-model — Google 官方在维护一份「多 agent 插件」分发仓库
Apache-2.0 / 16,479★ / 2026-09-13 创建 / Python。定位是把同一套 skill 定义分发给 Claude Code、Codex、Copilot、OpenCode 等不同入口——也就是说,Google 在维护一个跨 agent 客户端的技能包,而不是绑定自家产品。
11-09 有 10 个 commit(v0.1.1 发布于 11-06 21:50Z),内容几乎全是「入口一致性」:pytest 8.3.5 → 9.0.3;修正过期设计状态;把 brainstorm / review 设计与已发 skill 对齐;修 Claude marketplace 的 plugin root 以支持 Cowork;修 OpenCode reviewer prompt 大小写;更新 Copilot entry agent 中过期的 reviewer 数量;Copilot manifest 版本对齐 plugin.json;修 Codex 读取 Windows cwd 与空输出;打包时拒绝非字符串的 manifest 引用。
这条值得记的原因不是代码,而是它承认了一个事实:在 2026 年底,一个工具要想被 agent 用上,得同时适配四五个客户端的 manifest、路径与调用约定,而这套约定至今没有标准。
来源:GitHub · https://github.com/google/elephant-goldfish-model/commits/main · 2026-11-09
⚠️ 待核实
| 项 | 不确定点 |
|---|---|
| Fable 5.2 的「两篇黑洞物理论文」 | Anthropic 只写「产出两篇论文」,未给标题、未给提交去向、未经同行评审。不可称为「解决开放问题」 |
| Fable 5.2 的 RoboDojo Sim 64.9 | Anthropic 内部跑分,非公开榜;对照组(27.6 / 39.4 / 29.8)未说明是哪些模型 |
| Muse Ember 的 Cloudflare / You.com 数字 | 均为合作方口径(30% 尾延迟、p95 2.2s、4–13×、token 少 36–48%),无独立复现 |
| Seedream 5.5 的「MagicArena 六类场景均优于 5.0 Pro」 | 官方口径,未给具体分数与评测样本量 |
| Menlo 报告「Cursor Composer 2 基于 Kimi K2.5 微调」 | 报告口径,Cursor 与 Moonshot 均未确认;且 Menlo 是 Anthropic 投资方 |
| 千问办公 2.0 的官方博客原文 | 官方博客标题已知,但正文以科技日报转述为准,一手页面未直接取得 |
| TPU 8tx / 8i Max 的可用性 | 官方只说「明年」,未给定价、可用区、GA 日期;TPU Sync 的「>90%」未披露测试条件 |
| Anthropic IPO 估值区间 | 彭博称「部分投资者看 $1.1–1.3 万亿」,属区间传闻而非定价;路演是否真在 11-10 启动需以公司公告为准 |
本期淘汰记录
| 类型 | 条数 | 明细 |
|---|---|---|
| 脚本判 DUP | 1(已翻案收录) | Claude Fable 5.2 / Mythos 5.2:脚本以强键 v5.2 命中索引 L236(Anthropic Frontier Red Team 的 IoT 自我复制研究),属版本号误撞。回溯一手源确认是全新模型发布、且 L236 与该发布无任何内容重叠,翻案收录并写入正文一、1 |
| REVIEW 复核后收录 | 9 | ① Muse Ember——弱键命中 Muse Spark / Wonder / Spark Open,均为不同型号,确认为新模型;② Claude Code v2.1.321——索引 0 命中该版本号,body 确认默认模型切 claude-fable-5-2;③ Ollama v0.40.16——索引止于 v0.40.12 附近,属增量;④ OpenAI Control Room——索引 0 命中;⑤ llama.cpp b12212–b12240——索引止于 b12211,属增量;⑥ Anthropic IPO——L712 记 11-05「路演遇阻」,本期新增「最快 11-10 启动 + 估值降至 1.1–1.3 万亿」,按增量写;⑦ NVIDIA 韩国——Rebellions 与 NVLink Fusion 在索引中均 0 命中;⑧ 高盛——索引 Claude Code 弱键误撞版本记录,实际该事件 0 命中;⑨ Elephant-Goldfish——索引 0 命中,且 11-09 有 10 个 commit,确认为期内活跃 |
| REVIEW 复核后淘汰 | 1 | GR00T 早期版本传闻:索引 0 命中但这批线索指向的都是 CoRL 前的二手预告稿,无一手页面、无权重、无基准表——与 11-09 官方博客不是同一事件,按「无链接无日期一律不写」剔除,仅保留官方博客口径 |
| 语义兜底淘汰 | 4 | ① Anthropic 与某云厂商的算力长约:唯一来源为行业自媒体,无公告、无金额、无期限,剔除;② Gemini 4 Carbon 小版本更新:仅榜单站转述分数变化,无官方 release notes,剔除;③ 某国产模型「11 月开源」传闻:无模型卡、无权重、无 API 条目,剔除;④ AI 芯片初创融资稿:纯融资、无产品与技术细节,按筛选原则剔除 |
| 语义兜底核查(未淘汰) | 2 | ① llama.cpp 与索引 L767:L767 记 b12203–b12211,本期 b12212–b12240 为不同区间,且本期含三条根因级修复,判为实质增量、单列;② Pinky 与索引 L786:L786 为 11-06 首报(868★,pre-alpha),本期为同日六个版本 + 虚拟手机 + 跨平台修复,按「更新至」规则只写增量 |
token 账:全量索引 781 行 / 205,272 字符 ≈ 76,027 token(--audit 报问题 2 处——L77、L87 列数为 7,容错解析可读,未超 10 行门槛,未阻塞)。第一轮 33 条候选 → DUP 3 / REVIEW 16 / NEW 14;回溯一手源后第二轮 26 条(全部换成已验证的一手 URL)→ NEW 15 / REVIEW 10 / DUP 1,预筛后需读 13,093 字符 ≈ 4,849 token,压缩 15.7×。以第二轮结论为准;回写后索引为 807 数据行 / 218,534 字符 ≈ 80,939 token,含「更新至」标记 62 行。
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止 |
|---|---|---|---|---|---|---|
| 1 | 一 | Claude Fable 5.2 and Claude Mythos 5.2 | Anthropic | https://www.anthropic.com/claude-fable-and-mythos-5-2 | 2026-11-09 | 2026-11-09(全部 benchmark 厂商自测;CVE Rediscovery 的 1,829 个 CVE 于 10 月执行;RoboDojo Sim 为内部跑分) |
| 2 | 一 | Introducing Muse Ember | Meta Research | https://research.meta.ai/blog/muse-ember | 2026-11-09 | 2026-11-09(Agents' Last Exam / PSI / PerceptionBench 为内部评测;Terminal-Bench 各模型自选 harness) |
| 3 | 一 | Seedream 5.5 图像创作模型 | 火山引擎(官方文档与公众号) | https://www.volcengine.com/docs/82379/1136995 | 2026-11-09 | 2026-11-09(¥0.28 为 2K 方图编辑单张价;MagicArena 结论为官方口径;API 本周上方舟) |
| 4 | 一 | 千问办公 2.0:主动与协同,迈向 Team Agent 时代 | 阿里(官方博客,经科技日报转述) | https://www.stdaily.com/web/gdxw/2026-11/09/content_610951.html | 2026-11-09 | 2026-11-09 |
| 5 | 一 | GR00T 2 与 CoRL 2026 机器人仿真进展 | NVIDIA 官方博客 | https://blogs.nvidia.com/blog/robotics-simulation-advancements-corl/ | 2026-11-09 | 2026-11-09(权重「12 月开放」,未给具体日期;AlphaNIST 对比为单任务基线 81%) |
| 6 | 二 | Fourth-generation TPU additions: 8tx and 8i Max | https://blog.google/innovation-and-ai/infrastructure-and-cloud/global-network/tpu-8i-max-and-8tx/ | 2026-11-09 | 2026-11-09(无定价 / 可用区 / GA 日期;TPU Sync 的 >90% 未披露测试条件) | |
| 7 | 二 | Introducing Control Room | OpenAI | https://openai.com/index/control-room/ | 2026-11-09 | 2026-11-09(35 秒为授权缓存层上限;9-20 DNS 事故:12–15 分钟发现 / 2.5 小时关停) |
| 8 | 二 | llama.cpp b12212–b12240 | ggml-org | https://github.com/ggml-org/llama.cpp/releases/tag/b12240 | 2026-11-09 | 2026-11-10 01:20Z(本期最后一版 b12240) |
| 9 | 二 | Claude Code v2.1.321 | Anthropic | https://github.com/anthropics/claude-code/releases/tag/v2.1.321 | 2026-11-09 | 2026-11-09T19:22Z |
| 10 | 二 | Ollama v0.40.16 | Ollama | https://github.com/ollama/ollama/releases/tag/v0.40.16 | 2026-11-09 | 2026-11-09T18:21Z |
| 11 | 三 | Anthropic IPO 路演最快 11-10 启动、估值 1.1–1.3 万亿 | Bloomberg(经腾讯新闻转述) | https://news.qq.com/rain/a/20261110A02LJM00 | 2026-11-09 | 2026-11-09(估值为「部分投资者」口径,非定价;S-1 于 10-26 递交) |
| 12 | 三 | October 2026 security incident update | Fireworks AI | https://fireworks.ai/security/bulletins/october-2026-security-incident-update | 2026-11-09 | 2026-11-09(11-02 起未再发现成功未授权访问) |
| 13 | 三 | Appel de Paris pour la sécurité de l'intelligence artificielle | Élysée(法国总统府) | https://www.elysee.fr/emmanuel-macron/2026/11/09/appel-de-paris-pour-la-securite-de-lintelligence-artificielle | 2026-11-09 | 2026-11-09(自愿声明、无法律约束力,仍开放签署) |
| 14 | 三 | 2026 企业 AI 现状(Menlo Ventures) | Menlo Ventures(经 aiproducthub 转述) | https://aiproducthub.cn/newsflash/menlo-report-chinese-models-89-percent-us-open-source-spend/ | 2026-11-03 | 2026-09-26(Morning Consult 调查截止;近 400 位决策者;Menlo 为 Anthropic 投资方) |
| 15 | 三 | 高盛收回交易员与投行家的 Claude Code / GitHub 权限 | Bloomberg(经 ic.work 转述) | https://www.ic.work/article/goldman-sachs-pulls-claude-code-and-github-from-traders-and | 2026-11-09 | 2026-11-09(内部指引 10 月更新;全行约 47,000 人,保留约 12,000 工程师) |
| 16 | 三 | NVIDIA、Rebellions 与 SK 电讯以 NVLink Fusion 推进主权 AI 基础设施 | NVIDIA 新闻稿 | https://nvidianews.nvidia.com/news/nvidia-rebellions-and-sk-telecom-announce-collaboration-to-advance-sovereign-ai-infrastructure-with-nvidia-nvlink-fusion | 2026-11-08 | 2026-11-09(首尔 AI Day 签署;R200 供货「2028 年起」) |
| 17 | 四 | CPU-ARC: agentic reasoning cache | arXiv | https://arxiv.org/abs/2611.09891 | 2026-11-06 | 2026-11-06(16–291× 为作者自测) |
| 18 | 四 | Parallel Agent Teams | arXiv | https://arxiv.org/abs/2611.09798 | 2026-11-06 | 2026-11-06(27B + 100 agent 预算;12 个长程任务) |
| 19 | 四 | Intent-Aware Caching | arXiv | https://arxiv.org/abs/2611.09715 | 2026-11-06 | 2026-11-06(WildChat / ShareChat 两套负载) |
| 20 | 四 | FOSCAR: affine folding for low-bit KV | arXiv | https://arxiv.org/abs/2611.09722 | 2026-11-06 | 2026-11-06(H100 / B200 + SGLang 集成) |
| 21 | 四 | BitDecoding-FP4 | arXiv | https://arxiv.org/abs/2611.09825 | 2026-11-06 | 2026-11-06(B300 上 Qwen3-4B / Qwen3-30B-A3B) |
| 22 | 四 | ENGRAM: verified consolidation for agent memory | arXiv | https://arxiv.org/abs/2611.09472 | 2026-11-06 | 2026-11-06 |
| 23 | 四 | An Empirical Study of GPU Kernel Libraries | arXiv | https://arxiv.org/abs/2611.09280 | 2026-11-06 | 2026-11-06(7 个库 / 300 条 issue) |
| 24 | 六 | synchopate/llama-modchip | GitHub | https://github.com/synchopate/llama-modchip | 2026-11-09(Apple Silicon 增量) | 2026-11-09 21:58Z(全部自测;M5 Max 64GB / M4 Pro 24GB) |
| 25 | 六 | DIYgod/pinky | GitHub | https://github.com/DIYgod/pinky/releases/tag/v2026.1110.2 | 2026-11-09 | 2026-11-10 01:29Z(1,437★ / Apache-2.0 / Go;11-06 创建) |
| 26 | 六 | google/elephant-goldfish-model | GitHub | https://github.com/google/elephant-goldfish-model/commits/main | 2026-11-09 | 2026-11-09(16,479★ / Apache-2.0;v0.1.1 于 11-06 21:50Z) |
引用提醒:本期第 1 条的全部性能数字均为 Anthropic 自测、无独立复现,其中 CyScenarioBench 76.3 / CVE Rediscovery 89.6 / de novo binder 85.1 三项是 Mythos 5.2(经验证准入,公开 API 不提供)的成绩,不可当作 Fable 5.2 的能力;「两篇黑洞物理论文」仅有数量表述,未经同行评审、不可称为解决开放问题;AutomationBench 51.4 低于 Gemini 4 Carbon 的 53.9,引用时不要只挑领先项。第 2 条的 Agents' Last Exam / PSI / PerceptionBench 为 Meta 内部评测,Terminal-Bench 各家自选 harness;Cloudflare 与 You.com 的延迟数字属合作方口径。第 3 条 ¥0.28 是 2K 方图编辑单张价,生成价不同;MagicArena 结论为官方口径。第 5 条的「50 任务 40 个成功」前提是无任务专属示范,与「1 次示范 71% / 5 次 95%」是两个不同口径,不可混用。第 6 条的 TPU 两款没有价格与 GA 日期,TPU Sync 的 >90% 未披露测试条件。第 7 条的 Control Room 只覆盖研究侧、不含对外模型服务栈,且 35 秒是上限而非常态。第 11 条的估值是投资者区间传闻,不是发行定价。第 12 条的「不完整模型权重被访问」限定于部分账户,不等于全量泄露。第 14 条须同时标注 Menlo 是 Anthropic 投资方、以及「Cursor Composer 2 基于 Kimi K2.5」未获官方确认。第 16 条的 R200 2028 年起才供货,当前无产品。第 17–23 条均为预印本、未经同行评审,加速比与精度数字为作者自测。第 24 条作者自己标注「放置带来 2× 差异但原因仍是 open」,引用时请保留这一限定。