AI DAILY
AI 日报 2026-11-11
一句话结论本期收录 23 条资讯(模型 6 / 工程 5 / 行业 5 / 论文 7)+ 4 条趋势 + 3 个开源项目,共 26 条写入索引,正文合计 30 条。淘汰账:脚本两轮共判 DUP 6 条(1 条翻案收录、5 条维持淘汰)、REVIEW 14 条里收录 11 条(9 条独立成篇 + 2 条降级合并为「发版小注」)淘汰 3 条、NEW 18 条里收录 12 条淘汰 6 条(4 条让位于板块容量、2 条时效违规),另 1 条时效误标由语义兜底剔除。最值得看的是 Anthropic 的路演公告与它旁边那份债务报告——不是因为 1.4 万亿美元这个数字大,而是因为这两件事在同一个星期里给出了同一个信号:AI 的定价权正在从「讲增长故事的人」转回「算现金的人」。一方面,Anthropic 把价格区间从 11-09 短暂流传的 $70–80 收窄到 $70–78、非稀释估值约 1.02 万亿、完全稀释上限 1.405 万亿,比半个月前递表时的 1.5 万亿明显缩水,比更早的 2 万亿目标接近腰斩;另一方面,路透同日的债券市场报道显示美国高收益信用利差在上周四扩到 348bp(2025 年 5 月以来最高),数据中心债扎堆的单 B 层扩 35bp 到 367bp,Galaxy Helios 的数据中心债从 9.875% 的发行收益率被抛到 13%。换句话说,股权端在压估值、债权端在抬成本,两头同时收紧——而 Anthropic 自己披露的未来算力承诺约 8,954 亿美元,是这次 IPO 加私募合计上限 904 亿美元的近十倍。技术侧同一天也有一条同样值得看的:Gemini 4 Carbon 全面开放,同时拿下 CursorBench 4.0、Perplexity WANDR、Zapier AutomationBench 三个独立第三方榜第一,且每任务成本不到次优外部模型的一半;但这条的正确读法是「用更多 token 换准确率 + 单 token 定价更低」,而不是「模型更省」——它在新自建的 MKA 多模态榜上只排第 2。真正把这两条串起来的是第三个细节:Mercor 说自己花在推理上的钱是员工薪资的 3 倍——当「推理支出超过人力支出」开始成为一门生意的常态描述,成本就不再是财务口径,而是产品定义的一部分。
AI 日报 2026-11-11
整理日期:2026-11-11 素材来源:白名单一手源(Anthropic 官方 newsroom 与 SEC 更新文件、Google 官方博客与 Google DeepMind 博客、OpenAI 官方博客、美团技术团队博客与 LongCat 官方博客、NVIDIA 官方博客、Reuters 经 US News / AOL / Yahoo Finance 全文转载、Mercor 官方博客、Path Robotics 官方新闻稿、GitHub Releases API 与仓库本体、arXiv 原始 abs 页),二手中文媒体仅用于发现线索并回溯一手源,逐条见文末附录 可信度提示:统计窗口 2026-11-10 00:00 → 11-11 09:40 HKT。四条口径先说清:① 11-10 是周二,美国厂商的发布集中在北京时间 11-10 深夜至 11-11 凌晨(Anthropic 路演公告、Google 两篇博客、OpenAI 两篇、NVIDIA 博客均在此段落地),llama.cpp 则在北京时间 11-10 09:00 至 11-11 07:00 之间推了 20 个构建。② arXiv 本期取到了 11-10 的 announce 批次(
arxiv.org/list/cs.AI/recent头部显示「Tue, 10 Nov 2026」,cs.AI 480 篇 / cs.CL 207 篇 / cs.LG 509 篇),但逐篇回查 abs 页后确认这批论文的[Submitted on ...]全部为 11-09——这是 arXiv 的提交与公布日期错位,正文与附录统一标注 submitted 日期,引用时请勿当作 11-10 提交。③cloud.google.com、support.google.com两个域在本机直连返回 000,Gemini for healthcare 与 Gemini 关联 Gmail/Drive 人工审核两条因此无法回溯一手源,已移入待核实或不收;businesswire.com与reuters.com主站亦返回 000,Reuters 两篇改以全文转载站取回,一手 URL 保留在附录并注明转载路径。④ 所有厂商自测 benchmark 均显式标注「厂商自测、无独立复现」,第三方榜与内部基准分开标注;Anthropic IPO 的发行条款来自官方公告,而估值、私募配售、财务数字来自招股书更新与路透计算,两者在正文中分行标注,不可混引。 配图:文中三张图为自绘(依据下列来源整理),非原文插图。
#AI日报 #模型动态 #Agent #推理基础设施 #论文 #开源项目 #资本市场
一句话结论
本期收录 23 条资讯(模型 6 / 工程 5 / 行业 5 / 论文 7)+ 4 条趋势 + 3 个开源项目,共 26 条写入索引,正文合计 30 条。淘汰账:脚本两轮共判 DUP 6 条(1 条翻案收录、5 条维持淘汰)、REVIEW 14 条里收录 11 条(9 条独立成篇 + 2 条降级合并为「发版小注」)淘汰 3 条、NEW 18 条里收录 12 条淘汰 6 条(4 条让位于板块容量、2 条时效违规),另 1 条时效误标由语义兜底剔除。最值得看的是 Anthropic 的路演公告与它旁边那份债务报告——不是因为 1.4 万亿美元这个数字大,而是因为这两件事在同一个星期里给出了同一个信号:AI 的定价权正在从「讲增长故事的人」转回「算现金的人」。一方面,Anthropic 把价格区间从 11-09 短暂流传的 $70–80 收窄到 $70–78、非稀释估值约 1.02 万亿、完全稀释上限 1.405 万亿,比半个月前递表时的 1.5 万亿明显缩水,比更早的 2 万亿目标接近腰斩;另一方面,路透同日的债券市场报道显示美国高收益信用利差在上周四扩到 348bp(2025 年 5 月以来最高),数据中心债扎堆的单 B 层扩 35bp 到 367bp,Galaxy Helios 的数据中心债从 9.875% 的发行收益率被抛到 13%。换句话说,股权端在压估值、债权端在抬成本,两头同时收紧——而 Anthropic 自己披露的未来算力承诺约 8,954 亿美元,是这次 IPO 加私募合计上限 904 亿美元的近十倍。技术侧同一天也有一条同样值得看的:Gemini 4 Carbon 全面开放,同时拿下 CursorBench 4.0、Perplexity WANDR、Zapier AutomationBench 三个独立第三方榜第一,且每任务成本不到次优外部模型的一半;但这条的正确读法是「用更多 token 换准确率 + 单 token 定价更低」,而不是「模型更省」——它在新自建的 MKA 多模态榜上只排第 2。真正把这两条串起来的是第三个细节:Mercor 说自己花在推理上的钱是员工薪资的 3 倍——当「推理支出超过人力支出」开始成为一门生意的常态描述,成本就不再是财务口径,而是产品定义的一部分。
一、模型与产品
1. Gemini 4 Carbon 全面开放:三个独立第三方榜第一,但正确读法是「贵着打准」
11-10 发布(更新,首报 10-29)。这是上个月只对 Fairwind 网络安全伙伴开放的 Carbon 正式向所有付费开发者、企业、科学家与消费者开放的一天,信息量集中在三个地方:可用范围、定价的截止日、以及那三个榜的组合读法。
可用范围:API 侧进 Google AI Studio 与 Gemini for business,面向所有付费开发者与企业;消费侧进 Google AI Ultra 订阅者的 Google Antigravity、Gemini app、以及 Search 的 AI Mode。同时在 Antigravity 里预览 /swarm——一句话拆成一支可实时追踪的 agent 团队,把 Carbon 派去架构设计、协调、审计这类最吃推理的角色,配更轻的模型并行跑在隔离工作区,再加上对抗式 verifier 逐个验改动。
定价有一个必须记住的日期:现在与 Argon 同价的引导价 $2 / $10 每百万 token(输入/输出),2026-11-30 之后翻倍到 $4 / $20,且官方脚注写明「仅适用于面向公众的 Carbon 模型」——也就是说 Fairwind 那侧的 Carbon for cyber 不在这个价目表里。
成绩要分三档读,混在一起就会得出错的结论:
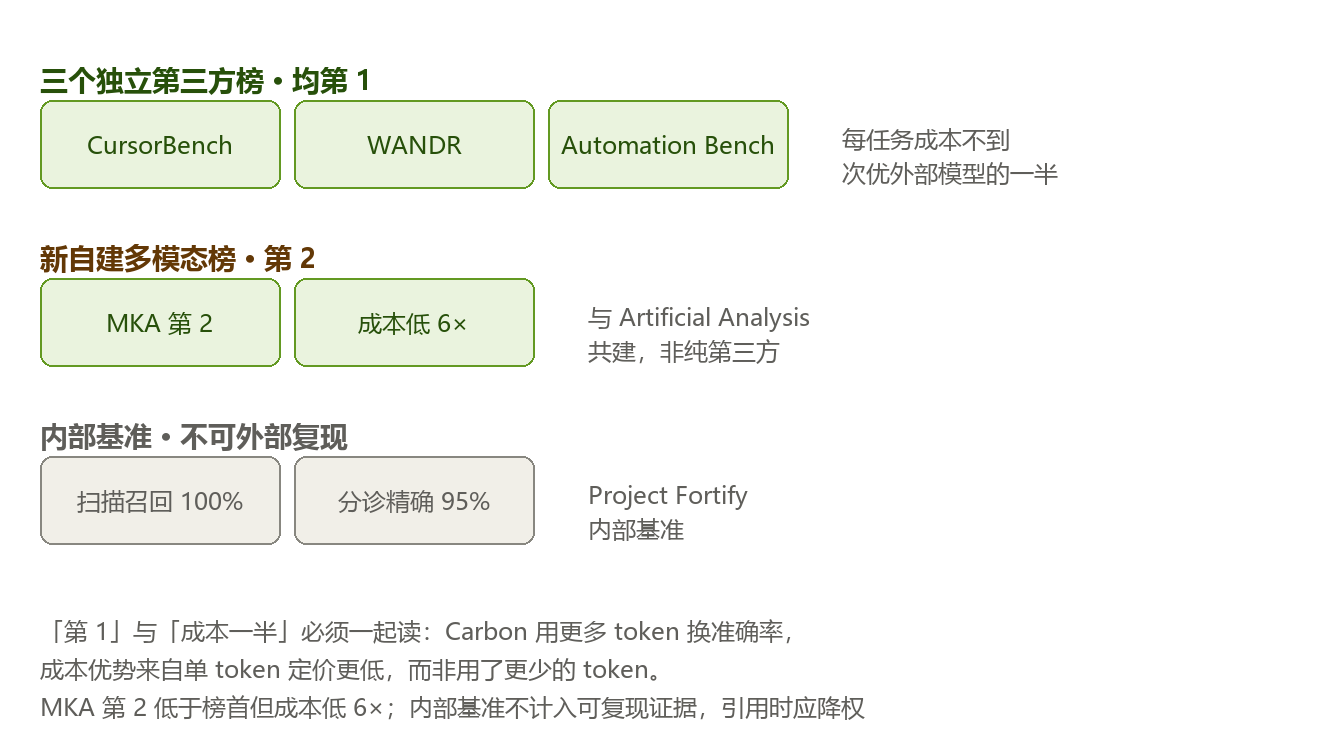
- 三个独立第三方榜,全第 1:CursorBench 4.0、Perplexity 的 WANDR、Zapier 的 AutomationBench,且官方称每任务成本不到次优外部模型的一半。
- 一个与第三方共建的新榜,第 2:与 Artificial Analysis 合作推出的 Multimodal Knowledge Agent(MKA),测的是 agent 工作流里对带图表、图纸、表格的密排文件做原生推理;Carbon 排第 2,但每任务平均成本比榜首低 6 倍以上。
- 内部基准,不构成可复现证据:Project Fortify(Google 自家的扫描—分诊—修复自治系统)上扫描召回 100%、分诊精确 95%;开源仓库测试中召回率相对 Argon 提升 25% 以上(相对提升,非绝对值)。
值得单独拎出来的是两个外部实战口径:Google 云漏洞研究团队(CVR)用 Carbon 给一个流行开源软件里的两个 bug 做出了可利用性证明,使其被重新定级为 critical 并快速出补丁;Wiz 的 Scan for Good 项目里,Carbon 在两小时内在两个大型 SaaS 供应商的公开基础设施里找到 0-day,官方称把原本数周的漏洞研究压到一个下午。
安全侧的数字比能力侧更密:模拟网络攻击环境里拦截了自适应红队 agent 99% 的攻击轨迹,单次尝试突破率降到 0.8%(Argon 为 3.1%);Gray Swan 测试中自动化网络攻击查询成功率 2.17%(Argon 9.86%);Trajectory Labs 132 小时、13,000+ 请求未发现新的通用越狱;Gray Swan 间接提示注入(IPI)攻击成功率 0%——官方称为首次达到该里程碑,但同一段里也承认高级红队显示「在某些分布上模型仍可被进一步攻破」。375 任务 agentic honesty 基准通过 92%(Argon 70%),其中拒绝补全缺失实验数据 98%、主动标记方法缺陷 68%。
来源:Google · https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ · 2026-11-10
2. Gemini Robotics 2.5:200 个任务、奔驰产线 96%,安全改成「推理时引导」
11-10 发布。这是 Gemini Robotics 系列的 VLA(视觉—语言—动作)新版本,官方定位是同时扩「能学的技能广度」与「学会的速度」。
评测覆盖 200 多个不同任务,官方举的例子是「用夹子分餐、给礼盒系蝴蝶结、移液」。相对此前基线,成功率提升 30%~100%(按任务类型)、完成任务快 20%~30%。原生支持多种机器人形态,包括 Apptronik 的 Apollo 2 人形(五根手指、22 自由度的 SharpaWave 手)与 Franka Duo 双臂平行夹爪平台。
最实的一段是产线验证:与 Apptronik、梅赛德斯-奔驰合作,在匈牙利 Kecskemét 与德国 Sindelfingen 的在产汽车线上做汽车配货(automotive kitting)——把散装料箱里的零件按每台车所需顺序分装到托盘里。这套流程用 Gemini Robotics ER 跟踪工作流、用 Gemini Robotics 2.5 动作模型控制手与臂,成功率达到 96%,并且能自行修正取件时的空档。Apptronik 的 CEO 说了一句值得记的话:模型在几周后训练里有大幅提升,搬到奔驰产线上「几乎没有衰减」。
安全侧换了一条路线:不再只靠事后分类器,而是用推理时引导(inference-time reasoning guidance)在实时里绕开物理危险,官方数据是障碍物附近的安全完成率 +33%、人群附近 +43%。同时开源了一个新基准 ASIMOV-Jailbreak——几百条把不安全请求伪装进几十个场景的提示;在这个基准上 Gemini 4 Argon 的越狱抵抗率 99.5%,此前基线 Gemini Robotics ER 2 为 82%。
来源:Google DeepMind · https://deepmind.google/blog/gemini-robotics-2-5-accelerates-real-world-physical-intelligence/ · 2026-11-10
3. AlphaProof Code:AI 把 Signal 协议的实际代码形式化验证了,600 万行 Lean、四周
11-10 发布。这条的分量不在「AI 又会写证明了」,而在于它跨过了形式化验证领域一条长期的分界线:过去几十年的协议验证大多停在设计层,而真实漏洞往往藏在设计与实现之间的缝里;这次证明的对象是设备上实际运行的编译后代码。
做法是把验证拆成「研究团队式」的分工:人类专家与多模型协作,决定证什么,把 Signal 的安全目标翻译成形式化数学规约,每一条都经人工复核;然后由 Gemini Carbon 驱动的 agent 去做证明,产出 600 万行 Lean 代码;接着 agent 自查并标出需要人再看的部分——只占代码量的 1%,其余由 Lean 自动检查。
耗时四周,官方称同类任务历史上要专家团队做数年。这个说法有一个可验证的支撑:研究团队把两个真实存在过、已修复的 bug 重新注入到隔离版的 Signal 代码里,两次系统都产出了机器可检的「该版本不安全」的证明——这至少说明它不是只会给正确代码盖章。
需要谨慎的地方也明确:官方称这是「首次用 AI 对广泛部署的加密协议做这种深度的形式化验证」,也是「首次由任何方法(含非 AI)完成对这类广泛部署协议实现的形式化验证」——这两句都是 Google 与 Signal CTO 的口径,尚无第三方独立复现;「四周 vs 数年」的比较基线也没有给出具体项目名。
来源:Google DeepMind · https://deepmind.google/blog/introducing-alphaproof-code/ · 2026-11-10
4. LongCat-2.5 正式开源:MIT、1.6 万亿参数,在单卡不足 80GB 的国产卡上跑长序列
11-10 发布(更新,首报 11-03;本次是开源权重这一新事件,索引 L663 记的是发布与参数,未有协议与工程路径)。美团这次给的不是「又一个万亿 MoE」,而是一份在受限硬件上把万亿 MoE 装进去的工程账本,这一点比参数更有信息量。
主干规格:总参数 1.6 万亿、每 token 激活约 480 亿、1M 上下文、原生多模态。协议是 MIT,明确支持商用推理部署与二次训练,无需额外授权——这个选择本身在国产开源里不算常见。
四条工程路径叠起来才是完整答案:
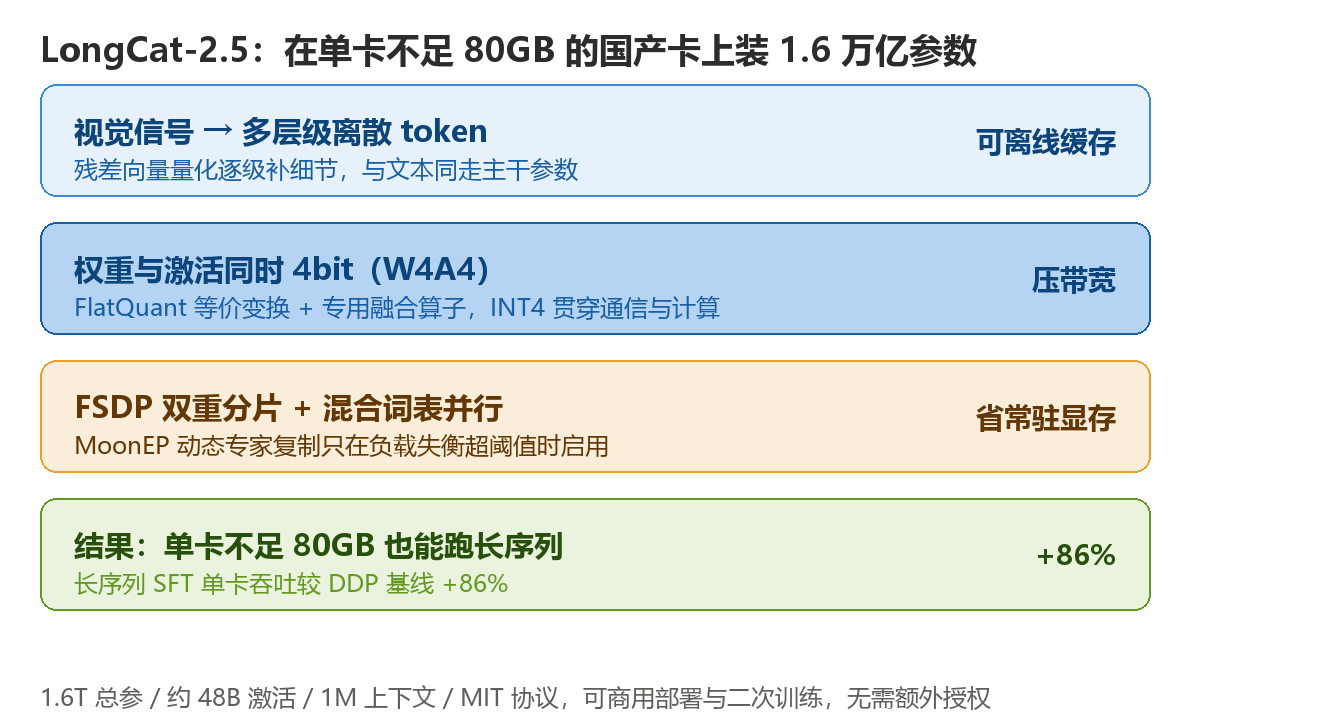
视觉表征不再外挂模块,而是把视觉信号表示成多层级离散 token,与文本一样交给主干统一处理:对原生分辨率特征做残差向量量化逐级补细节,视觉码本与主干联合训练,视觉 token 可离线预计算并缓存,顺带把分布式训练的负载摊匀了。
量化走 W4A4——专家权重与激活同时压到 4bit,由原生 INT4 矩阵乘单元执行;精度上以 FlatQuant 的可学习等价变换为基础优化 MoE 量化,官方称已评测的下游任务表现与量化前相当。数据路径上一处细节值得记:专家共享输入变换,在 token 复制与分发之前就完成量化,让同一份 INT4 表示贯穿专家通信与计算;变换、尺度计算、量化、打包融成一个专用算子,再配合权重布局与转置访问优化,减少搬运与转换。
并行与显存:FSDP 双重分片 + 扁平化缓冲区压常驻与峰值显存,混合词表并行进一步压缩;参数 AllGather、专家 token AllToAll、KV AllGather 尽量留在超节点内高带宽域;MoonEP 动态专家复制只在负载不均衡超过阈值时才启用(避免额外通信吃掉收益);零拷贝通信、参数预取、ScMoE 做通信计算重叠。结果是在单卡显存不足 80GB 的国产 AI 加速器上跑通长序列训练与微调,长序列 SFT 的单卡吞吐较 DDP 基线 +86%。
训练链路上还有三个不改变能力定义、但决定长任务能否稳定发挥的设计:把真实 agent 的失败轨迹转成可复现可验证的训练任务;partial rollout 异步训练让没跑完的长任务存下来续跑、过采样率按通过率动态调整;以及一组「防钻空子」约束——任务环境断网、清 git 历史与文件缓存、用 LLM judge 监督轨迹,对重复思考、重复工具调用、过度思考施加惩罚。
来源:美团技术团队 · https://tech.meituan.com/2026/11/10/Meituan-LongCat-2.5-Open-Source.html · 2026-11-10 权重:https://huggingface.co/meituan-longcat/LongCat-2.5 技术博客:https://longcat.ai/blog/longcat-2.5/
5. Claude 三件套:Whiteboards、Sheets 进 Beta,Dashboards 改名 Data 转 GA
11-10 发布。这条容易被当成功能更新略过,但三件东西的默认开关策略透露了 Anthropic 对企业侧数据面的谨慎程度,值得单独记。
Whiteboards(Beta):共享看板,可与 Claude 一起头脑风暴。能把你口述的杂乱计划转成带时间线、负责人、日期的看板;复盘场景里所有人贴笔记、Claude 按主题归类并起草各自行动项;可以框选看板任意区域就该区域提问;最后能把看板转成文档或幻灯片。Sheets(Beta):一句话生成含多标签页、公式、格式、下拉菜单的表格,可在单元格里直接编辑且逐条列出每处改动,可共享协同编辑,导出 .xlsx / CSV。Data(GA):前身是 10 月的 beta 版 Claude Dashboards,改名理由是「企业对数据的使用方式比仪表盘更广」。
Data 的几项能力里,两个是真正解决老问题的:certified queries 让数据团队认证「大家都该用的查询」,基于认证指标的图表带 certified 徽章,直接对口径冲突;live sharing 让同事打开共享仪表盘就能看到最新数字,即使他们没有维持数据更新的连接器权限——查看者只能看到已批准的查询结果,不能借你的权限跑别的查询。另外补了缓存与按仪表盘单独设置刷新频率、变更追踪与回滚到指定版本。
默认开关是关键:Team 套餐三项全默认开启;Enterprise 套餐里 Whiteboards 与 Sheets 默认关闭,Data 默认开启且生效日期是 2026-11-19。管理员在 Organization settings > Artifacts 里改。三个功能都面向所有付费套餐、Web/桌面/移动端可用;Data 另需配数据连接器(支持 Amazon Redshift、BigQuery、ClickHouse)。生态侧列了 Lucid / Miro / Vani by Zoho(白板)、Airtable / Asana / monday.com / Smartsheet 与 Claude for Excel(表格)。
来源:Anthropic · https://claude.com/resources/articles/sheets-whiteboards-data · 2026-11-10
6. Businesses in ChatGPT:让商家认领档案,再给它一个能卖货的 agent
11-10 发布(beta,仅美国)。OpenAI 第一次把「商家」当成 ChatGPT 里的一等对象,分两层:Business Hub 是商家自助认领与信息管理,认领并验证后可更新关键信息、接自助商品 feed(带价格与库存),看到被提及次数、网站点击、以及一个有意思的指标 discovery topics——「网站被引用的那些对话里的常见主题」。Business Agent 是认领后可自建、测试、上线的商家 agent,当商家出现在模型回答里、用户点开其资料页时可选择开启对话追问细节。
设计上有两条边界写得比功能更清楚:商家 agent 的对话「明确标注、与原对话分离、与 ChatGPT 的独立回答区分」;商家可 sponsor 自己的 Business Agent,并作为 ChatGPT Ads 的落地页,同样明确标注且与 ChatGPT 回答分离。数据侧承诺不共享用户对话给商家,洞察是聚合数据且需达到一定对话量阈值才可见。
规模背景是 1.2 billion 周活。资格上,认领向所有 ChatGPT 可用地区的合格商家开放;Business Agent 仅限美国的合格电商与在线服务商家,具体品类指向 policies 页。Shopify 商家已有 Shopify Catalog 通路,也可从 Business Hub 或 Shopify 后台连接店铺加速验证。页面未披露任何定价——文中出现的 pricing 一词指的是商家商品价格数据,不是 OpenAI 收费。官方把这次定位成「early step」,更多市场与品类只是「plan to」。
来源:OpenAI · https://openai.com/index/businesses-chatgpt/ · 2026-11-10
二、工程与架构
1. NVIDIA 把 OpenShell 捐给 CNCF:agent 安全运行时交给中立基金会
11-10 发布(KubeCon 现场)。这是本期工程板块最重的一条,因为它是治理结构的变化,不只是代码开源。
NVIDIA 把 OpenShell——一个用于保护和治理自治 agent 的开源运行时——捐给 CNCF,成为 Sandbox 项目。Linux 基金会 CEO Jim Zemlin 的表述把问题定义得很清楚:「云原生社区有了一个新的基础设施挑战:给 agent 提供安全的运行环境。」OpenShell 的做法是对 agent 活动施加确定性控制(deterministic controls),让团队在 agent 调工具、访问推理服务、执行负载时能强制执行策略;架构可扩展,允许接自己的算力、推理供应商、凭据存储与监控。官方给的采用量是「数百家组织在用,上线不到一年收到数万条贡献」。
同批还有三件事:NVIDIA 参与 Agent Substrate(Google 主导的、在 Kubernetes 上跑长时 agent 负载的开源框架)并推动其进入 CNCF Sandbox,同时让它与 NVIDIA Dynamo(推理)、KAI Scheduler(集群资源调度)打通;Agent Substrate 的核心机制是在任务之间保留 agent 环境、agent 空闲时释放算力,靠挂起/恢复避免为每个 session 常驻算力。NVIDIA 与 Google 还在做 OpenShell × Agent Substrate 的集成。
另外两个组件是 NVKE(NVIDIA Kubernetes Engine)与 NVKR(Kubernetes Recipes)进入公开预览,做 GPU 基础设施上的托管 K8s 服务,自动集群生命周期 + 签名版版本固定镜像;Mirantis、Netris、OpenNebula、Rafay、Spectro Cloud、vCluster、Firmus、SK Telecom 已对齐集成。以及 NVIDIA Snapshot 开源——恢复 checkpointed 副本不需要重载模型或 warmup,直接秒级起。两个设计伙伴在 HGX B300 上自己跑出的数字:Crusoe 把 GLM-5.3 的就绪时间从约 8 分钟压到 31 秒;Saturn Cloud 把 vLLM 启动从 2–8.5 分钟压到 6–34 秒。
来源:NVIDIA · https://blogs.nvidia.com/blog/open-source-openshell-infrastructure/ · 2026-11-10(作者 Warren Barkley)
2. llama.cpp b12241–b12262:11-10 单日 20 个构建,mtmd 接上 Kimi K3.1 视觉
11-10 全天(更新,首报 11-09 的 b12212–b12240;本次区间与之仅重叠 b12238–b12240 三个构建,其余 17 个为新内容)。脚本以强键 b12262 判 DUP,回溯一手 release 页确认是新区间后翻案收录。这一天最值得记的不是版本号,而是修复的分布:几乎全是「某些硬件/某些路径上会错但不会报错」的问题。
- b12262 之前:
mtmd: add kimi K3.1 vision (#31980)——多模态侧接上新模型的视觉编码;mtmd: share compute buffer among subcontext (#31945)——子上下文共享计算缓冲,降峰值。 - CUDA:
skip graph compat check when graph is being reused (#32004)、move graph and concurrent stream state out of common.cuh (#32001)——图复用路径的检查开销被拿掉,状态从公共头文件迁出。 - Vulkan 一排:
Fix out of bounds reads/writes on MoltenVK (#31890)(越界读写);cap scalar flash attention at 8 rows for large heads on Qualcomm (#30829)——这条细节很典型:Qualcomm X1-85 上大 head 的标量 FA 会每次寄存器溢出 264 字节,限到 8 行后不再溢出但慢 40 倍,属于「正确性优先、性能另议」的取舍;Divide GROUP_NORM workgroup to 2D (#31930);add tiled-transpose concat shader for Qwen models (#30591)。 - 工具调用与 JSON:
common: escape control characters in tool argument strings (#31937)、chat: don't use lazy grammar when response_format is set with tools (#31956)、common/json-schema: fix allOf with plain types (#31834)——这三条都在修「结构化输出与工具调用叠在一起时」的老毛病。 - 其他:
ggml-rpc: fail gracefully on unreachable endpoints (#30415)、hexagon: fix 64-bit FastRPC handle truncation (#30952)、sycl: un-gate oneDNN fused SDPA for Alchemist at head_dim=64 (#31574)。
来源:ggml-org · https://github.com/ggml-org/llama.cpp/releases/tag/b12262 · 2026-11-10(当日 20 个构建,b12238 00:23Z → b12262 23:04Z)
3. 两个发版小注:Claude Code v2.1.322 与 Ollama v0.40.17-rc0
两条都够不上单列,但各自有一处会影响选型的变动,合并记一笔。
Claude Code v2.1.322(11-10T02:29Z)只有一行变更:Added fast mode on Vertex in the global, us and eu regions, falling back to standard speed if Vertex refuses it。它把 fast mode 从 Anthropic 直连扩到 Vertex 的三个 region,且明确写了拒绝时回落标准速度——这一点比功能本身重要,因为上期 v2.1.316 的 Opus 4.8 fast mode 弃用说明里写的是「移除后报错不回落标准模式」,两个方向的处理不一致,说明「回落」是按路径单独定的策略。
Ollama v0.40.17-rc0(11-10T22:25Z,预发布):mlx: support concurrent generation——MLX 路径支持并发生成,这是 Apple Silicon 上长期只有单路的关键短板;llm: use mmap for Vulkan integrated GPUs——Vulkan 集显改走 mmap,直指集显显存与主存边界的老问题;cmd/launch: use thinking metadata for OpenCode settings;内置 llama.cpp 升到 b12257,MLX / MLX-C 同步升版。仍是 rc,未转正式版。
来源:Anthropic · https://github.com/anthropics/claude-code/releases/tag/v2.1.322 · 2026-11-10 来源:Ollama · https://github.com/ollama/ollama/releases/tag/v0.40.17-rc0 · 2026-11-10
4. Modern Web Guidance v1.0.0:四家浏览器厂商共管,203 个用例指南喂给 coding agent
11-10 发布(仓库 11-10T03:22Z 推送,release 11-10T03:24Z)。这个项目 2026-03-23 建仓、此前长期在 preview,v1.0.0 意味着它从「Google Chrome 的项目」变成了Chrome + Edge + Firefox + MDN 四家共管——这是它区别于一般「agent 技能包」的地方:内容不是某一家对 Web 标准的解释,而是四家引擎团队共同维护的口径。
规模:203 个用例指南覆盖 250 项 Web 平台特性(CSS 与布局 140、HTML/DOM 36、JS/API 74)。CLI 侧新增 legacy-scan——npx modern-web-guidance@latest legacy-scan [path] 静态检出遗留的 Web 平台写法,每条发现映射到「现代替代」对应的指南文档;官方说目前覆盖约 20% 有确定性规则的指南,配套 skill 里加了 scan → verify → report → modernize 四步流程。检索从 TensorFlow.js 换成零依赖 embedding 模型 + BM25,仍完全离线,npm 包体从 23.5 MB 降到 8.8 MB。新增 set-allow-volatile-features:近三个月内才落地或仍在稳定的单引擎特性,指南仍可检索但 retrieve 需要在 .mwgrc 里显式 opt-in(对齐 Origin Trial 的门控思路)。仓库 Apache-2.0、3,249★。
对做前端 agent 的人来说,真正的价值不在「有 203 篇文档」,而在 legacy-scan 把「现代化」这件事变成了可枚举的检查项——这是把规范知识转成可执行任务的那一步。
来源:GoogleChrome · https://github.com/GoogleChrome/modern-web-guidance/releases/tag/v1.0.0 · 2026-11-10
5. Reuters:微软在劝白宫别禁中国光模块,理由是「芯片会闲着」
11-10 发布。这条放在工程板块而不是行业板块,因为它讲的是一条供应链上的物理约束,而不是政策态度。
三名知情人士称,微软一直在推动特朗普政府放弃禁止进口中国产光收发器(optical transceivers)的计划。背景是路透 8 月报道过该意向:美方担心这类在数据中心内以光速传数据的组件被用于窃取数据、植入恶意软件或扰乱服务,由 FCC 牵头推进。微软在美国有 35 座数据中心在建、另有 134 座在规划(Cleanview 数据),是 9 月与白宫科技政策办公室、国家安全委员会会面反映供应链压力的少数公司之一。
ITI 总法律顾问 John Miller 的表述把工程后果说得很直白:很多云厂商已经买了 AI 芯片,「那些芯片没有光模块,就只能干等着、无法被利用,直到你真的有光模块把它们连起来」。一个数据中心需要数百万个光模块来连服务器、路由器和交换机。
替代性上,Counterpoint Research 的数据是中国占全球光模块市场 三分之二(Eoptolink、中际旭创等),美国 Coherent 与 Lumentum 有竞争技术但规模不足以替代(Foundation for American Innovation 报告)。摩根士丹利 10 月的客户纪要称,正在考虑的禁令门槛是能跑 3.2 Tbps 的型号——这类产品预计 2028 年才量产、2029 年才广泛部署,等于给美国厂商留出扩产时间。ITI 已于 8-13 致函 FCC 反对列入贸易黑名单。
来源:Reuters(经 AOL / Yahoo Finance 全文转载) · https://www.aol.com/articles/exclusive-microsoft-presses-trump-scuttle-110129000.html · 2026-11-10
三、行业与发展
1. Anthropic IPO 路演启动:8.25 亿股、$70–78,七家芯片云厂另投 260 亿
11-10 发布(更新,首报 11-07 / 11-08 的估值下修;本次是官方路演公告 + 确定价格区间,属实质进展)。这一条必须分成「官方公告说了什么」和「招股书与路透补充了什么」两层来读,混在一起容易把不同来源的数字当成同一口径。
官方公告(一手):拟发行 825,000,000 股 A 类普通股,其中 801,351,354 股由 Anthropic 自己发行、23,648,646 股由现有股东出售(公司不从老股销售中获得任何收益);承销商有 30 天超额配售权,最多再买 123,750,000 股;价格区间 $70.00–$78.00;申请在 Nasdaq Global Select Market 挂牌,代码 ANT;高盛与摩根士丹利为牵头承销。
招股书更新与路透计算(二手核对):按上限每股 $78 计,公开发行部分最高募资约 644 亿美元;另有 260 亿美元 N 类普通股私募配售,在 IPO 完成并满足条件后交割——谷歌与英伟达各 100 亿、AMD 25 亿、博通/美光/微软各 10 亿、台积电相关实体 TSMC Partners 5 亿;两笔合计上限约 904 亿美元。估值上,非稀释市值约 1.02 万亿美元,计入期权与限制性股票后的完全稀释估值上限约 1.405 万亿美元。时间上,路透与 CNBC 口径为 11-18 定价、11-19 开始交易;官方公告未给交易日期。
财务侧(招股书):Q3 营收 169.56 亿美元,同比增约 1127%,但环比增速从 Q2 的 144% 骤降到 47%;前九个月营收 332.4 亿美元。截至 10-31 的年化收入运行率约 810 亿美元,比 9 月底的约 710 亿一个月增加 100 亿。未来算力采购与租赁承诺累计约 8,954 亿美元。
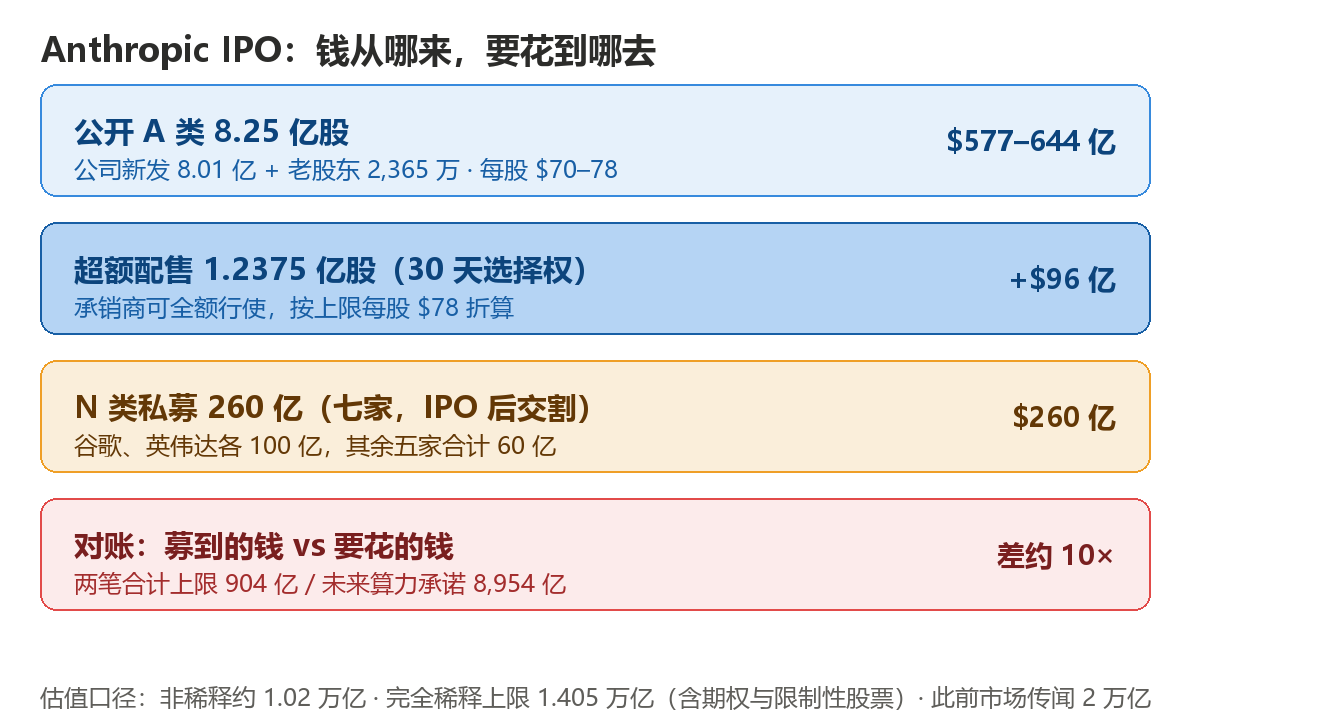
这张图要读的是最后一行:把两笔融资的上限加总(904 亿)和未来算力承诺(8,954 亿)放在一起,差着一个数量级。这不是说这轮融资不够——IPO 本来就不负责覆盖全部资本开支——但它解释了为什么承销商要给出一份到 2030 年营收超 6,000 亿美元、2030 年自由现金流转正 336 亿美元的预测:故事必须拉到那么远,8,954 亿的承诺才讲得通。
来源:Anthropic · https://www.anthropic.com/news/roadshow-launch · 2026-11-10 来源:Reuters / The Straits Times · https://www.straitstimes.com/business/anthropic-targets-us1-trillion-ipo-valuation-in-test-of-wall-streets-ai-fervor · 2026-11-10
2. Reuters:AI 债务承压,高收益利差创 2025 年 5 月以来新高
11-10 发布。这条和上一条是同一个星期的两半,应该连着读。
数据(ICE BofA 美国公司债指数):美国高收益信用利差在上周四的股市抛售中扩到 348 个基点,为 2025 年 5 月(特朗普加征全球关税后一个月)以来最高;周五收窄到 342bp。投资级利差上周四 93bp,前一日 91bp。数据中心债多集中在垃圾级的 BB 与单 B 层,单 B 利差扩 35bp 至 367bp,为 3 月以来最高,是高收益市场里恶化最快的一档。
最具体的一个案例:Galaxy Helios 数据中心债 11-05 跌到 89.25 美分,收益率从 Galaxy Digital 全资子公司在 7 月底发行 B+ 级债时的 9.875% 抬到 13%。
原因链条是「民主党 1 月接管国会 → 拟推一批针对 AI 系统与数据中心建设的立法 → 投资者重估 AI 相关信用」。特朗普在中期选举失利后于周末释放了对 AI 护栏的开放态度。多位基金经理的口径可以归成三层:短期,更严的监管意味着新债供给减少,对信用市场反而是缓解,市场需要 6–12 个月消化前期扩张;中期,已开工项目与已做出的资本承诺不会立刻转向,2027 年的资本开支与发行数字不太会变;长期,不确定性主要影响 2028–2030 及以后。
值得记的两句反向判断:Capital Group 的 Karen Choi 明确说影响在「later years」;FedWatch Advisors 的 Ben Emons 则给出了最干脆的一句——「AI 不会慢下来。如果它在得州慢下来,它会在另一个州冒出来,然后继续。」
来源:Reuters(经 US News 全文转载) · https://www.usnews.com/news/politics/articles/2026-11-10/analysis-ai-debt-faces-pressure-as-democrats-prepare-to-take-over-congress · 2026-11-10
3. Mercor 拿 7.5 亿美元 D 轮、估值 200 亿:把「企业自建 eval + 后训练」做成生意
11-10 发布。官方博客的说法比融资数字更值得看:它把「企业拥有自己的智能」讲成了一条可复制的路径——从一个够用的开源模型出发 → 建公开 eval → 后训练降本 → 再为客户训模型,并声称后训练所需的资源只是前沿训练的零头。
融资侧:7.5 亿美元 D 轮,估值 200 亿美元,含一笔员工老股转让(employee tender);投资方包括 Benchmark、Felicis、Fundomo、Apollo 关联基金、G Squared、General Catalyst、Glade Brook、NVIDIA、Salesforce、Sapphire、StepStone、XTX、Zoom。路透补充的背景是:去年 10 月上一轮 3.5 亿、估值约 100 亿,亦即一年翻倍;公司背书方包括 Jack Dorsey 与 Peter Thiel;2026 年 Q3 全球风投 1,020 亿美元、AI 占 64%(Crunchbase)。
业务侧:专家网络 500 万+ 人;官方称美国有 800 多个不同职业,每个职业里都有模型尚未被评测过的工作流;今年收购了 Deeptune(用两年时间重建了数百个企业应用,供 agent 在里面练习专业流程)。最刺眼的一个自述数字是:Mercor 花在推理上的钱已经是员工薪资的 3 倍,并称这笔钱靠「让团队更会干活」自己赚回来了;联合创始人 Brendan Foody 由此推出「若这个比例随 AI 扩散到整个经济,指向未来五年接近两位数的 GDP 增长,约为此前常态的 3 倍」。
这条要保留两个限定:3 倍是公司自述、未披露分母口径;用一家 AI 训练公司的支出结构外推全经济,是把一个极端样本当成了先行指标——方向上值得留意,幅度上不能当预测。
来源:Mercor · https://www.mercor.com/blog/series-d · 2026-11-10 来源:Reuters(经 The Star 转载) · https://www.thestar.com.my/tech/tech-news/2026/11/11/ai-training-startup-mercor-valued-at-20-billion-in-latest-funding-round · 2026-11-10
4. Path Robotics 拿 3 亿美元 E 轮、估值 24.5 亿:焊接跑通后想包下整条产线前后的活
11-10 发布。官方新闻稿(Columbus, Ohio)与彭博的补充口径一致:3 亿美元 E 轮,投后估值 24.5 亿美元,Georgian 领投,现有投资方 Addition、Drive Capital、IronArc、Tiger Global、Yamaha Motor Ventures 及其关联方参与,新投资方 D. E. Shaw Ventures 与 NAVER Ventures;Georgian 合伙人 Emily Walsh 进董事会。彭博称这轮把估值抬到接近原来的四倍,公司累计融资超 6.1 亿美元。
值得记的不是估值倍数,而是它把「物理 AI」的进展量化成了三条可核对的线:18 个月内 ARR 增长 17 倍(未披露绝对 ARR,因此无法换算营收规模);与 HII 的 6 亿美元履约型生产协议(performance-based,是协议金额而不是已确认收入);员工同比 +97%、年底目标 400 人。客户里还有 Lockheed Martin 与 Saronic。
技术路径是「先啃最难的那个」:从焊接切入,核心模型 Obsidian 让机器人自己识别焊缝、规划路径、随工况调整,而不是跑固定程序;今年 4 月推出 Rove,把 Obsidian 装到四足平台上做移动焊接(彭博称有 50 台预订,明年起在船厂、工地、重工业现场与人一起干活)。CEO Andy Lonsberry 的说法是「目标不是自动化一个步骤,而是自动化整个工厂」,并强调「我们的客户从没有因为任务机器人开除过焊工」。
来源:Path Robotics · https://www.path-robotics.com/news/path-robotics-announces-300-million-series-e-led-by-georgian · 2026-11-10 来源:Bloomberg · https://www.bloomberg.com/news/articles/2026-11-10/path-robotics-quadruples-valuation-to-2-5-billion-in-latest-funding-round · 2026-11-10
5. OpenAI 经济研究:自由职业不是被替代,是被「重新捆绑」
11-10 发布。与 Upwork 合作的《The Rebundling of Freelance Work in the AI Age》,作者 Caroline Chin、Shagun Kala、Nadav Kunievsky、Teng Liu、Alex Martin Richmond、Carl Shan。数据口径:ChatGPT 使用占比 2025-01 → 2026-06,Upwork 快照取 2026 上半年,同比对比 H1 2025 → H1 2026,预算与工时数据截至 2026 年 4 月。
三条主结论:63 个可匹配子类别中,43 个呈现「ChatGPT 里常见 → Upwork 份额下降 / ChatGPT 里冷门 → 份额上升」的模式,20 个相反——所以作者自己写明「ChatGPT 的使用量不能单独解释自由职业需求的变化」。任务多样性提升 45%:AI 相关帖子的任务组合从约 14.6 个等效均衡任务变成约 21.2 个。定价上,AI 相关项目的时薪与其他项目基本持平,但固定总价预算更高、工时更多——更高预算反映的是范围更广,不是单价溢价。
最实用的一句是平台间的错位:写作在 ChatGPT 使用中的占比远高于在 Upwork 需求中的占比;视频与动画正相反,在 Upwork 需求中占比远高于 ChatGPT 使用占比。这解释了为什么「AI 写文案」的焦虑最响,而视频外包的需求反而在涨。
作者主动给的三条限定值得抄下来:结论反映的是人当前怎么用 ChatGPT,而非 AI 能支持的全部任务范围,二者之间存在「能力悬置」;不是简单的替代故事;只覆盖 Upwork 与 ChatGPT 两侧数据,存在自选择偏差,且企业的内部工作演变不会体现为新的招聘或职位发布。
来源:OpenAI · https://openai.com/index/ai-effect-on-freelance-work/ · 2026-11-10
四、论文与开源
本期 7 篇全部为 11-09 提交、11-10 公布(arXiv 的提交/公布日期错位,见可信度提示②),均为预印本、未经同行评审;所有加速比与精度数字为作者自测。
1. 2611.12240 Prune, Don't Merge:MoE 压缩在生产任务上,剪枝完胜合并
这条的价值在于它把两个「学术榜上打平」的方法搬到了一个真实公司的五种多语言生产任务上(一家 web hosting 企业,从分类到生成营销 HTML 邮件模板),然后打出了一个悬殊的差距。
设置:两个 30B 模型(Qwen3-30B-A3B-Instruct-2507 与混合 Mamba-attention 的 Nemotron-3.5-Lightning),砍掉 25% 与 50% 的专家,同一套校准数据,对比 REAP(专家剪枝,删最不显著的)与 REAM(专家合并,并进最显著的)。结果:同一批样本上 REAP 在 20 组比较中 16 组显著更好,REAM 只有 2 组。25% 档位上 REAP 保住 Qwen3-30B 93.6% 的生成质量,REAM 只有 62.5%——而在学术基准上两者「同模型差距不到 1 分」。
最有诊断价值的一句是:损伤集中在输出契约而不是内容——邮件模板上每一处显著损失里,89.8%–95.2% 来自硬性门槛失败(非法 JSON、移动端布局崩坏、生成跑飞),而且多数失败的非英语领域描述会照抄提示词里的英文开头短语。附带的两个诊断量也值得记:REAP 论文里的 cross-perplexity 与 logit divergence 在生产质量上同样有效,重复循环率也有效,而 n-gram 多样性无效。
来源:arXiv · https://arxiv.org/abs/2611.12240 · 2026-11-09
2. 2611.12832 What the Loss Curve Misses:FP4 预训练让稀有事实学得更慢,而 loss 看不出来
这是一篇会改变「低精度训练验收标准」的论文。
做法:从零训 transformer,用仿真的 4-bit 矩阵乘,在合成传记数据上做受控曝光次数实验(单独训、也混进 web 文本)。结论:NVFP4 要达到 BF16 的召回率,需要 1.32× / 1.52× 的曝光次数,而两者的验证 loss 只差 0.5% / 2%;若两边都用 BF16 矩阵乘评测,曝光成本降到 1.26× / 1.30×;按作者的主读数口径,等 loss 条件下的曝光成本约 1.2×。
机制拆解比结论更有意思:零均值梯度噪声能复现「只量化反向传播」的成本(而这种量化几乎不动 loss);在双倍 NVFP4 误差的受控实验里,只喂给 Adam 二阶矩估计的噪声表现得像降低学习率,成本会消退;喂进更新量的噪声会压低信噪比,成本一路带到训练结束,占总成本约三分之二。而靠提高学习率去补偿变小的平均步长,对这个噪声、对 NVFP4 都补不回来。
一个可直接拿来用的副产品:用 BF16 checkpoint 的梯度统计量,不拟合就能排出各种格式、部分量化与噪声控制的成本顺序,Spearman 0.96。作者的呼吁很简单:评低精度配方时,除了 loss 还要测稀有事实的获取速度。
来源:arXiv · https://arxiv.org/abs/2611.12832 · 2026-11-09
3. 2611.12377 Detecting Shadow AI:企业端点上的未授权 agent,能检测但有时间窗
Shadow IT 是老问题,这篇提出的是 agent 会让它指数级变快:agent 让造工具近乎免费、以用户权限行动、还会留下脚本、自动化和 MCP server 这些本身也没被批准的东西。作者给了一个简单的复合模型:一旦 agentic artifact 的复制速度快过组织的清理速度,shadow IT 就指数增长;而清理的第一步是先能看见。
检测部分:提出九类 agent × 六层端点足迹的分类法,然后指出一个关键判断——只看进程与连接结构的规则,无法把 agent 和它的「行为孪生体」区分开(同一个程序对非 AI 服务说话)。他们开源的 Windows 检测器 Agent Detector 把行为锚定到远端服务的身份上,并与安装、配置、执行历史做关联,用了 39 个工具、184 条 LLM 端点条目的目录;发现时是弹一个用户必须确认的通知,不阻断。
在 12 个合成 agent、3 个 AI 组件、9 个良性负载的受控台架(同一工作站重复 5 次)上:两条纯行为规则把每一个行为孪生体都误报,Agent Detector 一个都没误报,且多数轮次里检出了全部 agent。作者自己列的限制很实在——时间性局限:走共享 CDN 的供应商连接只有 DNS 缓存还留着名字时才能归因,窗口 1 到 5 分钟;一个间歇运行的 agent 大约每三次扫描才被看到一次;单次扫描 154 ms;台架太小,不足以给检测器排名。
来源:arXiv · https://arxiv.org/abs/2611.12377 · 2026-11-09
4. 2611.12820 AI 同行评审到底行不行:100 个植入错误给出了一个不太好看的答案
做法很干净:把 100 个已知错误植入 10 篇开放获取的心理学论文,再把改过的论文喂给前沿模型与两个商用 AI 评审工具。
结果:最好的单系统抓到 71/100,最差的 30/100;把所有系统的输出合并起来能抓到 93/100——这说明各模型发现的错误只有部分相关,ensemble 是找问题的一大杠杆。有 7 个错误没有任何系统抓到,而这 7 个全是「遗漏」(omission):从论文里删掉信息,而不是塞进错误。这一点比总分重要——它说明当前 AI 评审擅长「找出文中写错的东西」,不擅长「发现文中少了什么」。
另外两个必须一起引的限定:误报没有被测量;这批错误的分布与真实论文里错误的分布如何对应,未知。作者公开了论文、错误、模型输出与完整实验日志。
来源:arXiv · https://arxiv.org/abs/2611.12820 · 2026-11-09
5. 2611.12356 DForkTree:投机解码的 draft 树,问题不在 drafter 知道什么,在它被什么前缀带着走
这条把块的投机解码里一个隐蔽的失效点挖出来了。块扩散 drafter(如 DFlash)一次前向出一整块,DDTree 再从它的逐位置分布建树——但每个位置的分布都假设 drafter 自己那条最可能的续写是对的。而一棵树相对一条链的全部收益,恰恰来自离开这条续写的分支:在这些分支上,drafter 的 top-1 命中率从 89% 掉到 18%,候选列表漏掉正确 token 的频率也高得多。
关键诊断:从 fork token 处重新跑同一个 drafter,它通常是对的——所以错误不是来自 drafter 的能力,而是来自分布所条件化的那段前缀。
方案 DForkTree 是训练无关的:用目标模型自身输出的 n-gram 统计,以点互信息的形式加到 drafter 分数上,在 fork 之后给更高权重,再在 GPU 上精确构造这个分数下的最优树。在 Qwen3.5-4B 与 9B 上(所有树方法共享同一 drafter、同一树流水线、同一 verifier),它在每个基准上都是最快的树方法:比 DFlash 快最多 41.5%、比 DDTree 快 15.1%,相对自回归解码平均加速最多 4.75×。
来源:arXiv · https://arxiv.org/abs/2611.12356 · 2026-11-09
6. 2611.12464 Phrase-Level Speculative Decoding:把 draft 的单位从 token 换成「词」
这条的出发点是一个被当成常量的东西:分词器。Medusa、EAGLE-3、DFlash、DSpark 都在目标模型的词表里 draft,于是一个候选节点 = 一个目标 token,看起来天经地义。但 BPE 的预分词在学 merge 之前就先按空白切分,所以任何跨空白的多词字符串都不可能成为单个 token——在 Qwen3-4B 里 "United States of America" 是四个 token,且任意相邻两 token 的组合都不存在,于是短语在任何「在目标词表里 draft」的方法里都不可达。
方案是换单位:一个小 MLP 头读冻结目标的隐状态,在独立的 draft 词表里把一个 1–3 词的短语预测成单个条目,再用贪心最长匹配展开回目标自己的 token;N 个候选在一次前向里、用前缀树掩码并行验证,因此与树的深度宽度正交。目标与其分词器全程冻结,且候选只有匹配目标自身 argmax 时才被接受,服务输出与贪心解码逐位相同(除浮点平局)。
数字:单张 A5000、batch 1、对 HuggingFace generate(),一个 21.94M 的头(Qwen3-4B 的 0.545%)在 GSM8K 上 2.391×、MATH-500 上 2.444×、MT-Bench 上 1.544×。因为输出层每个条目只占 257 个参数的一行,draft 词表大小就是参数预算:8,000 条目 = 3.434M 参数(目标的 0.0854%,比 EAGLE-3 的 drafter 小 64 倍),保留大头的 92.3% GSM8K 每轮 token 数。与 EAGLE-3 同提示同基线比,这个 21.94M 的头在两个数学集上赢 tree-16、输 tree-60。
来源:arXiv · https://arxiv.org/abs/2611.12464 · 2026-11-09
7. 2611.12856 WorkflowArena:当模型自己当架构师,「组织方式」本身变成一种可测能力
现在的 agent harness 已经允许模型自己实例化 worker、自己写协调它们的可执行工作流——系统结构的设计权从开发者手里转到了模型手里。而现有基准要么只测端到端完成,要么在预先指定的结构下测协调,测不到这种能力。作者把它形式化为 workflow orchestration,并给出 WorkflowArena:145 个长程任务、8 个专业领域(软件工程、形式数学、法律分析、3D 制作等)。每个任务给一个初始工作区和一个由互相依赖组件构成的交付物,由隐藏 verifier 判分;agent 自主决定是否、以及如何委派,所有委派都被记录,从而能同时评估交付物质量与工作组织方式。
九模型实验的两个观察值得直接抄:没有任何单一配置在所有领域最优;不同系统的委派策略有清晰指纹——高 effort 下,Claude 系在 Claude Code 里调用工作流更少但 worker 组更大,GPT 系在 Codex 里委派更频繁但单位更小。第三个结论最有分量:把执行模型固定在一个挑战子集上,由 Claude Opus 5.5 撰写的工作流能显著提升更弱的执行者——说明工作流组织本身就是任务表现的独立决定因素。
来源:arXiv · https://arxiv.org/abs/2611.12856 · 2026-11-09
五、值得关注的趋势
1. 「成本优势」正在从形容词变成一张可核算的表
同一天里,Carbon 讲了「每任务成本不到次优外部模型的一半」,并在 MKA 上给了「第 2 但成本低 6 倍」;Mercor 讲了「推理支出是薪资的 3 倍」;NVIDIA Snapshot 不讲 FLOPs 而讲「就绪时间 8 分钟 → 31 秒」。三个不同层级的主体(模型厂商、应用公司、基础设施厂商)用的是同一个句式:不说我更快,说我每完成一件事花多少。这个转向有具体后果——当计价单位从 token 变成任务,模型选型就不再能只看榜单分数,而必须把「这个模型会多花多少 token 去探索」算进去。Carbon 官方那句「比 Argon 用更多 token 去彻底探索、深度推理、跑更长的验证循环」正是这个逻辑的自白:它的成本优势来自单 token 定价更低,而不是用得更少。
2. 开源权重的战场从「追平分数」转到「跑得起来」
LongCat-2.5 通篇没有把重点放在榜单上,而是放在「单卡显存不足 80GB 怎么办」:W4A4、FSDP 双重分片、混合词表并行、MoonEP 阈值触发的动态专家复制、ScMoE 通信计算重叠。llama.cpp 同一天 20 个构建里最典型的修复是「Qualcomm 上大 head 的标量 FA 每次溢出 264 字节,限到 8 行不溢出但慢 40 倍」;Ollama 的 rc 里最受关注的两条是 MLX 并发生成与 Vulkan 集显 mmap。这些都不是「能力提升」,而是让一个已存在的能力在特定硬件上不出错、不被浪费。对国内团队来说,这个转向比任何一次榜单刷新都更有实际价值,因为它决定了「能不能用」而不只是「好不好用」。
3. 企业侧的瓶颈从「模型够不够强」移到了「看不看得见、停不停得下」
把四件事排在一起看:arXiv 的 Shadow AI 论文说 agent 会让未授权工具指数增长、而规则检测无法区分 agent 与其行为孪生体;同期的 Double Blind Evals 用 H100 机密计算让评测方与模型方互不泄露;OpenAI 上期的 Control Room 把熔断做成 fail-closed 的中央服务;NVIDIA 这期把 OpenShell 捐给 CNCF,让 agent 的确定性治理进入中立基金会。四条指向同一件事:当 agent 真的开始长时间、多工具、拿用户权限跑,治理的第一性问题不是「策略写得对不对」,而是「这件事发生的时候你在不在场」。而 Agent Detector 论文里那个「DNS 缓存 1–5 分钟」的归因窗口,恰好说明这个「在场」有多脆弱。
4. 股权端压估值、债权端抬成本,两条线第一次同向收紧
Anthropic 把价格区间从传闻的 $70–80 收到 $70–78,非稀释估值约 1.02 万亿,比递表时的 1.5 万亿明显缩水;同一周,美国高收益信用利差创 2025 年 5 月以来新高,数据中心债扎堆的单 B 层扩 35bp,Galaxy Helios 的债从 9.875% 被抛到 13%。一边是「未来增长预期折价」,一边是「当下融资成本抬升」,这在过去两年里很少同时发生——此前通常是估值高、利率低。值得留意的是多数机构给出的时间表高度一致:2027 年的资本开支与发行数字不会大改,压力集中在 2028–2030。也就是说,这轮收紧的杀伤力不在「今年」,而在「续作窗口」——8,954 亿美元的算力承诺能不能在 2028 年之后按原价续上,是比 IPO 定价更硬的问题。
六、有趣的 AI 开源项目
1. expo/exact — 一份 Contract 描述界面,同一份代码跑 Web / macOS / iOS / Linux,且「agent 能自己验」
2,213★ / Rust / MIT / 2026-11-02 创建 / 11-11 01:53Z 推送 / 48 forks / 90 个 11-10 起的提交。来自 Expo 团队,自述是「cross-platform application runtime」,但它的三个设计原则比跨端本身更值得看,因为它把「给 agent 写代码」当作前提而不是附加能力。
做法:界面用一个小型声明式语言 Contract 描述,数据逻辑用 TypeScript 或 Rust 写;Contract 编译器把界面编成一份紧凑的 plan(表 + 字节码)。Web 上这份 plan 变成一个约 20 KB 运行时驱动的 ES module,直接用浏览器自己的 DOM 与 CSS;macOS / iOS / Linux 上由一个 Rust runner 执行同一个 plan,Rust 布局内核按 CSS 规则算每一个盒子(打了补丁的 Taffy),再由各平台自己画——AppKit、UIKit、或 GPU / CPU painter。没有 webview、UI 层没有 JS 桥、首帧前不执行任何 App JavaScript。
三个原则里最硬的是第一条「agent native」:给 agent 的操作只有十个(tree · screenshot · tap · type · state · layout · logs · clock · prefer · perf),四个 host 上完全一致,统一走 scripts/agent.mjs;作者特意解释了为什么是十个——「前代产品的 agent API 在一次一次合理的追加里长到了 80 个 线上名字」。第二个细节更聪明:时钟归 agent 所有,两次操作之间什么都不会动,agent 不说「睡到动画结束」,而是说 clock +60000 或 clock settle 然后读结果,从根上消掉了时序抖动。测试就是这些操作组成的脚本,一个 app.test.contract 在任何 host 上原样跑,不需要第二个 evaluator。
性能预算写在 rules/RULES.md 里并按提交追踪,回归是带人名的 P0:冷启动到可交互首帧 100 ms p50、改一行到看见 100 ms p50、首帧前执行的 App JS 为零、改动一行只重建那个 crate 30 s、整套阻塞检查 65 s。README 里还给了一个可复现的 agent 实测:一个全新 agent 在干净 clone 上按提示词做完一个 todo 应用、在 web / macOS / iOS 三个平台跑通测试,约 57 分钟,其中约 25 分钟是首次 macOS 与 iOS 构建(各约 13 分钟),后续构建一两分钟。
需要留的限定作者自己写得很清楚:pre-1.0、每天在变、无 API 稳定性、无向后兼容、无迁移指南,这是设计而非疏漏;而且这个仓库 exact2 是对更早的 exact1 的重建。当前四端跑通的那个「真应用」是 Caltrain 通勤 app,不是通用结论。
来源:GitHub · https://github.com/expo/exact · 2026-11-11
2. livliv-dev/player — 30KB 的网页 2.5D 角色播放器,唇形同步与摄像头面部追踪都在浏览器里
1,462★ / TypeScript / Apache-2.0 / 2026-11-04 创建 / 11-09 推送 / 153 forks。定位很明确:给网页、直播 overlay、应用放一个会呼吸、会眨眼、会转头、会说话的角色,几行代码搞定。
技术上最值得记的是体积与依赖策略:WebGL2、零依赖、核心约 30 KB gzip;唇形同步(麦克风 / 音频 / 视频)与摄像头面部追踪(MediaPipe)都在浏览器内,并且只在你用到时才加载。同一个 API 能播 LivLiv、VRM、PNGTuber 三种角色,随仓库带 21 个现成角色(带右下角小水印,且明确说明这些角色不在开源许可范围内)。
API 设计得挺克制:new Player(canvas) → load('characters/k01/') → setExpression('smile') / act('nod') / params.mouthOpen = 0.6;需要 VRM 就换 VrmBody,PNGTuber 换 PngBody,同一个 BodyPlayer。格式侧有 FORMAT.md 与 schema/ 下的 JSON Schema,v4 之前的包也仍能播。
来源:GitHub · https://github.com/livliv-dev/player · 2026-11-09
3. WoYun520/gif-factory — 把「做 GIF」拆成风格定义文件的 Skill 合集
1,090★ / Python / MIT / 2026-11-05 创建 / 11-10 推送 / 134 forks。自述是「按风格制作像素、人物与宠物、粘土吉祥物、光栅卡与动态海报的 GIF Skill」。
选它是因为它的组织方式本身就是一种主张:6 个 GIF 分类、10 个风格入口、75 个动态案例,每个风格不是一段提示词,而是一个 styles/<风格名>/STYLE.md 文件——把「这个风格长什么样、怎么复现」写成可被 agent 读取的规范;再加 SKILL.md 定义触发与流程、GALLERY.md 做作品库索引。整套东西的结构跟一份前端组件库的文档结构几乎一样,只不过组件换成了动效风格。
这种「风格即文件」的做法有一个明确的好处:风格可以被 diff、被替换、被组合,而不是散落在几十条提示词里。局限也明显——它依赖出图模型的具体行为,换模型就需要重写 STYLE.md。
来源:GitHub · https://github.com/WoYun520/gif-factory · 2026-11-10
⚠️ 待核实
| 项 | 不确定点 |
|---|---|
| Anthropic IPO 的上市日期 | 官方 roadshow 公告未给交易日期;「11-18 定价 / 11-19 交易」来自路透与 CNBC 引述知情人士,非公司公告 |
| Anthropic IPO 的 1.02 万亿 / 1.405 万亿 | 均为路透按招股书流通股数计算,非公司披露的正式估值口径;私募配售 260 亿的七家分配额也来自招股书更新与媒体报道交叉,官方公告未列 |
| Carbon 的「成本不到次优外部模型一半」 | Google 自述,未给各模型的每任务成本明细与 token 用量;MKA 榜为与 Artificial Analysis 共建,非纯第三方 |
| Carbon 的 Gray Swan / Trajectory Labs 数字 | 为合作方测试口径,未公布测试集规模与采样方法;「IPI 0%」被官方同段限定为「某些分布上仍可被攻破」 |
| AlphaProof Code 的「首次」表述 | Google 与 Signal CTO 的双方口径,无第三方复现;「四周 vs 数年」未给出具体对照项目 |
| LongCat-2.5 的「+86%」 | 厂商自测,基线为 DDP、任务为长序列 SFT、硬件为「单卡不足 80GB 的国产加速器」但未指明具体型号;「下游任务表现与量化前相当」亦为官方口径 |
| HotPhysics 与 GR00T 之外的另一批机器人数字 | Gemini Robotics 2.5 的「+30%~100%」按任务类型给出区间而未给逐任务明细;奔驰产线 96% 为概念验证(proof-of-concept),非量产统计 |
| Mercor 的「推理支出是薪资 3 倍」 | 公司自述,未披露分母口径与统计区间;由此推出的「五年两位数 GDP 增长」是把单一极端样本外推,不可当预测引用 |
| Path Robotics 的「ARR 增长 17 倍」 | 未披露起止绝对 ARR,因此无法换算营收规模;HII 的 6 亿美元是履约型协议金额,不是已确认收入 |
| Modern Web Guidance 的「203 指南 / 250 特性」 | 官方 release notes 口径,未公开逐条清单与 eval 方法;eval dashboard 已上线但本期未逐项核对 |
| Gemini for healthcare / Gemini 关联 Gmail·Drive 人工审核 | 一手页面不可达(cloud.google.com、support.google.com 直连返回 000),仅有二手转述,本期不收 |
本期淘汰记录
| 类型 | 条数 | 明细 |
|---|---|---|
| 脚本判 DUP | 6(1 条翻案收录 / 5 条维持淘汰) | 翻案:llama.cpp b12262——强键 b12262 命中索引 L810(记 b12212–b12240),回溯 release 页确认两区间仅重叠 b12238–b12240 三个构建、其余 17 个为 11-10 新增,判为实质增量,改写为 b12241–b12262 区间收录,正文说明重叠范围。维持淘汰 5 条(均在第一轮被强键命中,见 token 账):Claude Fable 5.2 / Mythos 5.2(L789,11-09 已记全价格与护栏)、Meta Muse Ember(L790,11-09)、字节 Seedream 5.5(L793,11-09)、Google TPU 8tx / 8i Max(L791,11-09)、OpenAI Control Room(L792,11-09)——五条均为前一日刚收录、本期无新事实 |
| REVIEW 复核后收录(独立成条) | 9 | ① Anthropic IPO 路演——L795 记的是彭博 11-09 的「最快 11-10 启动」,本次拿到官方公告 + 确定价格区间 $70–78,按增量写;② Gemini 4 Carbon——L523 记 10-28 发布,本次是全面开放 + 定价截止日 + 三个第三方榜,按增量写并标注首报日;③ Gemini Robotics 2.5——索引 0 命中该型号,弱键仅命中 Google 实体;④ Claude Whiteboards / Sheets / Data——索引 0 命中三项功能;⑤ Businesses in ChatGPT——索引 0 命中;⑥ OpenAI 自由职业研究——索引 0 命中;⑦ NVIDIA OpenShell 捐 CNCF——L26/L38 记的是 10-04/10-05 的 OpenShell 星数与 Open Agent Safety Platform,本次是治理结构变更(捐给 CNCF)+ 三件套发布,按增量写;⑧ Mercor D 轮——L291 记 10-16 的 Benchmark Map 研究,属不同事件;⑨ Reuters 微软光模块——索引仅在 L221 出现「光模块」(NVIDIA × Cisco 的 USFP),与中国进口禁令无关 |
| REVIEW 复核后降级合并(收但不单列) | 2 | ① Claude Code v2.1.322——只有一行变更;② Ollama v0.40.17-rc0——预发布。两条合成一节「两个发版小注」,各自保留关键变动(Vertex 三 region fast mode 与回落策略、MLX 并发生成与 Vulkan 集显 mmap),但不占独立条目 |
| REVIEW 复核后淘汰 | 3 | ① Anthropic 燃气轮机(34 亿美元 / 1.7GW)——索引 L770 已于 11-08 记录同一事件(含具体供应商与订单来源),本次 TechCrunch 11-09 报道无新增事实、无新数字;② Gemini Intelligence 11 月更新——curl 取得的官方页 200 / 368KB,但正文只有一段「Gemini Intelligence 现已支持更多设备,包括 motorola signature 27 与 Pixel 10」,无「提示词生成小组件」的实质内容,二手转述无法回溯,按「无实质内容发布」剔除;③ Gemini for healthcare——cloud.google.com 直连 000、无一手页面,转入待核实 |
| NEW 判定但未收录 | 6 | 前 4 条为板块容量与相关度排序后主动让位(非质量问题):2611.12386 Say Shibboleth(模型与 harness 指纹识别)、2611.12293 Depth Portfolio Allocation(递归深度作为候选源)、2611.12604 Double Blind Evals(H100 机密计算里跑安全审计,趋势三引用了其结论但未单列)、2611.12869 Platonic Representation Hypothesis 逐层定位;后 2 条为时效违规,回溯 abs 页确认为窗口外提交:2611.07962 TCSExam(Submitted on 5 Nov 2026)、2611.09501 e-means(Submitted on 6 Nov 2026) |
| 语义兜底淘汰 | 1 | Astral 加入 OpenAI——curl astral.sh/blog/openai 取得页面日期为 March 19, 2026(2026-03-19),二手媒体标注的 11-10 属时效误标(事件本身真实,但发生在八个月前),按发布日期早于窗口起点剔除 |
| 语义兜底核查(未淘汰) | 2 | ① llama.cpp 与索引 L810:区间重叠仅 3 个构建,正文明确写出重叠范围,避免读者以为是全新区间;② LongCat-2.5 与索引 L663:L663 记 11-03 的发布与规格,本次是开源权重 + MIT 协议 + W4A4/FSDP 工程路径,按「更新(首报 11-03)」写增量 |
| 白名单检索但窗口内无内容 | 3 | vLLM 最新 v0.33.0rc3(11-02)、SGLang 最新 v0.5.23(11-02)、Transformers 最新 v5.22.2(11-06)——窗口内均无新 release,不做凑数条目 |
| 独立发现通道(不在候选清单内) | 3 | 第六节三个开源项目 expo/exact、livliv-dev/player、WoYun520/gif-factory 由 GitHub Search API 按「近 7 天新建 + 400★ 以上」检索得到,未经脚本预筛。voyager-so/vork 被剔除:索引 L759 已记 11-05 版本(970★),本次 1,357★ + 2,500 token API 属同一项目的量变,无性质变化,按「无实质新进展」不写增量 |
token 账:全量索引 807 条数据行(文件 814 行)/ 218,534 字符 ≈ 80,939 token(--audit 报问题 2 处——L77、L87 列数为 7,容错解析可读,未超 10 行门槛,未阻塞)。第一轮 35 条候选 → DUP 5 / REVIEW 16 / NEW 14;回溯一手源、剔除时效违规与不可达项后,第二轮 33 条候选(全部换成已验证的一手 URL)→ DUP 1 / REVIEW 14 / NEW 18,以第二轮为准。预筛后需读 16,806 字符 ≈ 6,224 token,压缩 13.0×。回写后索引为 833 条数据行(回写前 807 条 + 本期 26 条,全部写入、零跳过;此前口径误把文件总行数 814 当数据行数),含「更新至」标记 62 行。
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止 |
|---|---|---|---|---|---|---|
| 1 | 一 | Gemini 4 Carbon is now available | https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ | 2026-11-10 | 2026-11-10(引导价 $2/$10 至 11-30,之后 $4/$20;MKA 榜为与 Artificial Analysis 共建;Project Fortify 为内部基准) | |
| 2 | 一 | Gemini Robotics 2.5 accelerates real-world general dexterity | Google DeepMind | https://deepmind.google/blog/gemini-robotics-2-5-accelerates-real-world-physical-intelligence/ | 2026-11-10 | 2026-11-10(200+ 任务、奔驰两厂为 proof-of-concept;ASIMOV-Jailbreak 已开源) |
| 3 | 一 | Introducing AlphaProof Code | Google DeepMind | https://deepmind.google/blog/introducing-alphaproof-code/ | 2026-11-10 | 2026-11-10(600 万行 Lean、人工复核 1%、四周;「首次」为 Google 与 Signal 双方口径) |
| 4 | 一 | 美团 LongCat-2.5 正式开源:从看见,到抵达 | 美团技术团队 | https://tech.meituan.com/2026/11/10/Meituan-LongCat-2.5-Open-Source.html | 2026-11-10 | 2026-11-10(+86% 为厂商自测,基线 DDP、长序列 SFT;国产加速器未指明型号) |
| 5 | 一 | Claude Whiteboards, Sheets, Data | Anthropic | https://claude.com/resources/articles/sheets-whiteboards-data | 2026-11-10 | 2026-11-10(Enterprise 默认关闭 Whiteboards/Sheets;Claude Data 11-19 默认开启) |
| 6 | 一 | Introducing Businesses in ChatGPT | OpenAI | https://openai.com/index/businesses-chatgpt/ | 2026-11-10 | 2026-11-10(beta;Business Agent 仅美国;未披露定价;1.2 billion 周活) |
| 7 | 二 | NVIDIA Expands Open Source Commitment With OpenShell Donation | NVIDIA | https://blogs.nvidia.com/blog/open-source-openshell-infrastructure/ | 2026-11-10 | 2026-11-10(Crusoe 8 分钟→31 秒、Saturn Cloud 2–8.5 分钟→6–34 秒,均在 HGX B300 自测) |
| 8 | 二 | llama.cpp b12241–b12262 | ggml-org | https://github.com/ggml-org/llama.cpp/releases/tag/b12262 | 2026-11-10 | 2026-11-10 23:04Z(当日 20 个构建,b12238 00:23Z → b12262 23:04Z;与索引 L810 的 b12212–b12240 重叠 b12238–b12240 三个) |
| 9 | 二 | Claude Code v2.1.322 | Anthropic | https://github.com/anthropics/claude-code/releases/tag/v2.1.322 | 2026-11-10 | 2026-11-10T02:29Z |
| 10 | 二 | Ollama v0.40.17-rc0 | Ollama | https://github.com/ollama/ollama/releases/tag/v0.40.17-rc0 | 2026-11-10 | 2026-11-10T22:25Z(预发布,内置 llama.cpp b12257) |
| 11 | 二 | Modern Web Guidance v1.0.0 | GoogleChrome | https://github.com/GoogleChrome/modern-web-guidance/releases/tag/v1.0.0 | 2026-11-10 | 2026-11-10T03:24Z(3,249★ / Apache-2.0 / 2026-03-23 建仓) |
| 12 | 二 | Exclusive: Microsoft presses Trump to scuttle expected ban on Chinese data center technology | Reuters(经 AOL 全文转载) | https://www.aol.com/articles/exclusive-microsoft-presses-trump-scuttle-110129000.html | 2026-11-10 | 2026-11-10(三名知情人士;3.2 Tbps 门槛为摩根士丹利 10 月客户纪要口径) |
| 13 | 三 | Anthropic launches roadshow for proposed initial public offering | Anthropic | https://www.anthropic.com/news/roadshow-launch | 2026-11-10 | 2026-11-10(官方仅给发行条款;估值、私募、财务来自招股书与路透计算) |
| 14 | 三 | Anthropic targets US$1 trillion IPO valuation | Reuters / The Straits Times | https://www.straitstimes.com/business/anthropic-targets-us1-trillion-ipo-valuation-in-test-of-wall-streets-ai-fervor | 2026-11-10 | 2026-11-10(1.02 万亿非稀释 / 1.405 万亿完全稀释为路透计算;Q3 营收 169.56 亿美元) |
| 15 | 三 | Analysis: AI debt faces pressure as Democrats prepare to take over Congress | Reuters(经 US News 全文转载) | https://www.usnews.com/news/politics/articles/2026-11-10/analysis-ai-debt-faces-pressure-as-democrats-prepare-to-take-over-congress | 2026-11-10 | 2026-11-10(利差为上周四/五数据;Galaxy Helios 为 11-05 报价) |
| 16 | 三 | Organizing human intelligence for the entire economy(Series D) | Mercor | https://www.mercor.com/blog/series-d | 2026-11-10 | 2026-11-10(推理/薪资 3 倍为公司自述,未披露口径) |
| 17 | 三 | Path Robotics Announces $300 Million Series E | Path Robotics | https://www.path-robotics.com/news/path-robotics-announces-300-million-series-e-led-by-georgian | 2026-11-10 | 2026-11-10(ARR 17 倍未披露绝对值;HII 6 亿为履约型协议) |
| 18 | 三 | Work at the Frontier: AI's effect on freelance work | OpenAI | https://openai.com/index/ai-effect-on-freelance-work/ | 2026-11-10 | 2026-06(ChatGPT 数据截止)/ 2026 H1(Upwork 快照)/ 2026-04(预算工时) |
| 19 | 四 | Prune, Don't Merge: Expert Compression of MoE LLMs | arXiv | https://arxiv.org/abs/2611.12240 | 2026-11-09 | 2026-11-09(预印本;5 个生产任务、2 个 30B 模型) |
| 20 | 四 | What the Loss Curve Misses: FP4 Pretraining Slows the Acquisition of Rare Facts | arXiv | https://arxiv.org/abs/2611.12832 | 2026-11-09 | 2026-11-09(预印本;作者自测) |
| 21 | 四 | Detecting Shadow AI: Unsanctioned LLM Agents on Enterprise Endpoints | arXiv | https://arxiv.org/abs/2611.12377 | 2026-11-09 | 2026-11-09(12 合成 agent 台架,作者自陈规模不足) |
| 22 | 四 | How Well Does AI Peer Review Work? A Benchmark Built from 100 Planted Errors | arXiv | https://arxiv.org/abs/2611.12820 | 2026-11-09 | 2026-11-09(误报未测;错误分布与真实论文的对应未知) |
| 23 | 四 | DForkTree: Accelerating Speculative Decoding with Fork-Aware Block Diffusion Draft Trees | arXiv | https://arxiv.org/abs/2611.12356 | 2026-11-09 | 2026-11-09(Qwen3.5-4B / 9B,作者自测) |
| 24 | 四 | Phrase-Level Speculative Decoding on a Frozen Target | arXiv | https://arxiv.org/abs/2611.12464 | 2026-11-09 | 2026-11-09(单张 A5000、batch 1,作者自测) |
| 25 | 四 | WorkflowArena: Benchmarking Executable Workflow Orchestration | arXiv | https://arxiv.org/abs/2611.12856 | 2026-11-09 | 2026-11-09(145 任务 / 8 领域 / 9 模型) |
| 26 | 六 | expo/exact | GitHub | https://github.com/expo/exact | 2026-11-11 | 2026-11-11 01:53Z(2,213★ / MIT / Rust;性能预算与 57 分钟 agent 实测均为作者口径) |
| 27 | 六 | livliv-dev/player | GitHub | https://github.com/livliv-dev/player | 2026-11-09 | 2026-11-09(1,462★ / Apache-2.0;21 个角色不在开源许可内) |
| 28 | 六 | WoYun520/gif-factory | GitHub | https://github.com/WoYun520/gif-factory | 2026-11-10 | 2026-11-10(1,090★ / MIT / Python) |
引用提醒:第 1 条的三个「第 1」来自 CursorBench 4.0、Perplexity WANDR、Zapier AutomationBench 三个独立第三方榜,而 MKA 是与 Artificial Analysis 共建的新榜且 Carbon 只排第 2——引用时不可把四个榜并列成「四榜第一」;「每任务成本不到次优外部模型一半」是 Google 自述,未给逐项成本明细;引导价 $2/$10 只到 2026-11-30,之后翻倍至 $4/$20,且官方脚注限定「仅适用于面向公众的 Carbon 模型」,Fairwind 侧不在其内。第 2 条的 96% 是概念验证(奔驰两厂、Apollo 2、汽车配货单一任务),不是量产良率;「+30%~100%」按任务类型给区间,未给逐任务明细。第 3 条的「首次」为 Google 与 Signal CTO 的双方口径,「四周 vs 数年」未给对照项目名,且尚无第三方复现。第 4 条的 +86% 是厂商自测、基线 DDP、任务为长序列 SFT,「国产加速器」未指明型号;「下游表现与量化前相当」亦为官方口径。第 7 条的两个秒级数字由 Crusoe 与 Saturn Cloud 各自在 HGX B300 上自测,场景不同(GLM-5.3 就绪 vs vLLM 启动),不可直接相加比较。第 8 条与索引 L810 的 b12212–b12240 重叠 b12238–b12240 三个构建,不是全新区间。第 13 条官方公告不含估值、私募配售、财务数字,这些均来自第 14 条的路透计算与招股书更新,两者不可混引;「11-18 定价 / 11-19 交易」亦非公司公告口径。第 15 条的 348bp / 342bp 是上周四与周五的数据,Galaxy Helios 的 89.25 美分是 11-05 报价,均非 11-10 当日行情。第 16 条的「推理支出是薪资 3 倍」是公司自述、未披露分母口径,由其推出的「五年两位数 GDP 增长」是把极端样本外推,不可当预测。第 17 条的「ARR 增长 17 倍」未披露起止绝对 ARR,HII 的 6 亿美元是履约型协议金额而非已确认收入。第 19–25 条均为预印本、未经同行评审,全部加速比与精度数字为作者自测;第 22 条的误报未测量,第 21 条的检测窗口仅 1–5 分钟、台架规模不足以给检测器排名——引用时请保留这些限定。第 26 条
expo/exact虽是 MIT,但作者明写 pre-1.0、无 API 稳定性与向后兼容,性能预算与 57 分钟实测均为作者口径、单一 Caltrain 应用;第 27 条livliv-dev/player的 21 个角色素材不在 Apache-2.0 许可内,带水印且不可商用;第 28 条gif-factory的「风格即文件」依赖具体出图模型行为,换模型需重写 STYLE.md。