AI DAILY
AI 日报 2026-11-12
一句话结论本期收录 25 条资讯(模型 5 / 工程 4 / 行业 5 / 论文 8)+ 4 条趋势 + 3 个开源项目,共 25 条写入索引,正文合计 32 条。淘汰账:脚本判 DUP 5 条、REVIEW 复核后淘汰 0 条(11 条全收)、语义兜底淘汰 7 条、降级合并 1 条。最值得看的是 Google 的 Gemini Decisions API——不是因为它便宜,而是因为它把「一次前向、输出一堆带置信度的判定」做成了一条独立产品线,并把输出 token 的账单直接归零:$0.10/百万输入、输出不计费、端到端 150–250ms、单请求最多 1,000 个问题、256K 输入,官方口径比 Gemini 3.5 Flash-Lite 走 Interactions API 便宜近 5 倍。这个价格结构的含义是:分类、路由、策略校验这类「不是生成、是判定」的调用,第一次可以按「问题数」而不是「token 数」来做预算。同一天两份财报把另一条线摊开了:OpenAI 三季度营收 100 亿美元(环比 +约 50%)、调整后营业亏损从 101 亿扩到 109 亿,Anthropic 同期营收 170 亿、营业亏损收窄到 5.67 亿;CoreWeave 营收 36.61 亿(+168%)、订单储备 1325 亿,CEO 说 2027 年算力基本售罄、合格需求约为可用容量的 10 倍,甚至上代 Ampere/Hopper 的租金环比还涨了 30%–50%。把三件事放一起:判定类推理在降价、生成类推理还在扩亏损、而支撑两者的物理算力在涨价——这一期真正的新信息,是这三条曲线的斜率第一次同时被公开。技术侧还有一条容易被漏掉的:llama.cpp 一天 30 个构建里,FP8 从模型权重(CUDA OCP FP8)、KV cache(通用 FP8 KV-cache + Vulkan dequant)到测试门控(MUL_MAT src1)三条线同时落地,本地推理的「半精度以下」开始进入默认路径。
AI 日报 2026-11-12
整理日期:2026-11-12 素材来源:白名单一手源(Google 官方博客与 Google DeepMind 博客、阿里云百炼官方文档与 Qwen Code GitHub Release、MiniMax 官方博客、AMD 投资者关系页、IBM 官方 newsroom、CoreWeave 投资者关系页、港交所披露易公告、GitHub Releases API 与仓库本体、arXiv 原始 abs 页、TechCrunch 一手报道),二手中文媒体仅用于发现线索并回溯一手源,逐条见文末附录 可信度提示:统计窗口 2026-11-11 00:00 → 11-12 10:00 HKT(覆盖最近 24–48 小时)。四条口径先说清:① 11-11 是周三,境内厂商集中在上午(北京时间 10:00–11:00 阿里 Qwen4-Max 与 Qwen Code 1.0 双发),美国厂商则落在前一日深夜至当日凌晨(CoreWeave、OpenAI 财报,纽约州 RAISE Act 门户,AMD 6 代 EPYC),llama.cpp 在 11-11 一天推了 30 个构建。② arXiv 本期取到 11-10 的提交批次,逐篇回查
arxiv.org/abs/确认Submitted on 10 Nov 2026,落在窗口内;但 10 篇候选里 2 篇因板块容量让位、未收录,见淘汰记录。③ 本机对多个一手域直连失败:anthropic.com/news与claude.com/resources/articles列表页均无 Claude Meetings 条目(新浪、凤凰转述的 11-10 beta 报道无法回溯到官方博文),governor.ny.gov403、coreweave.com403、openai.com403、huggingface.co000、businesswire.com000、helsing.ai429——凡一手不可达者一律不入正文,转「⚠️ 待核实」或降级。④ 所有厂商自测 benchmark 均显式标注「厂商自测、无独立复现」;财报类数字区分公司公告口径与媒体引述知情人士口径,两者不混引。 配图:文中三张图为自绘(依据下列来源整理),非原文插图。
#AI日报 #模型动态 #推理基础设施 #Agent #论文 #开源项目
一句话结论
本期收录 25 条资讯(模型 5 / 工程 4 / 行业 5 / 论文 8)+ 4 条趋势 + 3 个开源项目,共 25 条写入索引,正文合计 32 条。淘汰账:脚本判 DUP 5 条、REVIEW 复核后淘汰 0 条(11 条全收)、语义兜底淘汰 7 条、降级合并 1 条。最值得看的是 Google 的 Gemini Decisions API——不是因为它便宜,而是因为它把「一次前向、输出一堆带置信度的判定」做成了一条独立产品线,并把输出 token 的账单直接归零:$0.10/百万输入、输出不计费、端到端 150–250ms、单请求最多 1,000 个问题、256K 输入,官方口径比 Gemini 3.5 Flash-Lite 走 Interactions API 便宜近 5 倍。这个价格结构的含义是:分类、路由、策略校验这类「不是生成、是判定」的调用,第一次可以按「问题数」而不是「token 数」来做预算。同一天两份财报把另一条线摊开了:OpenAI 三季度营收 100 亿美元(环比 +约 50%)、调整后营业亏损从 101 亿扩到 109 亿,Anthropic 同期营收 170 亿、营业亏损收窄到 5.67 亿;CoreWeave 营收 36.61 亿(+168%)、订单储备 1325 亿,CEO 说 2027 年算力基本售罄、合格需求约为可用容量的 10 倍,甚至上代 Ampere/Hopper 的租金环比还涨了 30%–50%。把三件事放一起:判定类推理在降价、生成类推理还在扩亏损、而支撑两者的物理算力在涨价——这一期真正的新信息,是这三条曲线的斜率第一次同时被公开。技术侧还有一条容易被漏掉的:llama.cpp 一天 30 个构建里,FP8 从模型权重(CUDA OCP FP8)、KV cache(通用 FP8 KV-cache + Vulkan dequant)到测试门控(MUL_MAT src1)三条线同时落地,本地推理的「半精度以下」开始进入默认路径。
一、模型与产品
1. Gemini Decisions API:把「判定」从生成里拆出来,输出 token 直接不计费
11-11 发布。这是本期定价结构上最值得抄的一条,因为它改的不是模型能力,是计费单位。
规格:模型 ID gemini-decision-1,$0.10 / 百万输入 token,输出 token 不计费。端到端延迟 150–250ms,模型侧中位 50–100ms(在 16K 上下文档位测得,与 256K 上限是两个口径)。最大输入 256K token,单请求最多 1,000 个独立问题,支持文本、图像、音频、视频、PDF。计费细节里有一条关键:共享的 input 每个请求只算一次,无论你问多少个问题;每个问题只额外计入它自己的指令与判据 token。也就是说,「同一份长文档上问 200 个是非题」的成本,接近「问 1 个」的输入成本加上 200 份短判据。
三种问题类型:noul(原文如此,语义是 Yes/No 二值判断,可给 true/false 两侧的描述性判据)、choice(2–255 个选项,返回获胜项与全部候选的归一化概率)、score(有序 rubric 打分,起始值 0,返回连续加权分与各档概率)。三类可在同一请求里混用,所有答案都带 0–1 置信度——这条是把判定结果接进业务系统的前提:置信度低的可以路由到 fallback 或人工,而不是硬吃一个错答案。
官方给的两个对比:成本上,在共享基准集上比 Gemini 3.5 Flash-Lite + Interactions API 便宜近 5 倍;性能上,覆盖 agent 路由、推理、排序、多模态理解四类基准,「全系列领先、校准误差最低」。但没有给任何具体分数——这一点很重要,见待核实。
内部落地案例比榜单有用:Gemini Notebook 用它做实时路由(按意图分类决定走哪个模型层级、开多深的思考),日常查询延迟降最多 40%;Google Search 把它当 MCP 工具的安全层,在延迟预算内检测对抗性行为;CC(Google Labs)用它从 200+ emoji 里挑一个。可用渠道是 Gemini API / AI Studio(有免费额度层),Google Cloud 与 Vertex 是「coming soon」,SDK 走 google-genai,生态侧正在铺 OpenRouter、LangChain、Vercel AI SDK、LiteLLM、Pydantic AI、Pipecat、LiveKit、OpenCode。
来源:Google · https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/ · 2026-11-11
2. Qwen4-Max 预览版:1M 上下文、默认开思考,但只开 14 天且不按量计费
11-11 10:00(北京时间)上线。模型 ID qwen4-max-preview,规格写得很实、边界也划得很硬。
规格:1M token 上下文,最大输出 393,216 token,且思考过程与最终回答共享这一预算——这是从这一版开始改的口径,沿用旧习惯只给回答留额度会被提前截断。思考默认开启,reasoning_effort 三档 low / medium / xhigh。输入支持文本、图片、视频,输出文本;图片单张最高 1,600 万像素,视频最长 2 小时 / 单文件最大 2GB。支持 Function Calling、联网搜索、JSON Object / JSON Schema 结构化输出,同时兼容 OpenAI Chat Completions / Responses 与 Anthropic Messages 三种接口格式——对已经在 Claude Code、Codex 里跑工作流的团队,改 base_url 与模型名就能对打。
边界:仅 Token Plan 订阅,不支持按量计费;预览窗 11-11 10:00 → 11-25 24:00(UTC+8),期间官方承诺模型行为不做变更(便于拿一致基线),到期模型标识下线、正式版换新名发布。未公布参数量、模型卡、官方跑分、按 token 单价、可下载权重。个人版文档另有限制:套餐主要用于编程与智能体工具的交互式调用,不用于自动化脚本、自建应用后端或非交互式批量任务。
阿里云文档同时把「Qwen4 即将发布」与「本次是预览」分得很清楚,入口包含千问办公、Qoder、千问 App、QwenStudio。
来源:阿里云百炼 · https://help.aliyun.com/zh/model-studio/newly-released-models · 2026-11-11
3. MiniMax H3-Image:4K 十秒、开放权重,亮点是「没有单点突破」
11-11 发布,H3 的衍生图像模型,支持文生图、参考生成与图像编辑。
核心数字:4096×4096 单图 10 秒内,最多 16 张参考图,官方称 4K 生成速度最高为主流方案 5×;分模式看,Standard 是主流方案的 1.5–2×、Highspeed 3–4×(注意这两个倍数和「5×」不是同一个口径,5× 指 4K 满分辨率场景)。定价为主流同类产品的 50%–70%,首发周 4K 及以上请求半价。权重随 H3 一同开放,渠道为 MiniMax API Platform、MiniMax Code 与 Hailuo AI。
最值得引的一句是官方自己的归因:「No single change made the difference」——提升分散在数据、强化学习、采样步数压缩、PE 与部署优化的整条 post-training 流水线上。这句话比任何单一数字都更能说明当前开源图像模型追上闭源的方式:不是靠一个架构创新,是靠一整条工程链同时拧紧。博文未给参数量(此前流传的 331 亿 / 50 层 DiT 说法在本期一手源中无法核实,见待核实)。
来源:MiniMax · https://www.minimax.io/blog/minimax-h3-image · 2026-11-11
4. AlphaGenome 2:从「一次预测几千个实验」改成「一次只预测一种细胞」
11-11 发布(Google DeepMind Science 栏目,作者含 Pushmeet Kohli、Žiga Avsec)。这是本期方法论变化最大的一条。
改的是什么:第一代是「输入 100 万字母 DNA,并行输出数千个 bulk 组织与细胞系的预测」——高效,但模型容量被摊薄,分不清亲缘很近的细胞类型。第二代改成条件模型:一次只预测一个 condition(组织 / 细胞类型 / 细胞状态),条件信息在架构的每一层与 DNA 序列共同输入。条件来源两种:从参考细胞类型目录里选,或用细胞编码器从科学家自己的单细胞实验即时生成。
数据与成绩:训练用 1.07 亿+ 单细胞图谱、68 个组织、人 + 小鼠。TenK10K 数据集(28 种原代免疫细胞)上,因果变异识别 30% vs 一代微调后的 16%,方向性基因效应 43% vs 23%——「接近两倍」。新增 DNA 甲基化输出(此前呼声最高的缺失模态),并支持跨模态补全:只输入一种测量(如单细胞基因活性)就能预测未测的性质(如染色质可及性),用来决定下一步该做哪个实验。零重训泛化:几十个细胞的 scRNA-seq 快照即可条件化,性能可匹配或超过在该数据集上直接微调的模型。
两个案例比分数更有说服力:复现了一项 Nature 研究的结论——远端调控开关上的变异通过在肠道巨噬细胞中过度激活 ETS2 导致 IBD——AG2 在计算上单独挑出了该因果变异,并显示它选择性作用于肠道巨噬细胞中的 ETS2;另一个是在未见的 mRNA 疫苗单细胞数据上区分疫苗激活与静息 T 细胞,并发现重症相关变异在激活状态下破坏更强,这个效应在未激活细胞里会被漏掉。
可用性:非商业研究经 AlphaGenome API 即日可用,商业用途仅私有预览;官方明示「仅研究用途,未经验证或批准用于临床或诊断」。Antigravity 上的 AlphaGenome 2 Skills 即将上线。
来源:Google DeepMind · https://deepmind.google/blog/alphagenome-2-deciphering-how-cells-read-dna-to-better-understand-disease/ · 2026-11-11
5. Google Labs Tabletop:@ 一个 agent,让一群人同时改同一张行程表
11-11 发布(Roman Nurik 撰文)。这是本期最不像「模型发布」的一条,但它指向的产品形态值得记。
怎么用:把链接、文件、想法放进一个共享空间,然后 @tabletop 或选一个起始模板,生成可交互的工具——旅行行程表、聚餐投票、费用分摊器、锦标赛对阵图,官方举例还包括互动公路地图、晚餐决定轮盘、pickleball 对阵板、拖放式座位表。空间建好后把邀请链接丢进群聊,所有人同时进去编辑,官方自己用的类比是「像 Google Docs 一样」。生成物可以继续用提示词改。
边界很清楚:仅美国、18 岁以上、候补名单(labs.google/tabletop),Google 称每周放一批。未披露底层模型(既没说 Gemini,也没说规则/模板驱动)、未披露定价、未披露单空间人数上限与是否支持美国以外。
值得记的判断:这条的意义不在「AI 又能做表格了」,而在把 agent 的调用点从「一个人对一份产出」挪到了「一群人对一个共享对象」——多用户同时改同一份 AI 生成物,会立刻暴露一个此前没被认真解决的问题:agent 的中间状态属于谁、冲突怎么合并。Tabletop 现在靠「像 Docs」这个类比绕过去了,但这个问题没有消失。
来源:Google · https://blog.google/innovation-and-ai/models-and-research/google-labs/tabletop/ · 2026-11-11
二、工程与架构
1. llama.cpp b12263–b12292:一天 30 个构建,FP8 三条线同时落地
11-11 单日 30 个构建(01:26Z → 20:15Z),与索引 L822 记的 b12238–b12262 无重叠。这一天的主线是 FP8 从三个不同的层面同时进入默认路径:
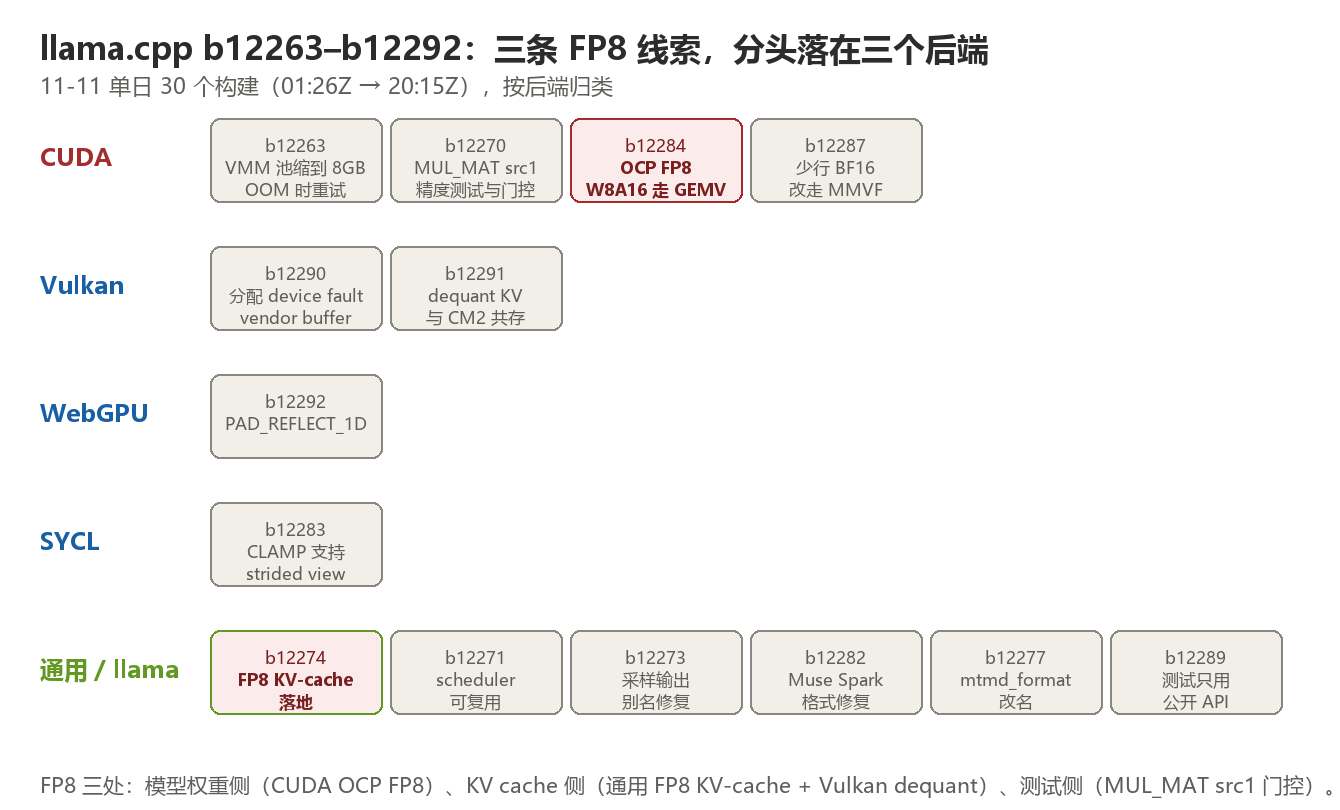
KV cache 侧:b12274 通用 FP8 KV-cache 支持(#28392)——加了带 scale 的 FP8 KV cache 与对应 test-backend-ops 用例,修了 get_*_scale 映射与 rope shift 前的反量化顺序,把 cache-scale 命名与投影布局解耦(官方注释:融合 KQV 对非共享 scale 暂不实用,但这是为将来铺路),并让 Gemma 4 Assistant 通过存取值指针支持 FP8;E2E 用例从 ggml 后端测试移到 test-llama-archs(因为已不只是后端算子的事)。
模型权重侧:b12284 CUDA OCP FP8 支持(#28413)——用 fp8 intrinsics,GEMV 场景走 W8A16;release notes 里带了 RTX PRO 4500 Blackwell 上 Qwen3.6-27B-NVFP4 的实测表(pp8196 约 2,781 t/s 量级)。
测试与门控侧:b12270 给 MUL_MAT src1 加精度测试并门控(#31896)——这条最容易被当成杂项跳过,但它是前两条能安全合入的前提:量化路径一旦在 src1 上掉精度,需要一道能拦住它的门。
Vulkan:b12291 允许 dequantized KV 优化与 CM2 共存(#31526),用「query token × GQA 比」做启发式守卫;同一 PR 里顺带修了一个会静默拖慢性能的 bug——某些 head size 被误判为未对齐,修正后即使 dequant 优化不生效也有加速。
其余值得记的:b12287 少行 BF16 矩阵在 batch 2–8 时改走 MMVF(MF 每块 32 行,320 行 × K=10240 的 qwen4exp 超连接投影只跑几个 block、大部分 SM 空闲;MMVF 一行一块,条件为 rows × ne11 × 256 ≤ nsm × min(K, max_k) 且 K ≥ 1024,Blackwell 最多 8 列 / max_k 6144);b12271 后端 scheduler 在 sched_params 兼容时复用(#32009);b12273 修采样输出别名(#32015);b12263 CUDA VMM 池缩到 8GB 并在 OOM 时重试(#30542),只对 CUDA_ERROR_OUT_OF_MEMORY 缩池、缩到小于 max size 时打警告;b12282 修 Muse Spark 忽略 response_format 的 json_schema(#32017);b12290 Vulkan 分配 device fault vendor binary buffer(#32008);b12292 WebGPU 加 PAD_REFLECT_1D(#31877);b12283 SYCL CLAMP 改走 unary 助手以真正支持 strided view(#31784);b12277 mtmd_format 改名(#32040);b12289 测试只用公开 ggml API(#32077)。
来源:GitHub · https://github.com/ggml-org/llama.cpp/releases/tag/b12292 · 2026-11-11
2. Qwen Code 1.0 Preview:把 Qoder 的 Harness 开源,并且改成事件驱动
11-11T03:55Z 发 v1.0.0-preview。这条实为工程架构变更,不是模型更新,所以放在本节。
做了什么:把 Qoder 里打磨的 Agent Harness 能力并入 Qwen Code 的同一套开源内核。核心改动是执行组织从「入口各自跑循环」改成「统一事件机制」——用户输入、工具结果、系统反馈先经适配器转成事件,按会话标识路由;会话结合当前状态决定下一步(发起模型调用或工具执行),结果再以事件回写。官方给的概念对照是:会话从「一段贯穿任务的执行循环」变成「由事件持续推进的状态」。Agentic Loop(推理 → 工具 → 验证)仍然存在,变的是谁驱动这个闭环。
为什么要这么改:官方点得很直——当 IM、流水线等系统接进来,agent 面对的不再是用户逐条发起的请求,而是持续到来的任务与反馈,吞吐与资源开销成为硬约束。于是从进程内内存事件总线起步,向分布式演进:接入、调度、执行分层,用**「手脑分离」**让推理编排与工具执行独立管理,从「一个进程、多个会话」走向「多个节点、更多会话」。这件事和 Codex 的 AppServer 架构是同一条思路,官方原文也直接拿来对照。
其他工程要点:提供 macOS / Linux / Windows 原生二进制,不需要单独装 Node.js;支持会话恢复与非交互式(headless)运行,可接 Git hook、CI/CD 与后台任务;支持 Qwen 与 Qoder 双账号、多模型提供商、自定义兼容端点。官方明示处于 Preview,部分接口与行为仍会调整;1.0 以独立分支开放,现有稳定分支保留。
来源:GitHub · https://github.com/QwenLM/qwen-code/releases/tag/v1.0.0-preview · 2026-11-11
3. AMD 第 6 代 EPYC:第一次按「agent 的三种 CPU 角色」分档卖 CPU
11-10(美东)宣布 SP7 平台正式上市,基于 Zen 6。这条在 AI 语境下的意义不是跑分,是产品分档逻辑变了。
官方给的框架:agentic AI 基础设施里 CPU 有三个不同角色——通用服务、GPU 宿主节点、agent 沙箱,三个角色的密度、频率、带宽、能效要求各不相同,所以不再用「一颗通吃」的 CPU 去覆盖。为此拆出三类优化款:
| 角色 | 官方口径 | 对手基线 |
|---|---|---|
| 通用服务(EPYC 9996) | 整机性能 3.7× Vera 系统;对 Xeon 6980P 2.2× 性能、2.0× 性能/美元 | NVIDIA Vera、Intel Xeon 6980P |
| GPU 宿主节点(最高 5.3GHz) | LLM 输出吞吐为上代 EPYC 的 1.8× | 上代 EPYC |
| agent 沙箱(高密度) | 每 CPU 瓦可托 agent 数约 3.3× Vera、2.5× Xeon 6980P;同 35kW 机架内 agent 数约 1.18×(默认功耗策略下) | 同上 |
必须标注的口径:以上全部是 AMD 自测,无第三方复现;「per CPU watt 的 agent 数」这类指标对测法极其敏感(agent 定义、并发模型、内存带宽压力都没公开)。可核的部分是:SP7 平台已由各 OEM/ODM 出货,Azure 与 OCI 的云实例「即将上线」,5 代 EPYC 是 AMD 史上爬坡最快、出货量最高的一代。CEO 苏姿丰另称服务器 CPU 需求到 2030 年预计增长 50%、市场规模达 2,000 亿美元(预测,非订单)。
与本期另一条独立线索可以对照看:同一天 AMD 在 OCP 2026 展示了 EPYC「Verano」(Zen 6、最高 192 核、首个上 LPDDR5X/SOCAMM2 的 EPYC、面向 MI500 供数、2027 上市),但该条一手新闻页不可达、核心数与插槽口径在二手来源间互相矛盾,不进正文,见待核实。
来源:AMD · https://ir.amd.com/news-events/press-releases/detail/1305/amd-showcases-6th-gen-amd-epyc-processors-to-lead-next-era-of-ai-and-enterprise-computing · 2026-11-10
4. IBM × 微软 Imagine Enterprise:把「数字劳动力」当成一套有编制、有权限、有审计的组织来卖
11-10 发布,双方联合投资、共同开发。这条的价值在于它把企业 agent 的叙事从「工具」推到了「编制」。
分工:IBM Consulting 出 6,000+ agent 与资产(基于 IBM Consulting Advantage,含 Agentic Core / Process Studio / Context Studio)+ 行业蓝图 + 双方前置工程(forward-deployed)团队混编进客户团队;微软出企业底座——Azure AI Foundry、Copilot Studio、Fabric、Microsoft 365、Entra、Purview、Defender、Sentinel。官方一句话概括:「None delivers the full picture independently」。
治理是三层的,不是一句口号:可观测——每个 agent 的动作、决策、升级都留痕,延迟、成本、token 用量、运行历史实时可见;可控——治理控制定义每个 agent 能自主做什么、什么必须人工批准、何时必须升级,且agent 无法绕过既定权限边界;持续改进——运行智能层监控表现并给出改进建议,批准的变更自动重新部署。
样板流程是保险理赔,中枢叫 Digital Steward:赔案进来先分诊(判复杂度、标潜在欺诈信号、核保额覆盖),再按权限等级与案件性质派给合适的理算员——初级拿接近直通的简单案,高级拿覆盖范围有歧义的,多重异常标记的进首席或专案组。落到员工侧的差别是:每天开局就是一份排好序、带上下文的工作量,且告诉他为什么先看这个、已经查过什么、建议下一步做什么。
缺什么:未公布定价、GA 日期、具体客户名与试点结果;「82% 全球商业领袖计划 18 个月内布署数字劳动力」的出处与样本量未说明。
来源:IBM · https://www.ibm.com/new/announcements/the-digital-workforce-why-the-next-competitive-frontier-isn-t-ai-it-s-how-you-operationalize-it · 2026-11-10
三、行业与发展
1. OpenAI 三季度:营收首次破 100 亿,亏损同步扩到 109 亿
11-10 投资者电话会上披露(WSJ 与 Bloomberg 报道,非公司公开发布)。
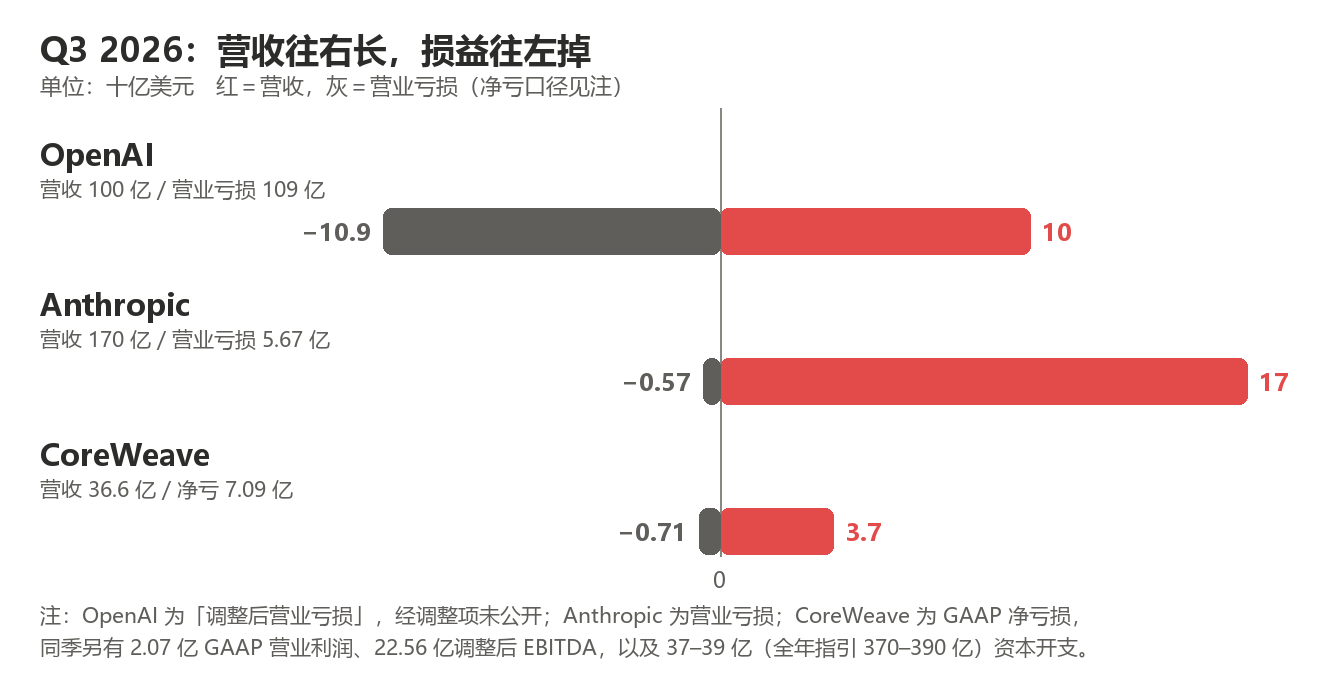
数字:营收约 100 亿美元,环比 +约 50%(Q2 约 67 亿),同比近 3×;截至 9 月底年化约 500 亿。调整后营业亏损从 101 亿扩大到 109 亿,调整后营业利润率从 −150% 改善到 −109%——收入增长快于成本增长,但还没快到让亏损的绝对额下降。企业与消费者业务各贡献约一半,企业侧环比翻倍;付费用户破 1 亿(当季新增约 2,200 万付费、2 亿免费),周活 12 亿,付费渗透约 8.5%。
CFO Sarah Friar 点名三条增长线:Coding、Cyber、Dots(企业 agent 平台);中小企业业务三季度增速「超过此前六个季度总和」。她还给了一个战略判断:此前受微软 Azure 合同框架约束、无法与第三方云做分发合作,Anthropic 把这条路走通了,对 OpenAI 而言 2027 年可成为重要顺风——这句话的潜台词比数字重要:多渠道分发被 OpenAI 自己承认为一项被耽误的能力。
必须分清的账:同期 Anthropic 营收约 170 亿、营业亏损收窄至 5.67 亿,但两家计收口径不同——Anthropic 把云合作伙伴产生的销售额计入营收,OpenAI 只计部分渠道中归属于自身的收入。把 170 与 100 直接横比会得出错误结论。
来源:WSJ · https://www.wsj.com/business/earnings/openai-continues-to-suffer-heavy-losses-as-revenue-rises-to-10-billion-d2a96bbb · 2026-11-10
2. CoreWeave 三季度:营收 +168%,但真正的信息是「旧 GPU 租金涨了」
11-10 盘后发布。这份财报被市场当成「AI 基建还行不行」的测试卷,结果出来后股价次日涨 23%。
数字(公司公告口径):营收 36.61 亿美元(+168%);GAAP 营业利润 2.07 亿;调整后营业利润 3.79 亿、利润率 10%——提前一个季度到两位数(Q1 1% → Q2 5% → Q3 >10%);净亏 7.09 亿(每股 −1.27),调整后每股亏损 0.95(市场预期 1.16);调整后 EBITDA 22.56 亿。收入订单储备 1325 亿(6 月底 1040 亿,季度增约 280 亿)。全年指引上调:营收 130–133 亿(前值 124–132)、调整后营业利润 12.75–13.75 亿(中值较前指引 +26%)、资本开支 370–390 亿(低端从 350 上调,原因是交付比计划更早)、年末 ARR 200–210 亿。Q4 利息支出指引 10.5–11.5 亿。季末债务近 470 亿,加权平均债务成本降至 7.9%。
三条比营收更值得记的:
- 上代 Ampere / Hopper 的租金环比涨 30%–50%,且高于原始合同价,部分设备正签超过会计折旧年限的多年合同。这一条直接反驳了「旧卡会被新卡折旧砸穿」的担忧——至少在当前供需下,旧资产在升值。
- 2027 年已推向市场的算力基本售罄,合格需求约为同期可用容量的 10 倍;2028 年尚未全部投放,但已投放部分都找到了买家。
- 提价是真的:7 月全线提价约 25%,季末再提约 10%。四至五年长约年化约每兆瓦 2,000–2,500 万美元,短约超 4,000 万美元;公司正提高高价短约的算力分配比例来改善利润率。
风险侧:CDS 利差一度破 11%(市场按困境定价)、债券收益率 16% 以上、2027 年资本开支外部估算可能达 660 亿并需再借至少 250 亿。CEO 称未来三个月预计有约 90 亿客户预付与押金,且计划在一两周内再发一笔资产担保债(称高投资级、预期 7%–7.5% 定价)——这条是全部叙事的关键变量:能不能用更便宜的钱续上更贵的建设。
来源:CoreWeave · https://investors.coreweave.com/news/news-details/2026/CoreWeave-Reports-Strong-Third-Quarter-2026-Results/default.aspx · 2026-11-10
3. 纽约 RAISE Act 开放登记:前沿模型第一次有了「合规截止日 + 罚款金额」
11-10,州长 Hochul 宣布 DIGIT(数字创新、治理、诚信与信任办公室,设在金融服务署内)开放 RAISE 门户。这是美国州级 AI 监管从「提案」走到「文书」的一步。
硬约束:年营收超 5 亿美元的大型前沿开发者须在 2027-01-01 前完成登记;明年 1 月起须在官网发布安全框架、关键安全事件 72 小时内上报(州方称全美最严;加州 SB 53 是 15 天)、发布模型透明度报告;自 2027-01-01 起至少每两年提交一次披露声明并缴纳摊派费用;大型开发者另需每季度提交灾难性风险评估。罚款首次 100 万美元、后续 300 万美元,州方可对未登记者采取执法行动(具体机制州发言人拒绝说明)。
同日启动的评估机构:纽约 AI 责任与研究中心(NYCAIRR),设在宾汉姆顿大学,资金为 Tom Secunda 领衔的 3,000 万美元捐赠 + SUNY 2,500 万研究资本投入(Hochul 1 月首次宣布时为 5,500 万),算力来自 Empire AI(5 亿美元公私合营)。80+ 名纽约州研究者参与,Cornell Tech 的 Greg Morrisett 与 Columbia 的 Jeannette Wing 任 interim 联席主任。它的职能是独立评估模型的安全性、安全性与运行,并应州方要求与 DIGIT 一起复核厂商发布的安全框架。
关键限制(必须写进引用):据 Engadget,该中心只能评估 AI 厂商公开提供的材料与数据——未发布的内部前沿模型不在其直接触达范围内。也就是说,这套「州级独立评估」目前评的是披露质量,不是模型本身。这条限制比法案条款更值得关注:它决定了这套制度能不能真的发现问题。
来源:TechCrunch · https://techcrunch.com/2026/11/10/openai-anthropic-face-new-oversight-as-new-yorks-ai-safety-law-takes-effect · 2026-11-10
4. 阿里拟分拆平头哥赴港独立上市:真武系列累计出货 56 万片
11-10 晚公告:已向港交所提交分拆建议,联交所确认可进行;平头哥已于 2026-09-11 以保密形式递交 A1 表格,拟以 H 股在主板上市及买卖;IPO 规模尚未确定,上市后平头哥仍为阿里子公司。
一个可核的硬数字:截至 2026 年 4 月,平头哥真武系列 AI 芯片累计出货 56 万片。官方给的分拆理由两条:让市场更清晰定价阿里保留集团的业务价值;让平头哥独立对接资本市场、吸引半导体与 AI 算力赛道的专业投资者,并支撑其加大研发与人才投入、「提升国产优质算力供给」。
放在序列里看:这是继百度昆仑芯(1 月保密递表,百度中国持股 57.67%)之后,第二家分拆芯片资产独立上市的中国互联网大厂;同期天数智芯、壁仞科技、燧原科技已挂牌,摩尔线程、沐曦也已登陆——国产 AI 芯片的资本化已经从零星个案变成一条流水线。
来源:证券时报 · https://www.stcn.com/article/detail/4330866.html · 2026-11-10
5. 智谱拟回购 H 股,上限 40 亿港元、不超过已发行股份 1%
11-10 港交所自愿公告:接董事长刘德兵提议,拟依 2026-06-22 年度股东会授予的一般授权在公开市场回购 H 股。总额上限 40 亿港元,回购总数不超过公告日已发行股份总数的 1%,两个约束并行。授权有效期至 2026 年度股东会结束或股东特别决议撤销/修订之日(以较早者为准)。
必须原样保留的限定:公告明写这只是意向,回购的时机、数量、价格由董事会按市场情况绝对酌情决定,不保证一定实施,且不得触发强制要约义务、不得使公众持股低于港交所最低比例,需取得必要监管批准。
背景数字(可核):11-10 收盘 482 港元(+11.11%),而 6 月 22 日高点 2,980 港元,回撤超 80%;2026 上半年营收 9.54 亿元(+399.7%)、毛利 2.52 亿(+163.7%)、归母净亏 20.7 亿(收窄 12.1%);截至 8 月末按月度收入年化的 ARR 16 亿美元(周度口径超 20 亿),MaaS 平台 token 调用量较年初增超 40 倍、Coding Plan 调用量增 23 倍、API 平均定价提升 101%。
读法:这是一份「用 1% 股本换信心表态」的公告,量级上不足以改变供需,真正的信息在定价提升 101% 与调用量增 40 倍并存——说明过去一年它在把「卖 token」转成「卖能力档位」,且市场接受了涨价。
来源:港交所披露易 · https://www1.hkexnews.hk/listedco/listconews/sehk/2026/1110/2026111000852_c.pdf · 2026-11-10
四、论文与开源
1. 2611.14051 KV cache 能跨模型版本复用吗:能省时间,但不能替代更新后的模型
11-10 提交。问题问得很直接:模型更新后,旧 cache 还能不能用。
核心发现:cache 能保留有用的任务信息,却不能忠实复现更新后模型的行为。四次更新上检索准确率差异极大,从接近原生性能到大损失都有。源 cache 已在手时,三个长前缀 QA 基准上 TTFT 中位加速 2.10–5.08×——这个数字很有诱惑力,前提是你能接受行为偏差。为了刻画偏差,作者提出 Functional Cache Divergence:比较「复用 cache」与「原生 cache」下的 next-token 分布。
判断:这条的实际用法不是「跨版本复用」,而是「用 FCD 做一道准入检查」——如果某次更新后 FCD 小,复用是纯赚;FCD 大就必须重算。它把「能不能复用」从经验判断变成了可测的开关。
来源:arXiv · https://arxiv.org/abs/2611.14051 · 2026-11-10
2. 2611.14418 Precision on Demand:默认 4 位解码,只在不确定的那一步升到 8 位
11-10 提交。本期的工程美感最好的一篇,机制一句话说清:权重常驻 8 位,平时只读高 4 位参与计算,只有当低精度输出的分布看起来不确定时,才用 8 位把这一步重做一遍。不确定性用两个门控判:熵超阈值,或 top-2 间隔过小。
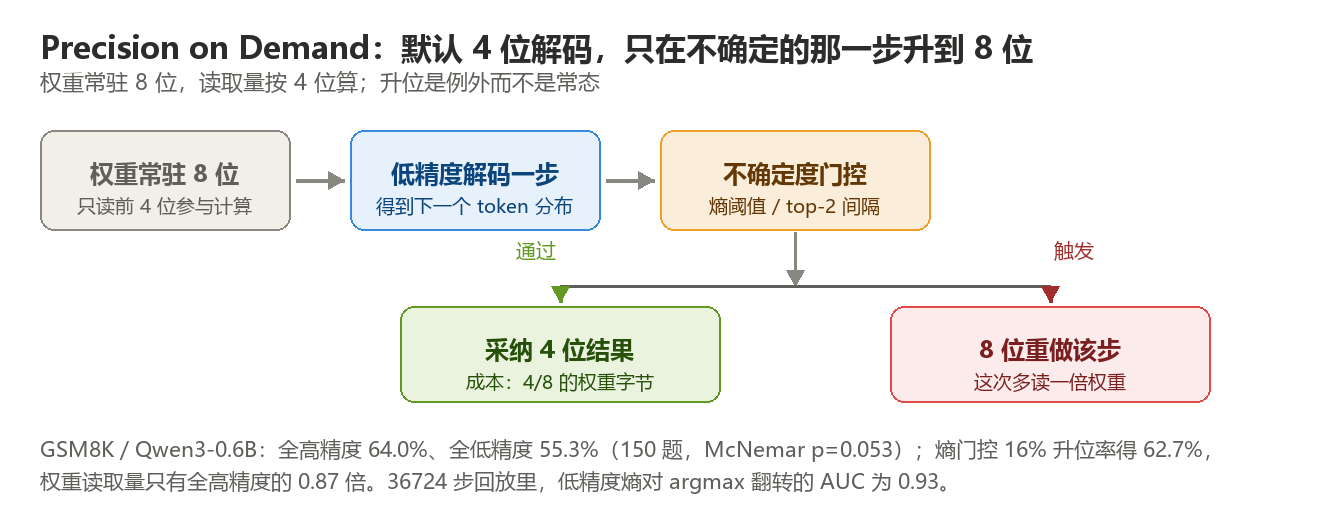
数字:Qwen3-0.6B + GSM8K,量化是模拟的,成本按每 token 读取的权重字节计。36,724 步回放中,低精度熵对 argmax 翻转的 AUC 0.93——说明「熵高 ≈ 会翻」这个假设成立。15% 升位预算下熵门控抓到 78% 的翻转,top-2 间隔门控抓到 94%,而同等预算的随机门控期望只有 15%(作者注明这是计算出的期望值,非实跑)。150 道活题上:全高精度 64.0%、全低精度 55.3%(McNemar p=0.053,即差异未达 0.05 显著水平);熵门控 16% 升位率得 62.7%,权重读取量为全高精度的 0.87×。
判断:提升是「大部分找回、成本小增」,不是「无损省一半」。而且 0.87× 这个数字意味着只省了 13% 的权重流量——离「4 位推理」的宣传口径差得远,因为 8 位权重仍需常驻。真正的价值在机制:它示范了「精度可以是 per-step 的决策变量」,而不是一次性的模型属性。
来源:arXiv · https://arxiv.org/abs/2611.14418 · 2026-11-10
3. 2611.14492 ReTrace:把 SOP agent 蒸馏成「不用规划器」的工作流
11-10 提交。业务自动化的真实痛点是:同一条 SOP 在新输入上反复跑,而 LLM agent 每一步都要调一次 LLM 来决定下一步——规模一上来,延迟和成本都不可接受。
关键观察:agent 每次工具调用附带的 reasoning 才写出了「为什么这么做」,单看工具调用序列看不出来。于是 ReTrace 从「SOP + 少量已记录的 agent 运行」里抽取每一步背后的条件,跨运行合并成一份紧凑的规则文档,再从规则文档生成可执行工作流——由代码而不是 LLM 选下一步。
工程上的巧处:只有最后一步(编译成可执行工作流)依赖具体平台,所以规则文档可以跨编排平台重编译。验证在生产平台的 79 个流程上做。
判断:这是「agent 用完即弃、把知识沉淀成代码」这条路线最干净的一次表述。它和本期 ReTrace 的姊妹问题——什么该进记忆(下一篇 FGSE)——其实是同一件事的两面:前者问「怎么把经验变成流程」,后者问「什么经验值得留」。
来源:arXiv · https://arxiv.org/abs/2611.14492 · 2026-11-10
4. 2611.14326 FGSE:一段经验什么时候才配写进持久记忆
11-10 提交。当前自进化 agent 的通病是:把单次成功直接写成经验,于是「局部成功」被当成「可复用且安全的知识」。
做法:把每条候选教训表示成一个结构化假设——显式的前置条件、行为改变、预期效果、验证器。先在临时状态里试用,然后过三类探针:target-transfer(目标迁移)、falsification(反证)、archived-regression(归档回归),再按实测的增益与风险决定提交、精修还是拒绝。覆盖 web、app、工具使用与长期记忆四类基准。
判断:「先反证再入库」这个顺序是对的,而且它把「可证伪」从科学哲学的修辞变成了工程里的一道 gate——每条经验必须自带一个能证伪它的验证器,否则连候选资格都没有。这是本期最可直接抄进生产流程的一条。
来源:arXiv · https://arxiv.org/abs/2611.14326 · 2026-11-10
5. 2611.14333 AI 没变笨,是用户变挑了:126 万张盲投票给出的分离
11-10 提交。「ChatGPT 越来越差」这个抱怨极常见,通常被归因于模型变差。这篇提出第二个从未被检验的可能:评判的人变了。
方法很干净:在 Chatbot Arena 上只取版本固定的模型对(有日期的厂商快照 + 权重固定的开源模型),这样「模型没变」是可控的。样本是 2023-05 至 2024-08 的 1,260,967 张盲投票。
结果:同一对未变的模型,选择「两个都差」的比例每月上升 1.71 个百分点(均值 17.1%),2024 年为 +1.91pp/月;在 2023 与 2024 都被频繁观察的 14 对模型里,这个比例每一对都上升,从 15.5% 到 23.3%。而排名没有趋势——2024 年强模型在有判定的投票中份额基本持平。
判断:这条的价值是它把「体感变差」和「实际变差」拆成了两个可分别测量的量,并且给出了一个反直觉但重要的结论:绝对标准在抬升,相对排序是稳的。对做产品的人,这意味着用户满意度下降不一定是模型问题,也可能只是「第一个小时的新鲜感定价」结束了。
来源:arXiv · https://arxiv.org/abs/2611.14333 · 2026-11-10
6. 2611.14083 Sable:给「逐位精确推理」出一张可验证的证明
11-10 提交。要证明的命题很硬:一个已承诺的整数量化 transformer,从给定 prompt 逐位产生了这个 token 序列。
怎么做到:先固定一个不含任何浮点步骤的整数函数 F_O——每一次舍入、归一化、softmax、采样决策都由其输入唯一决定;然后用约束系统证明这些关系在 31 位 KoalaBear 素数下可证不溢出。证明工程上,把 zerocheck 与 LogUp-GKR 查询批成每域一次 sumcheck,用 Reed-Solomon 编码 + BLAKE3 Merkle 树 + 混合长度 BaseFold 开口,对全部 witness 张量与权重做一次多线性承诺;证明器按层流式在单卡上跑。
实测:单张 RTX PRO 6000 Blackwell 上,为 Qwen2.5-32B 全 64 层出证:4,096 token 92.5 秒、16,384 token 398 秒。
判断:这是 ZK 推理从「玩具模型」跨到「32B 生产级模型」的一步,且给出了可复现的单卡基线。但注意成本:16K token 要 398 秒——可验证性目前是给高价值、低频次的场景用的(审计、合规、争议裁决),不是给在线服务用的。
来源:arXiv · https://arxiv.org/abs/2611.14083 · 2026-11-10
7. 另两篇值得记的短评:agent 流量需要自己的 QoS,评测框架的稳定性被量化了
2611.14211 VATC(可验证 agent 流量类):agent 产生的流量与人类网页流量完全不同,但路由器没有为它准备任何类别,也无法验证发送方是否真是 agent。方案给 agent 流量一个保留的 DSCP 值声明身份,路由器侧分类器把「声明与行为矛盾」的流转降到 best-effort 之后,配限速优先队列。在两个模拟器 + 真实 Linux 内核上对比静态 DiffServ、信任标记的专属类与 fq_codel:稳态与 DiffServ 持平;在构造性突发下 agent 平均排队延迟相对 DiffServ 降 98%(假设判定即时),代价是人类流量延迟 +12%。
2611.14493 三种 agent 评测范式的横向对比:trace-based LLM 评判、纯文本 LLM 评判 + 红队、确定性启发式,在冻结执行轨迹上比。97% 的配置达到稳定性阈值,且稳定性与 agent 无关;在 72 个有标准答案的用例上,trace-based 取得最好的精确率-召回平衡(F1 = 0.90),纯文本评判召回相当但误报多 5×。
判断:这两篇合起来的信号是agent 正在长出基础设施层的需求——网络要给它们分车道,评测要给它们建稳态。第一篇有个隐藏前提要留神:「降 98%」建立在「判定即时」上,而判定本身要花时间,这个假设一旦放宽,收益会显著缩水。
来源:arXiv · https://arxiv.org/abs/2611.14211 / https://arxiv.org/abs/2611.14493 · 2026-11-10
五、值得关注的趋势
1. 「判定类推理」正在从生成模型里剥离,成为独立的价格带
Gemini Decision 1 的 $0.10/M 输入 + 输出免费是一个信号,不是一次孤立促销:它意味着 Google 认为「分类、路由、策略校验、内容评分」这些调用的成本结构应该与生成完全不同。对照索引里的历史:Perplexity 的 Decisions API 起步 $0.04/M、后来减半到 $0.02/M;Liquid 的 d1 走「单次前向不生成 token」;Microsoft 的 Decision 1 是 $0.042/M 输入、输出免费;vLLM-SR 的 Decision 3.0 给六档 0.59B–26.09B 开源权重。这一整条线在过去一个多月里已经成型,而 Gemini 的进入把它的上限(256K 输入、1,000 问题/请求、多模态)拉到了一个生成模型才能给的水平。
真正的判断在这里:「判定」被拆出来之后,agent 的成本表会重写。今天大多数 agent 框架里,路由、重试判定、安全闸、结果校验都靠「再问一次大模型」实现,这部分开销随步数线性增长。一旦判定按「问题数」计费且延迟在 150ms 量级,这些闸门就会从「能省则省」变成「默认开启」——而默认开启的闸门,才是可靠性提升的真实来源。
2. 「可控放量」成了新模型的默认发布形态,而不是「全面开放」
本期三条新品,三种闸门,同一个逻辑:Qwen4-Max 只开 Token Plan、写死 14 天窗口、期间承诺不变更、到期下线且不留权重;Tabletop 只开美国 18+ 候补名单,每周放一批;AlphaGenome 2 非商用经 API 即日可用,商用只走私有预览。连 Mythos/Fable 5.2 那一档之前的发布,也是先在受控伙伴里跑。
这和 2024–2025 年的「发布即全面可用」是相反的方向。原因不难猜:推理成本不再是边际成本,而是真实现金支出(OpenAI 单季营业亏损 109 亿美元、CoreWeave 单季利息 8 亿多);一次全面开放的流量峰值,可能要按季度财报的代价来付。于是「预览」从技术状态变成了容量阀门。
对使用方的实际影响是两条:① 把预览模型接进默认工作流的风险变高了——Qwen4-Max 的 ID 会在 11-25 消失;② 但判断窗口也更清楚了——官方承诺预览期行为不变更,反而给了你一个可以做严格 A/B 的稳定基线。这两条要一起用:在窗口内做对照实验,但不要把关键路径绑上去。
3. 算力瓶颈正从「芯片」转向「电、交付和旧资产」,而旧资产在升值
三条独立证据指向同一件事。CoreWeave:上代 Ampere/Hopper 租金环比 +30%–50% 且高于原合同价,部分设备签的年限超过会计折旧年限;2027 年已投放算力基本售罄、合格需求约为容量 10 倍;7 月提价 25%、季末再提 10%。AMD:CPU 的产品分档从「通用」改成按 agent 的三种角色分(通用服务 / GPU 宿主 / agent 沙箱),说明约束点已经从「算得快」移到「单位功率能塞进多少个 agent」。Torus(11-11 宣布 5 亿美元成长轮 + 发布 Foundry 模块化推理基础设施,一手稿在 businesswire.com 不可达、仅经转载,故不入正文):主打「把芯片搬到电旁边」——利用变电站与工商业建筑之间未被使用的并网容量,在表后安装 1–20MW 的预制单元,合同到上线 12–16 周,官方称最小单元约一辆小货车大小、无需新建建筑。
把这三条串起来的判断是:「算力不够」这个说法已经过时,准确的说法是「已通电的算力不够」。这解释了为什么旧 GPU 会涨价(它们是已通电的)、为什么 CPU 要按功率密度分档(同 35kW 里塞更多 agent)、为什么有人开始做「把机柜搬到变压器后面」。对做推理成本预算的人,含义是:未来两年降本的主要来源可能不在单卡性价比,而在电力与交付周期。
4. 单一关键人物的风险,第一次被市场按「资产」而不是「八卦」定价
11-11 美股盘中 NVIDIA 涨 2.87% 收 173.73 美元,盘后一度跌超 9%。触发链条可核:先有媒体报道黄仁勋与一名直接向其汇报的高管存在关系(《纽约时报》,引五名曾任职人士),随后《华尔街日报》报道董事会正准备采取可能导致其离任的行动、最早当日开会讨论去留,跌幅随之扩大。截至本报告完稿,NVIDIA 未发布任何正式公告,董事会结果亦未公布;公司此前(11-08)已确认由独立董事组成委员会、聘请外部法律顾问启动独立调查。
这条进「趋势」而不是「正文」,是因为事实层面无法核实到公司口径。但它值得记的地方在于市场的反应函数:一家市值数万亿美元、创始 CEO 在任 33 年、没有明确继任者的公司,其治理风险在盘后流动性最薄的时候被瞬间重定价 9%。对照同一周的两份财报——OpenAI 与 Anthropic 都在用「企业收入翻倍」证明自己不依赖单点叙事,而 NVIDIA 的估值里始终含着一块无法分散的个人溢价。
判断:这件事无论结果如何,都会推动两件事被认真讨论——继任计划与关键人物保险/治理披露。这两项在 AI 公司里长期被当成「创业期不必谈」的问题,而现在它们有了一个 9% 的价格标签。
六、有趣的 AI 开源项目
1. HybridRobotics/supermimic — 用一个可微世界模型做人形机器人全身动作跟踪
1,045★ / Apache-2.0 / Python / 2026-11-10 创建 / 11-11 推送 / 70 forks。README 的一句话定位是「Humanoid whole-body motion tracking with one differentiable world model」。
为什么值得看:人形机器人的全身跟踪长期卡在两件事上——参考动作与真机动力学不匹配(retarget 之后动作看起来对、跑起来摔),以及仿真到现实的差距需要大量手工调参。这条路线用「一个可微世界模型」把这两件事合并:让模型自己学「这个动作在我的身体上会变成什么」,而不是先精确重定向再硬控。可微意味着梯度可以从「看起来像不像」直接回传到控制参数,省掉了中间那层人工设计的奖励函数。
注意:这是 11-10 新建的仓库,没有论文、没有 benchmark、没有第三方复现,74 forks 但 issue 与 PR 活跃度未核。当「值得关注的方向」看,不当「可用工具」用。
来源:GitHub · https://github.com/HybridRobotics/supermimic · 2026-11-10
2. FrigadeHQ/yogurt — 本地跑 Whisper + llama.cpp 的会议纪要工具
428★ / MIT / TypeScript / 2026-11-10 创建 / 11-11 推送。仓库 topics 直接把技术栈写出来了:llama-cpp、whisper、mcp、transcription、local-ai、privacy、electron,跨 macOS / Linux / Windows。
为什么值得看:会议纪要这个场景在过去半年是 AI 产品最拥挤的赛道之一,但绝大多数方案要把录音上传到云端。这条走的是完全本地:转写用 Whisper 本地跑,总结用 llama.cpp 本地跑,MCP 做工具扩展。它踩中的是一个正在变大的需求——企业开始要求「会议内容不出网」,而本地小模型的质量在最近几个月刚好跨过了「够用」这条线。
注意:同一组织(FrigadeHQ)此前有 hob(本地 AI 客户端,索引 L522 记 10-28),yogurt 是不同项目,不是版本更新。428★ 里有多少来自组织已有的关注度,无法区分。
来源:GitHub · https://github.com/FrigadeHQ/yogurt · 2026-11-10
3. JDhruv14/line-art-animation — 把「线稿人形会走路」打包成一个 Claude Skill
446★ / MIT / TypeScript / 2026-11-10 创建 / 66 forks。定位是「A Claude skill and TypeScript library for animated line-art SVG components」——会走、会反应的墨水人形,以及带昼夜循环的场景。
为什么值得看:这条的形态比内容更有意思。它不是「一个动画库」,而是一个 Skill + 一个库的双交付:Skill 让 agent 知道怎么调用,库负责实际渲染。这种「给 agent 的可复用能力,同时以 Skill 形式声明用法」正在成为一种新的开源形态——上一期收录的 expo/exact(一份 Contract 描述界面)和 WoYun520/gif-factory(风格即文件的 Skill 合集)也是同一个方向。
【判断】它真正解决的问题不是「画线稿」,而是让 agent 生成的视觉产物具备可复现性:SVG 是代码,代码可以 diff、可以 review、可以进版本库,比生成一张 PNG 更适合工程流。
来源:GitHub · https://github.com/JDhruv14/line-art-animation · 2026-11-10
⚠️ 待核实
| 项 | 不确定点 |
|---|---|
| Claude Meetings | 多家媒体(Reuters 经 The Star、Gulf News、Times of AI)报道 11-10 发布 Team/Enterprise beta、仅支持 Google Meet、Claude 以可见参与者身份加入并会自我声明、外部访客加入时自动退出、管理员未授权则不加入含外部访客的会议。但一手源缺失:anthropic.com/news 列表与 claude.com/resources/articles 列表(313 条)均无 Meetings 条目,/news/claude-meetings、/blog/claude-meetings、support.claude.com 全部 404;有二手转述称官方帖写的是「coming soon」而非已上线。缺的是官方博文 URL 与正式状态(coming soon vs beta) |
| NVIDIA 董事会拟罢免黄仁勋 | 《华尔街日报》11-11 报道董事会正准备采取可能导致其离任的行动、最早当日开会;《纽约时报》同日报道另一段与直接下属的关系。NVIDIA 未发正式公告、董事会结果未公布;路透称未能独立核实相关指控。市场侧可核:11-11 收盘 173.73 美元(+2.87%),盘后一度跌超 9%。缺的是公司声明与董事会决议 |
| Gemini Decision 1 的基准表现 | 官方仅定性表述「四类基准全系列领先、校准误差最低」,未公布任何具体分数、胜率或测试集规模;「比 Gemini 3.5 Flash-Lite 便宜近 5 倍」为官方口径,未给逐项成本明细。noul 字段名疑为 bool 的排版/抓取问题,官方文档代码示例确实写作 "type": "noul" |
| AMD 6 代 EPYC 的全部倍数 | 3.7×、2.2×、2.0×、1.8×、3.3×、2.5×、1.18× 全部为 AMD 自测,无第三方复现;「per CPU watt 的 agent 数」未公开 agent 定义、并发模型与内存带宽压力设定。Azure/OCI 实例为「即将上线」,非在售 |
| AMD EPYC「Verano」 | 二手来源称 OCP 2026 展示、Zen 6、最高 192 核、首个上 LPDDR5X/SOCAMM2 的 EPYC、面向 MI500、2027 上市;但另有来源称「最高 72 核、SB1 插槽、5GHz」。核心数与插槽口径互相矛盾,且 amd.com 新闻页与本机直连不可达,本期不入正文 |
| MiniMax H3-Image 的参数量与架构 | 官方博文只给速度、分辨率、参考图数与定价,未给参数量、层数、许可条款细节;huggingface.co 在本机返回 000,权重仓库未能直连核验。此前流传的「331 亿参数 / 50 层 DiT」在一手源中无法确认,故正文不写 |
| AlphaGenome 2 为何保留第一代 | 官方博文未说明保留 AlphaGenome 1 的理由,也无下线或弃用声明;AG1 仅作为对比基线出现(16% / 23%)。训练算力、参数量、API 配额与定价均未披露 |
| Tabletop 的底层模型 | 官方博文未提及任何模型名,既未说 Gemini,也未说规则/模板驱动,仅在分类标签里归入「Google Labs, AI」;未披露定价、单空间人数上限、美国以外计划 |
| IBM Imagine Enterprise 的商业条款 | 未公布定价、GA 日期、具体客户名与试点结果;「82% 全球商业领袖计划 18 个月内布署数字劳动力」的出处、样本量与调查方法未说明;6,000+ agent 的口径(可运行 / 模板 / 资产)未拆解 |
| OpenAI 三季度全部数字 | 非公司公开发布,来自 11-10 投资者电话会经 WSJ 与 Bloomberg 报道;「调整后」具体剔除了哪些项未定义;OpenAI 对 Bloomberg 拒绝置评、未即时回应路透。与 Anthropic 的 170 亿计收口径不同,不可直接横比 |
| 智谱回购的可执行性 | 公告明示仅为意向、董事会绝对酌情、不保证实施;40 亿港元与 1% 股本两个上限并行,实际回购规模可能远低于上限;需取得必要监管批准 |
| Torus 的 Foundry 参数 | 一手稿在 businesswire.com 返回 000,仅经 Morningstar / Unite.AI 等转载取得;1–20MW/站点、12–16 周、47,000 GPU 目标、Ghalt 500MW 产能均为公司自述,无第三方验证。故只在趋势中作旁证引用,不入正文 |
| Helsing Clarity | 多来源称 11-11 发布欧洲版军事情报平台(读无人机/卫星/传感器数据、标潜在目标、给适用武器建议、人类操作员审核授权、跑在客户自有基础设施);但 helsing.ai 返回 429、官方新闻页不可达,仅有二手转述。本期不收 |
本期淘汰记录
| 类型 | 条数 | 明细 |
|---|---|---|
| 脚本判 DUP | 5 | 第一轮强键全部命中,均为前两日刚收录、本期无新事实:Gemini 4 Carbon 全面开放(L815,11-11 已记全定价与三个第三方榜)、Claude Whiteboards / Sheets / Data(L819,11-11 已记全 Beta 状态与默认开关)、NVIDIA GR00T 2 + Isaac Lab 3.0(L797,11-09)、Fireworks AI 二次入侵(L798,已标注「公告更新至 11-09」)、libracoder/kiri(L760,11-02) |
| REVIEW 复核后淘汰 | 0 | 第二轮 11 条 REVIEW 全部收录:Decisions API、Qwen Code、H3-Image、Tabletop、llama.cpp、Imagine Enterprise、CoreWeave、OpenAI Q3、平头哥、智谱、yogurt。逐条读过 related_rows 后确认均为独立事件而非旧事件增量——最强的对照是 yogurt 与 L522 的 FrigadeHQ/hob:同一组织、不同项目(本地 AI 客户端 vs 本地会议纪要),按新项目处理并在正文注明关系 |
| 语义兜底淘汰 | 7 | ① Meta Muse Ember——索引 L790(11-09)已记全价格、上下文、AA Index 与 AutomationBench 分数,本次二手稿无新增;② Helsing Clarity——helsing.ai 429、一手新闻页不可达,仅二手转述;③ AMD EPYC Verano——核心数与插槽口径在二手源间矛盾(192 核 vs 72 核),一手不可达;④ Moonshot 租用 B300——索引 L682(11-04)已覆盖算力管制延伸到租赁端,本次为小站转述无新增;⑤ janestreet/agent_skills(5,927★)——2026-11-03 创建,早于窗口起点;⑥ sarpstar/cinecode(2,218★)——2026-11-03 创建,同上;⑦ jamesondh/chimera-vocal-synth(1,981★)——2026-11-05 创建,同上。后三条按「发布日期不得早于窗口起点」剔除,并非质量问题 |
| 语义兜底降级合并 | 1 | Torus Foundry + 5 亿美元成长轮(一手 businesswire.com 000、仅经转载)——不单列正文,其「把芯片搬到电旁边 / 表后 1–20MW 预制单元 / 12–16 周上线」作为趋势三的旁证引用,并在待核实标注「公司自述、无第三方验证」 |
| 人工剔除(板块容量) | 2 | 2611.14356 EngineAgent(端侧推理引擎的 agent 化,与 2611.14492 ReTrace 同属「把 agent 工程化」一族,容量所限让位)、2611.14009 CAMP-II(编码 agent 文件记忆,与 2611.14326 FGSE 同属「记忆」一族,同理让位)。两条均通过时效与质量检查,属主动让位,下期可回补 |
| 第一轮 DUP 但一手源确认是新事件 | 1 | Claude Meetings——第一轮被弱键命中 L819(Claude 三件套),但索引里没有 Meetings;回溯后确认这是 11-10 的独立新功能。然而官方博文不存在可访问版本,故不写正文、改列待核实。这是本期唯一一次「想翻案但缺一手源」 |
| 白名单检索但窗口内无内容 | 4 | vLLM(最新 v0.33.0rc3,11-02)、SGLang(最新 v0.5.23,11-02)、Transformers(最新 v5.22.2,11-06)、Ollama(v0.40.17-rc0 已于 11-11 期收录,窗口内无新正式版)——不做凑数条目 |
| 独立发现通道(不在候选清单内) | 3 | 第六节三个项目 HybridRobotics/supermimic、FrigadeHQ/yogurt、JDhruv14/line-art-animation 由 GitHub Search API 按「2026-11-09 后创建 + 100★ 以上」检索得到(该窗口共 8 个仓库达门槛,其余 5 个与本日报主题无关:iOS 配置工具箱、Solana 验证节点监控、BNB 链 mint 脚本、Wayland shell、浏览器 profile 工作区),未经脚本预筛 |
token 账:全量索引 833 条数据行 / 233,867 字符 ≈ 86,617 token(--audit 报问题 2 处——L77、L87 列数为 7,为摘要内含未转义 |,容错解析可读,未超 10 行门槛,未阻塞)。第一轮 36 条候选 → DUP 5 / REVIEW 14 / NEW 17;回溯一手源后重建第二轮 25 条(8 条换成已验证一手 URL、4 条为回溯期新发现、论文 9 进 8 出、剔除 15 条不可达/窗口外/让位项)→ DUP 0 / REVIEW 11 / NEW 14,以第二轮为准。预筛后需读 9,482 字符 ≈ 3,512 token,压缩 24.7×(NEW 14 条无需读索引)。回写后索引 858 条数据行(回写前 833 + 本期 25,全部写入、零跳过),含「更新至」标记 62 行。
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止 |
|---|---|---|---|---|---|---|
| 1 | 一 | Gemini Decisions API | https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/ | 2026-11-11 | 2026-11-11(延迟在 16K 上下文档位测得;benchmark 无具体分数;Cloud 支持 coming soon) | |
| 2 | 一 | 模型上架与更新(qwen4-max-preview 条目) | 阿里云百炼 | https://help.aliyun.com/zh/model-studio/newly-released-models | 2026-11-11 | 2026-11-11 10:00(预览窗至 11-25 24:00;参数量/跑分/单价/权重均未公布) |
| 3 | 一 | MiniMax H3-Image: Bringing 4K Image Generation into the 10-Second Era | MiniMax | https://www.minimax.io/blog/minimax-h3-image | 2026-11-11 | 2026-11-11(速度倍数为厂商自测;参数量未披露;HF 权重仓库本机不可达) |
| 4 | 一 | AlphaGenome 2: deciphering how cells read DNA | Google DeepMind | https://deepmind.google/blog/alphagenome-2-deciphering-how-cells-read-dna-to-better-understand-disease/ | 2026-11-11 | 2026-11-11(TenK10K 28 种细胞;仅研究用途、未获批临床;算力成本未披露) |
| 5 | 一 | Try Tabletop: Customizable, collaborative spaces | Google(Roman Nurik) | https://blog.google/innovation-and-ai/models-and-research/google-labs/tabletop/ | 2026-11-11 | 2026-11-11(美国 18+ 候补名单;底层模型未披露) |
| 6 | 二 | llama.cpp b12292 | ggml-org | https://github.com/ggml-org/llama.cpp/releases/tag/b12292 | 2026-11-11 | 2026-11-11 20:15Z(当日 30 个构建,b12263 01:26Z 起;与索引 L822 无重叠) |
| 7 | 二 | Qwen Code 1.0 Preview(v1.0.0-preview) | QwenLM | https://github.com/QwenLM/qwen-code/releases/tag/v1.0.0-preview | 2026-11-11 | 2026-11-11T03:55Z(Preview 期接口可能变;1.0 为独立分支) |
| 8 | 二 | AMD Showcases 6th Gen EPYC Processors | AMD | https://ir.amd.com/news-events/press-releases/detail/1305/amd-showcases-6th-gen-amd-epyc-processors-to-lead-next-era-of-ai-and-enterprise-computing | 2026-11-10 | 2026-11-10(全部倍数为 AMD 自测;Azure/OCI「即将上线」) |
| 9 | 二 | The digital workforce: Why the next competitive frontier isn't AI | IBM | https://www.ibm.com/new/announcements/the-digital-workforce-why-the-next-competitive-frontier-isn-t-ai-it-s-how-you-operationalize-it | 2026-11-10 | 2026-11-10(未公布定价/GA/客户;82% 的出处与样本未说明) |
| 10 | 三 | OpenAI Continues to Suffer Heavy Losses as Revenue Rises to $10 Billion | WSJ | https://www.wsj.com/business/earnings/openai-continues-to-suffer-heavy-losses-as-revenue-rises-to-10-billion-d2a96bbb | 2026-11-10 | 2026-11-10(投资者电话会;非公开发布;「调整后」未定义;付费/周活为同日披露) |
| 11 | 三 | CoreWeave Reports Strong Third Quarter 2026 Results | CoreWeave | https://investors.coreweave.com/news/news-details/2026/CoreWeave-Reports-Strong-Third-Quarter-2026-Results/default.aspx | 2026-11-10 | 2026-09-30(季末);指引为 11-10 口径;旧卡租金与售罄表述来自当日电话会 |
| 12 | 三 | OpenAI, Anthropic face new oversight as New York's AI safety law takes effect | TechCrunch | https://techcrunch.com/2026/11/10/openai-anthropic-face-new-oversight-as-new-yorks-ai-safety-law-takes-effect | 2026-11-10 | 2026-11-10(登记截止 2027-01-01;中心只能评估公开材料,据 Engadget) |
| 13 | 三 | 阿里巴巴:已正式申请平头哥独立上市 | 证券时报 | https://www.stcn.com/article/detail/4330866.html | 2026-11-10 | 2026-11-10(出货量为截至 2026-04;IPO 规模未定) |
| 14 | 三 | 自願公告:根據一般授權購回 H 股的意向 | 智谱(港交所披露易) | https://www1.hkexnews.hk/listedco/listconews/sehk/2026/1110/2026111000852_c.pdf | 2026-11-10 | 2026-11-10(仅为意向、不保证实施;股价与财务为公告外背景数据) |
| 15 | 四 | Can KV Cache Be Reused Across Model Updates? | arXiv | https://arxiv.org/abs/2611.14051 | 2026-11-10 | 2026-11-10(预印本;DeepSeek-V4-Flash 单一案例) |
| 16 | 四 | Precision on Demand | arXiv | https://arxiv.org/abs/2611.14418 | 2026-11-10 | 2026-11-10(预印本;模拟量化、Qwen3-0.6B、GSM8K;p=0.053 未达显著) |
| 17 | 四 | ReTrace: Distilling Tool-Using Agents into Planner-Free Workflows | arXiv | https://arxiv.org/abs/2611.14492 | 2026-11-10 | 2026-11-10(预印本;79 个生产流程,作者自述平台) |
| 18 | 四 | FGSE: Falsification-Gated Self-Evolution for LLM Agents | arXiv | https://arxiv.org/abs/2611.14326 | 2026-11-10 | 2026-11-10(预印本;作者自测) |
| 19 | 四 | AI Isn't Getting Dumber, We're Getting Pickier | arXiv | https://arxiv.org/abs/2611.14333 | 2026-11-10 | 2024-08(Arena 数据截止);1,260,967 张投票 |
| 20 | 四 | Sable: A Small-Field Sumcheck Argument for Bit-Exact Inference | arXiv | https://arxiv.org/abs/2611.14083 | 2026-11-10 | 2026-11-10(预印本;单张 RTX PRO 6000 Blackwell,Qwen2.5-32B) |
| 21 | 四 | Verifiable Agentic Traffic Class (VATC) | arXiv | https://arxiv.org/abs/2611.14211 | 2026-11-10 | 2026-11-10(预印本;98% 降幅假设判定即时) |
| 22 | 四 | Comparative Analysis of Agent Evaluation Frameworks | arXiv | https://arxiv.org/abs/2611.14493 | 2026-11-10 | 2026-11-10(预印本;两个分析 agent、冻结轨迹) |
| 23 | 六 | HybridRobotics/supermimic | GitHub | https://github.com/HybridRobotics/supermimic | 2026-11-10 | 2026-11-11 08:06Z(1,045★ / Apache-2.0 / Python / 70 forks;无论文与 benchmark) |
| 24 | 六 | FrigadeHQ/yogurt | GitHub | https://github.com/FrigadeHQ/yogurt | 2026-11-10 | 2026-11-11 23:46Z(428★ / MIT / TypeScript;与 L522 的 hob 为同组织不同项目) |
| 25 | 六 | JDhruv14/line-art-animation | GitHub | https://github.com/JDhruv14/line-art-animation | 2026-11-10 | 2026-11-10 09:25Z(446★ / MIT / TypeScript / 66 forks) |
引用提醒:第 1 条的 $0.10/M 与「输出不计费」是官方公告口径,但「便宜近 5 倍」与「四类基准全系列领先」没有任何具体分数支撑,不可当作已验证的性能结论;
noul疑为bool的排版问题,引用时建议写「是非判定(文档中字段名为 noul)」;延迟 150–250ms 是 16K 上下文档位的测量值,与 256K 上限不是同一口径。第 2 条只给规格与窗口,不给跑分、参数量、单价与权重,「Qwen4 即将发布」与「本次为预览」是两件事,不要把预览版当正式版引用;393,216 是思考 + 回答共享的输出预算。第 3 条的 5×(4K 满分辨率)、1.5–2×(Standard)、3–4×(Highspeed)是三个不同口径,不能相加或互换;参数量在一手源中缺失。第 4 条仅研究用途、未获批临床或诊断,商用需私有预览;「保留一代模型的原因」官方未说明,不要推测。第 5 条未披露底层模型,不要写成「由 Gemini 驱动」。第 6 条与索引 L822 的 b12238–b12262 无重叠;FP8 三条线分属不同 PR(#28392 / #28413 / #31896),不要合并成「一个 FP8 特性」。第 8 条全部倍数为 AMD 自测,未公开测法;Verano 的核心数在二手源间矛盾(192 vs 72),本期不采用。第 9 条的 6,000+ agent 口径未拆解,保险理赔为样板流程而非已上线客户案例。第 10 条为投资者电话会经媒体报道,非 OpenAI 公开发布,「调整后」未定义;与 Anthropic 的 170 亿计收口径不同。第 11 条的营收与利润为公司公告,旧 GPU 租金 +30%–50%、2027 售罄、需求 10 倍来自当日电话会(CEO 表述),非财报数字。第 12 条的「72 小时全美最严」为州方口径;评估中心只能看公开材料这一限制来自 Engadget 报道,非州政府文件。第 14 条明写仅为意向,不得表述为「已决定回购」。第 15–22 条均为预印本、未经同行评审,全部数字为作者自测;第 16 条的 62.7% vs 64.0% 未达统计显著(p=0.053),第 21 条的 98% 建立在「判定即时」假设上。第 23–25 条均为 11-10 新建仓库,无论文与第三方复现,星标数含新建仓库的自然曝光效应。