AI DAILY
AI 日报 2026-11-13
一句话结论本期收录 28 条资讯(模型与产品 5 / 工程 5 / 行业 5 / 论文与开源 10〔其中 1 条为两篇短评合并〕/ 开源项目 3)+ 3 条趋势,共 28 条写入索引。淘汰账:脚本判 DUP 3 条、REVIEW 复核后淘汰 0 条(18 条全收)、语义兜底淘汰 5 条、降级合并 2 条、待核实 10 项。最值得看的是 Gemini 4 Hydrogen 的定价结构——1M 上下文全程扁平 $1.50/$7.50,只有 Carbon/Argon 的 75%(11-30 后者翻倍后是 37.5%),而 Terminal-Bench 4.1 从 3.8 Flash 的 18.2% 直接跳到 57%。但真正的新信息不是「便宜」,是 Google 同时给了 Antigravity Orchestrator:在同一会话里让 Carbon 当协调者、Hydrogen 当 worker/verifier,官方口径配额少 24%、完成快 19%、成功率接近 Carbon。也就是说,模型家族开始按「角色」而不是「能力档位」卖:贵的那档卖判断,便宜的那档卖执行,中间的差价由一个自动调度器吃掉——这恰好也是对上层 agent 框架路由逻辑的一次挤压。同一条时间线上还有一条被低估的:Anthropic 的《支持地区政策》11-12 生效,把准入从「人在哪」一路穿透到「股权被谁控制」,是第一家把出口管制的穿透式标准写进通用 ToS 的前沿实验室,而它正好落在 IPO 路演定价窗口内。技术侧最硬的一条在 llama.cpp 的 b12340:server 的 CORS proxy 与媒体 URL 存在 SSRF,所有对外暴露的 llama-server 都该立刻升级。
AI 日报 2026-11-13
整理日期:2026-11-13 素材来源:白名单一手源(Google 官方博客与 Google DeepMind、NVIDIA 官方 newsroom、Anthropic 政策页与新闻页、百度文心官方发布页、GitHub Releases API 与仓库本体、VS Code 官方更新日志、AWS News Blog、PRNewswire 企业新闻稿、arXiv 原始 abs 页),二手媒体仅用于发现线索并回溯一手源,逐条见文末附录 可信度提示:统计窗口 2026-11-12 00:00 → 11-13 10:00 HKT。四条口径先说清:① 11-12 是周四,Google 一天内连发三篇(Hydrogen 模型、Search 升级、智能眼镜预售),NVIDIA 在美东时间当日发布 CEO 变更公告,llama.cpp 在 11-12 一天推了 24 个构建(b12302→b12340)。② arXiv 本期仍只能取到 11-10 的提交批次:
arxiv.org/list/cs.AI/new页面最新公告日仍是「Wednesday, 11 November 2026」,export.arxiv.org的 API 在本机返回空响应,9 篇论文逐篇回查arxiv.org/abs/确认Submitted on 10 Nov 2026;本期论文池与 11-12 期同口径,不重复收录 11-12 期已用过的 8 篇。③ 本机对多个一手域直连失败:thehindu.com直连 fetch failed(仅 WebFetch 通道可读)、openai.com403、code.claude.com/docs/en/code-mode(含.md变体)与modelsatwork.news均 404,凡一手不可达者一律不入正文或显式标注替换出处。④ 厂商自测 benchmark 全部标「厂商自测、无独立复现」;本期的 Hydrogen 基准、Google 智能眼镜参数、ERNIE 演示、MACaQ 数字、open-orange 成本倍数均属厂商口径。 配图:文中三张图为自绘(依据下列来源整理),非原文插图。
#AI日报 #模型动态 #Agent #推理基础设施 #安全 #论文 #开源项目
一句话结论
本期收录 28 条资讯(模型与产品 5 / 工程 5 / 行业 5 / 论文与开源 10〔其中 1 条为两篇短评合并〕/ 开源项目 3)+ 3 条趋势,共 28 条写入索引。淘汰账:脚本判 DUP 3 条、REVIEW 复核后淘汰 0 条(18 条全收)、语义兜底淘汰 5 条、降级合并 2 条、待核实 10 项。最值得看的是 Gemini 4 Hydrogen 的定价结构——1M 上下文全程扁平** $1.50/$7.50,只有 Carbon/Argon 的 75%(11-30 后者翻倍后是 37.5%),而 Terminal-Bench 4.1 从 3.8 Flash 的 18.2% 直接跳到 57%。但真正的新信息不是「便宜」,是 Google 同时给了 Antigravity Orchestrator:在同一会话里让 Carbon 当协调者、Hydrogen 当 worker/verifier,官方口径配额少 24%、完成快 19%、成功率接近 Carbon。也就是说,模型家族开始按「角色」而不是「能力档位」卖:贵的那档卖判断,便宜的那档卖执行,中间的差价由一个自动调度器吃掉——这恰好也是对上层 agent 框架路由逻辑的一次挤压。同一条时间线上还有一条被低估的:Anthropic 的《支持地区政策》11-12 生效,把准入从「人在哪」一路穿透到「股权被谁控制」,是第一家把出口管制的穿透式标准写进通用 ToS 的前沿实验室,而它正好落在 IPO 路演定价窗口内。技术侧最硬的一条在 llama.cpp 的 b12340:server 的 CORS proxy 与媒体 URL 存在 SSRF,所有对外暴露的 llama-server 都该立刻升级。**
一、模型与产品
1. Gemini 4 Hydrogen:1M 上下文全程扁平计价,并在 Antigravity 里与 Carbon 组成「协调者 + 执行者」
11-12 发布,作者是 Google DeepMind SVP 兼首席 AI 架构师 Koray Kavukcuoglu。这是 Gemini 4 家族第三个成员,定位不是「更强的模型」,而是「快的那个」。
规格与定价:1M token 上下文、最多 1M 输出 token,全程统一定价、无阶梯加价——$1.50 / 百万输入、$7.50 / 百万输出。参照系是 Carbon/Argon 的 $2/$10(11-30 起翻倍至 $4/$20,见索引 L815),Hydrogen 按当前价是 Carbon 的 75%,按 11-30 后的价格是 37.5%。四档 thinking:low / medium / high(默认)/ 新增 xhigh。前代对标是 Gemini 3.8 Flash。
速度与基准(均为厂商自测):比 3.8 Flash 在 high 档完成任务快 2.5×;合作方在复杂图、SQL、数据密集型工作流上实测快 2×–2.8× 且 token 少 12%–23%;Google Sheets canvas 场景输出快 30%+。基准侧:Terminal-Bench 4.1 = 57%(3.8 Flash 为 18.2%,三倍多)、AA Intelligence Index = 51(high 档,超过 Argon 的 50;xhigh 档 54)、HLE-Diamond 58.8%、Vals Tax Agent 52.3%(总榜第 1)、Vals Legal Research 55.8%(并列第 1)、MKA 53.4%、Agents' Last Exam v1.1 71.6%、Agent Arena 实时榜第 5。
安全口径(同样厂商自测):越权行为最多 −81%、under-service 最多 −79%、编码与工具使用中的「走捷径」行为 −12×、面对不可完成任务时绕过权限边界的概率最多 −2×、内部 agent honesty 评测诚实率 96.7%、CoT 可读性 99.9%(20 万+ 审计轮零欺骗性推理篡改)、Gray Swan IPI 间接注入韧性 +2.3×、HealthBench Pro 误拒率 <0.4%。
最该注意的不是模型,是编排器:Antigravity 同日推出 Orchestrator,在同一会话内于 Carbon、Hydrogen 之间动态切换。官方给的对照是——相比纯 Carbon,配额少 24%、完成快 19%、成功率接近 Carbon。这条把「多模型协作」从论文里的调度问题变成了产品默认行为。
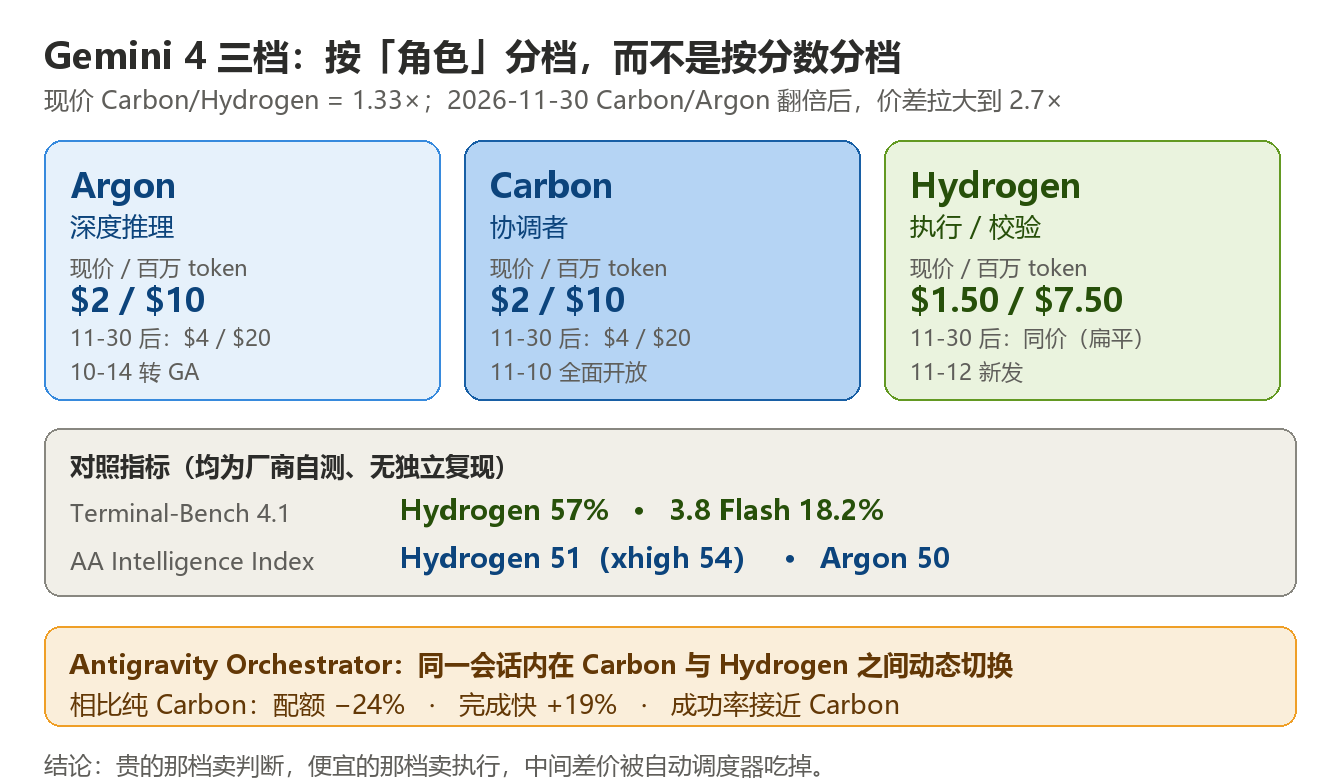
【判断】 三件事放一起看:Hydrogen 单独跑的 AA Index 51 只比 Argon 的 50 高 1 分,但 Terminal-Bench 4.1 高出一个数量级;Orchestrator 的收益是「配额 −24% 而成功率不掉」。这说明这一代的边际收益已经从「单模型更聪明」转移到「按步骤选对模型」。对做 agent 的团队,可操作的结论是:不要再用一个贵模型跑完全程,把「规划/裁决」和「执行/校验」拆成两次不同价位的调用,收益比换模型更大。反过来说,Google 用一个自动调度器吃掉了本该由应用层做的路由工作——这对上层 agent 框架是个挤压。
来源:Google · https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ · 2026-11-12
2. Google Search 接入 Hydrogen:四项升级,但一个数字都没给
11-12,Google 搜索产品副总裁 Robby Stein。这是本期唯一一条「重要性高、可验证性差」的条目,必须分开说。
四项升级:① 意图理解——能处理含多个子问题、拼写错误严重、高度具体的提问,靠更强的指令遵循与工具调用逐条回应;② query fan-out 与链接——对全部相关子主题同时发起查询,官方称能连到此前找不到的网站;③ 更视觉化的回答——更多图片、结构化回答、对比表格、为用户定制的工具;④ 语言理解——覆盖所有 AI Mode 支持的语言。
可用性:全球、所有用户、已上线(原文 Hydrogen is now available globally in Google Search for all users)。官方称这是「迄今对 Search 最大的一次模型升级」。
但:全文没有任何量化——没有延迟、没有准确率、没有 A/B 结果、没有覆盖国家数、没有语言清单,连语音朗读的时长都还留着未填充的 [[duration]] minutes 模板占位符。页面顶部还挂着 Google 自家 AI 生成的摘要模块(标注 generative AI is experimental)。
【判断】 「最大的模型升级」这种最高级表述出现在官方博客里、却没有一个可比数字,这在上半年还比较少见。合理的解读是:搜索的收益难以用单一 benchmark 表达(相关性、时延、覆盖、广告位置互相牵制),而选择不给数字本身是一种信号——它没法给出一个不掉分的口径。真正值得跟踪的是第三方:引用准确率,以及 fan-out 之后长尾站点的流量变化,这两个月内应该会有独立测量。
来源:Google · https://blog.google/products-and-platforms/products/search/gemini-4-hydrogen-search-upgrade/ · 2026-11-12
3. Google 智能眼镜:$395 起、12-10 开售,隐私设计比功能更值得看
11-12 由 Google XR 副总裁兼总经理 Shahram Izadi 发布,开启预售。
产品与价格:两个联名系列。Warby Parker 三款(Alden / Reid / Wren),$395 起,Pine / Saddle / Jet Black 三色,可选光学镜或太阳镜,360+ 家门店提供引导试戴;Gentle Monster 六款设计,$449 起,深红/粉/灰/黄等配色,多数支持处方镜片。两个系列都由 Google 与 Samsung 联合打造。
时间与地域:11-12 预售,12-10 线上线下同步开售;仅美国与韩国,要求美/韩地区 Google 账号、年满 18 岁。
硬件:41 克、最长 9 小时续航(官方注明因使用而异)、充电盒可再充 7 次、12MP 超广角摄像头(HDR、图像防抖、空间音频录制)、开放式扬声器、按键或「Hey Gemini」拍照。
功能:经 Google Translate 做70+ 语言实时语音翻译并自动检测语种;Maps 逐向导航;Guided Vision 对话式音频描述(面向盲人与低视力用户);与 Aira 合作,一句「Hey Gemini, open Aira Explorer」可把画面实时转给人工视觉解说员。兼容 Pixel 7 及以上(Android 17 / 2026-09 更新起)、Galaxy S / S FE / Z 系列(One UI 9.0+)、iPhone 13 Pro 及以上;Guided Vision 与 Aira 首发只支持 Android。
隐私部分写得比功能细:处理前自动对旁观者人脸打码;画面不进 Gemini History、不用于训练、不用于定向广告;本地存储与传输均加密;拍摄指示灯被遮挡或禁用则自动停止录制;有物理关机开关;应用级摄像头/麦克风权限可控。
【判断】 这条的行业意义不在「Google 又做眼镜」,而在它把「旁观者同意」做成了硬约束:人脸打码发生在 Gemini 处理之前、指示灯被挡就断录制是硬件级 fail-safe。对比 Meta Ray-Ban 早期因「戴的人知道、被拍的人不知道」受批评,Google 这次把监管最在意的三点(可见提示、不可绕过、数据不训练)都写进了产品规格。代价是 41 克 / 9 小时,在「全天佩戴」这道门槛上仍不够——真正决定成败的是电池,不是模型。
来源:Google · https://blog.google/innovation-and-ai/technology/xr-ar/google-intelligent-eyewear-collections-pre-order/ · 2026-11-12
4. ERNIE 5.5 Flash Preview:280B 总参 / 14B 激活,11-25 前开源权重
11-11 发布(窗口内仍在扩散),百度首个 5.5 Flash 后训练版本,基于此前发布的 Base 模型。
规格:总参数 280B、激活 14B、1M 上下文。API 已在千帆平台上线,权重将于 11-25 前开源。官方自述这是「后训练过程中的一个中间版本」,明确承认「可能存在部分因训练不充分导致的能力缺陷」。
展示案例比基准更能说明取向——全部由模型在 agent 框架里端到端完成:① UE 5.8 做第三人称武侠游戏《云岫行》,在11 小时长程编码里把跨多代引擎的素材合入同一工程并用 C++ 写完;关键是它是纯文本模型看不到画面,于是把「人物悬空、跑动方向不一致、相机错位」转成可测量的代码测试来迭代。② Blender 参数化建模:机场用 OpenStreetMap 矢量数据自己检索布局、下载素材、搭航站楼与飞行区;飞机用截面放样与模块化装配做出机身机翼,再统一两工程尺度、编排动画、Cycles/OptiX 分帧渲染、FFmpeg 合成。③ FreeCAD 做 W16 发动机、深圳百度国际大厦双塔、月球概念车,均为可编辑模型。④ 知识工作:20 页《The AI Power Bill》研究报告、24 页自动驾驶对比报告(分析 4,169 条联邦事故报告)、《LIFEWEALTH》财务规划工作簿(含 1,000 条蒙特卡洛路径)。⑤ 视频:用 Python 从零写 116 秒 2D 动画(上万行代码、Pycairo 逐帧矢量绘制),以及 6 分 34 秒原创交响乐。
训练规模也给了:知识工作方向 30 万个工作空间 / 1,000 万份参考文件 / 40+ 文件类型;视频创作方向 15 万个创作环境、上千个 skill、累计成片约 5,300 分钟。
【判断】 这条的性质是「能力展示稿」而非「发布稿」:没有基准表数字(附录在页面末尾但正文只给定性「具有竞争力」,且表格本期未能抓取)、没有定价、没有模型卡。真正的信号有两条:一是开源承诺有明确日期(11-25),这在国产厂商里算硬的;二是演示全部围绕「长程、可验证、跨工具」——11 小时编码任务把「看不见画面」变成「写测试代替看画面」,是少见的诚实描述,比任何 benchmark 都更能说明它训的是什么。风险也直白:14B 激活撑 1M 上下文,长上下文下的衰减曲线官方一个字没提。
来源:百度 · https://ernie.baidu.com/release/ernie-5-5-flash-preview/ · 2026-11-11
5. Claude Code v2.1.323:Code Mode 让 Claude 写 JavaScript 调工具
11-12T22:12Z 发布,本期最值得跟的一条工具链变更。
核心变更:新增 Code Mode(实验性、需主动开启)——Claude 不再逐个发工具调用,而是写一段 JavaScript 来调用工具;组织层面可以统一关闭。官方 release note 给的文档链接 code.claude.com/docs/en/code-mode 目前仍是 404(本期实测,含 .md 变体),机制细节只能从变更描述与其设计意图推断。
同批其余变更(20+ 项,挑对工程有影响的):① plugin.json 新增 engines["claude-code"] 版本门——超出声明范围的插件不安装、不更新、不加载,安装/更新时自动挑符合范围的最新版;② claude plugin validate 新增对插件 TypeScript hooks 模块的类型检查,每条发现都是 warning,--strict 下失败;③ 托管设置新增 CLAUDE_CODE_AUTO_MODE_MODEL(面向第三方 provider 上的 Claude Desktop 会话);④ hooks 长跑时每 30 秒发一次进度心跳,避免宿主把回合判为卡死而终止;⑤ Artifact 资源上传支持 .docx;⑥ Bash allow 规则里变量值含 *(如 Bash(PORT=* npm run dev))时启动告警;⑦ 修复 /compact 重跑或接在 /context 之后会把 Claude 尚未回答的消息摘要掉、恢复会话把新消息接到旧的被打断消息上、Claude 改完超大文件后下一次提问内存尖峰、运行中保存的设置覆盖刚才手改的 settings.json 等问题。
【判断】 Code Mode 方向是对的:现在每调一个工具就要一次完整往返,把「取数 → 过滤 → 再取数」用一段 JS 表达能把 N 次往返压成 1 次,也更容易做循环与数据变换。但它带来一个新的信任边界:以前一次工具调用是一次可审计的动作,现在一段代码里藏着多次工具调用,权限提示、审批与审计日志都要重新设计——这与本期 llama.cpp 的 SSRF 修复、AWS Emulator 的「不评估 IAM」属于同一个问题域:agent 的动作粒度变粗之后,按动作粒度设计的旧控制全部失效。文档还没上线就发版,说明这是抢在某个时点前放出的实验开关,不建议现在进生产。
来源:GitHub · https://github.com/anthropics/claude-code/releases/tag/v2.1.323 · 2026-11-12
二、工程与架构
1. llama.cpp b12308–b12340:一天 24 个构建,b12340 是必须升级的 SSRF 修复
窗口内(11-12 04:32Z → 11-13 01:14Z)共 24 个构建。主线不是性能,是安全 + 正确性。
安全(最优先):b12340 server: fix SSRF for CORS proxy and media URLs(#32115)——llama-server 的 CORS 代理与媒体 URL 拉取路径可被构造成服务端请求伪造。凡是把 llama-server 暴露在非本机地址上的部署都应立刻升级;这条被单独放在 <details open> 里,是当天唯一被这样突出的变更。
正确性:b12336 mtmd 要求 HunyuanVL 使用 F32 position embedding(#32131,HunyuanVL 在 host 上重采样位置编码到 float 缓冲,F64 下首图会溢出);b12323 chat 把 Gemma4 工具参数解析改成 schema 形状的 PEG 解析器(#31915);b12322 graph metadata 不再触碰未使用的页(#32043);b12304 在 llama_context 里一次性复用 graph result 实例(#32089);b12303 jinja 支持链式比较与参数解包(#32072)。
性能:b12329 CUDA 把 NVFP4 的 w_s scale 融合进 MMQ epilogue 以加速 prefill(#26048);b12328 ggml-backend 只预取前序 split 已算完的输入,且当设备跑不了 cached mul_mat_id 时跳过 MoE cache(#32100);b12316 CUDA 跳过空 MoE tile 的 MMQ stream-k fixup(#32067);b12318 CUDA 新增 debug buffer pool(#31919);b12320 SYCL 修复 AOT >4GB 的垃圾输出(#31873)。
后端铺开:b12327 SpacemiT Q4_1 32×256 走 HP kernel(#31929);b12321 SYCL oneDNN FA 缓存线程安全并对运行时失败做记忆化(#31138);b12314 OpenCL 给 Adreno 加分解式 FA(#32046,标注 Assisted-by: Claude Opus 5.5);b12317 OpenCL 新增 A7 Q4_0 非 MoE 二进制 kernel(#30947);b12306 Vulkan 支持批量 tensor copy(#31418);b12311 UI 在搜索时把下载项保留在 Discover 里。
【判断】 这 24 个构建里,只有 b12340 一条是「不改就会出事」。值得批评的是信息结构:一天二十几个构建的节奏下,安全问题只在单条 commit 里出现、靠 release note 一行 fix SSRF 传达,这对下游发行版与 Docker 镜像很不友好。实际影响面取决于是否开了 --cors-proxy 或让 server 拉取远端媒体;如果只是本地跑模型,风险窗口小,但升级成本几乎为零,没有理由不升。
来源:GitHub · https://github.com/ggml-org/llama.cpp/releases/tag/b12340 · 2026-11-13
2. VS Code 1.146:Local harness 被弃用,2027-02 移除
11-11 stable 发布。这是本期对「agent 运行在哪」给出明确答案的一次更新。
弃用公告:Local harness 现已弃用,三个月后(2027 年 2 月)移除。Copilot harness 自 1.143 起已是新会话默认,构建在 Copilot SDK 之上,会话经 Agent Host 运行,因此可后台常驻、同时从编辑器窗口与 Agents 窗口访问;对企业关键差异是Copilot harness 强制托管沙箱与权限策略,Local harness 没有。过渡期内 Local harness 仍可用但功能冻结;1.142 引入、用来把 Local 保持为默认的托管设置 vscode.temporaryDefaultToLocalHarness 将一并移除。
同期新功能:Inbox mode(实验)——Agents 窗口会话列表里用 Grouping > Inbox Mode 打开,把所有项目里「需要你处理」的会话置顶,可 Dismiss / Put on Hold / Snooze,且 Dismiss 不等于归档;Chat windows(预览)——把单个 chat 开进独立窗口,窗口内可容纳来自多个会话的 chat,自由排布编辑器与终端;Model comparison 增强——judge 与 synthesizer 可只作用于纯 chat 响应(不选 workspace),可把 Copilot Fusion 及其 effort 档纳入对比,还可让 agent 自己发现模型、发起对比、读结果跨场景汇总(sessions.chat.compareAgents.tools.enabled,默认关);Agents 窗口支持安装扩展;Agent Host 支持虚拟仓库(此前 Copilot harness 在虚拟仓库不可用,现在可直接看 GitHub 仓库而不 clone)。
安全侧一条容易被忽略:权限提示默认粒度收窄。此前 Copilot harness 对 web fetch 的默认动作是「Allow in this Session」,等于该会话内可访问任意 URL;现在默认改为按具体域名、命令、目录授权。
【判断】 把 harness 做成产品概念,是这一代 IDE 竞争的核心。Local harness 的问题在于它跑在用户机器上、进程边界内,企业无法施加沙箱与权限策略——所以弃用不是技术原因,是合规原因。同时「权限提示按域名/目录收窄」比任何新功能都重要:它把「会话级放行」这个事实上的过度授权堵掉了,而那正是 agent 安全事件最常见的入口。
来源:Microsoft · https://code.visualstudio.com/updates/v1_146 · 2026-11-11
3. AWS Emulator:本地模拟 AWS API,而且这个项目本身由 agent 维护
11-11 由 Daniel Abib 发布于 AWS News Blog,仓库 aws/aws-emulator(5,470★ / CC0-1.0 / Rust / 2026-09-11 创建 / 11-12 仍在推送)。
是什么:在你自己机器上跑一个 AWS API 的本地模拟器。AWS CLI、各语言 SDK、以及编码 agent 都用与云端相同的 API 通过本地 HTTPS 端点通信,应用代码不用改。Linux 用 RPM/Debian 包安装,macOS 与 Windows 用 Docker(官方不提供现成镜像,需从文档里的短 Dockerfile 自建)。无额外服务费。
机制:启动时自生成凭据、config 与证书写到 ~/.aws/emulator/9297/;监听 127.0.0.1:9297(只有本机可访问);access key 以 EMULATOR 开头,用其它 key 签名的请求一律拒绝;单账号 000000000000;要求 SigV4 签名;提供 /__admin/health 供脚本等待就绪。只实现在 AWS API models 仓库里有 API model 的服务,未实现的返回 HTTP 501(让测试立即失败而非静默通过)。
保真度怎么衡量:官方用 fidelity test——一段用 SDK 跑真实工作流(如存对象再读再删)并断言 AWS 行为的短程序,每个都先在真实 AWS 上验证;只有每次调用的响应(状态码、body、精确的 error code 与 message)以及工作流创建的资源与数据都与 AWS 一致才算通过。每版公布每服务的 k of n,测试集在 aws-emulator-evaluation-suite 仓库公开、包含尚未通过的。官方明确提示:增加测试会让分数下降,应把它当快照而非绝对值。
嵌入模式:AWS SDK for Rust 可用 aws-emulator-embedded crate 直接在测试进程内实例化,每个实例独立状态、可并行,不需要网络。
最特别的一点:这个项目由 agent 构建与维护——用 Amazon Bedrock AgentCore Runtime + CodePipeline + CodeCommit,从 AWS API models 生成。一组 agent 通过「对比模拟器响应与真实 AWS」以及「把模拟器代码与 Smithy 模型静态比对」找差距并逐条开 issue;另一组接 issue、写测试、实现、审正确性/性能/安全,推送到源仓库后由 CodePipeline 跑完 fidelity test 才发布。因为代码由 agent 写,另有一个独立安全 agent 对抗式复核,在修复过程中与发布管线各查一次。
明确的能力边界:不评估 IAM 策略与基于资源的策略——AWS 会拒绝的请求在模拟器里可能成功。官方原话:「不要用它测试你的应用是否安全」。
【判断】 这条的价值有两层。表层是开发效率:本地就能跑 DynamoDB/S3/SQS 的完整 API,让编码 agent 不必等 region 部署就能自查。深层是它证明了「agent 维护的软件」可以有一套可量化的验收指标——fidelity test 的 k of n 就是让 agent 写的代码可被验收的那个抓手。而它自承不评估 IAM,恰好划出这条路的边界:能被测试覆盖的行为可以交给 agent,无法用测试表达的东西(授权语义)还不可以。
来源:AWS · https://aws.amazon.com/blogs/aws/test-your-applications-against-aws-locally-with-aws-emulator/ · 2026-11-11
4. Codex Security 0.10.0:扫描可以断点续跑,批量扫描有总预算
11-12T02:18Z 发布(npm)。方向很单一:让安全扫描从「一次赌一把」变成可中断、可预算的批处理。
四条实质变更:① 中断的 Standard 扫描可续跑——codex-security scans resume SCAN_ID 从原始 Codex 会话中保存的检查点继续,保留原有的用量与预算;② 批量扫描预算——--max-total-cost 给 bulk / component 扫描设一个跨仓库、跨组件的共享估算预算,含重试与恢复,官方注明进行中的工作可能超出估算;③ 被阻断的补丁有明确下一步——补丁提示会问「是否有文件变更、是什么阻止了修复、下一步该做什么」,当修复依赖 checkout 之外的工作时说明为什么需要外部变更、以及它应该落在哪;④ Standard 扫描初始化重构——从漏洞审计开始,需要时加载宿主特定指令,聚焦调查员各自拿 brief,扫描历史记录 inventory 中的文件数;另外支持导入 ArmorCode 的 SAST 结果到本地工作台,SDK 可把选定的 finding 版本连同保留的证据发布到 Cloud。
升级注意:POSIX 路径经符号链接(如 link/../repo)现在跟随文件系统遍历,要让旧的 bulk campaign 续跑需在 CSV 里填精确保存过的源路径,并用新的输出目录扫描纠正后的物理目标。
【判断】 「resume + 共享预算」把安全扫描的成本模型从「不可预测」变成可规划,这对 CI 里跑扫描是决定性的——以前一次被中断的扫描要重跑全部 token,现在能从检查点接。但要知道它解决的是工程问题不是安全问题:这一版没有一条提升检测率,而本期趋势三引用的 VulnCheck 审计恰恰显示「检出多、修复少」才是真瓶颈,--max-total-cost 只能让账单可控,不能让修复变多。
来源:GitHub · https://github.com/openai/codex-security/releases/tag/npm-v0.10.0 · 2026-11-12
5. 华为 MACaQ:122B 模型 64 分钟、32.5GB 显存完成量化,并可精修现成 GGUF
仓库 huawei-csl/MACaQ(210★ / Apache-2.0 / C++ / 2026-11-10 创建 / 11-12 仍在推送),论文 arXiv 2611.10649。本期最实用的工程工具之一。
核心能力:122B 参数模型量化只需 64 分钟、32.5GB 显存;同等质量下比 MR-GPTQ / DuQuant++ 少 11× 量化时间,或在 Llama-3-8B 上以同样困惑度匹配对方最好成绩。模型无关(model-agnostic),覆盖文本、图像、视频、音频。
四条后端(每个需独立环境,Python 3.12):Diffusers(图像/视频/音频生成,W4A4;图生视频在校准时使用条件图)、llama.cpp(文本,2/3/4-bit GGUF,CPU 也可跑)、vLLM(文本生成与服务,W4A4 或仅权重)、PyTorch(语音生成,W4A4)。列了具体配方:FLUX.2-klein-4B、Wan2.2-TI2V-5B、stable-audio-1.0;Qwen3-4B、Qwen3.8-27B、Qwen3-30B-A3B、Qwen3-Coder-30B-A3B-Instruct、Qwen3.6-35B-A3B、OLMoE-1B-7B。Ascend 侧内核走 CANN PR 提交。
MACaQ-R 是更值得注意的一半:它不重新量化,而是精修已有的标准 GGUF、提升质量并适配自己的负载,同时保持与标准 llama.cpp 兼容。两组官方对照:Qwen3.6-35B-A3B 在同为 22.36GB 下,KL 散度 0.013367(MACaQ-R Q4_K_XL)vs 0.015731(Unsloth UD-Q4_K_XL);Qwen3.8-27B 的 W4A4 困惑度 2.8994 vs BF16 的 2.8463,同时 prefill 2.33×、decode 2.58×。
【判断】 量化工具的竞争点已从「压得更小」变成「同样大小下更准」,MACaQ-R 走的是第三条路:不改体积、改分布。这对已发 GGUF 的模型方尤其有用——不必重新量化整个模型,就能把社区现成权重修好一点。但要清醒:KL 从 0.0157 降到 0.0134 是同体积下的边际改善,不是量级变化;而 2.33×/2.58× 来自 W4A4 而非精修,别把两件事混读。仓库只有 210 星、创建三天,工程成熟度需要观察。
来源:GitHub · https://github.com/huawei-csl/MACaQ · 2026-11-12
三、行业与发展
1. NVIDIA:黄仁勋辞去 CEO,CFO Colette Kress 任临时 CEO,董事会首设主席
11-12 官方 newsroom 发布。这是 11-12 期趋势四「单一关键人物的风险」的直接落点。
更新(首报 11-12):11-12 期趋势四记录的是市场侧事实——《华尔街日报》11-11 报道董事会正准备采取可能导致其离任的行动、当日股价 173.73 美元(+2.87%)、盘后一度跌超 9%,且「NVIDIA 未发正式公告」。本期为公司正式公告落地,人事与治理结构均已明确。
公告要点:黄仁勋已辞去总裁、CEO 及董事会成员职务,即刻生效。Colette Kress(2013 年 9 月加入、现任 EVP 兼 CFO)出任临时 CEO,并在找到正式继任者前同时保留 CFO 职位;董事会已启动内外部并行的正式 CEO 遴选。Harvey C. Jones 获任公司史上首位董事会主席(企业家、科技高管、活跃创投,曾任 Synopsys CEO 与执行主席)。
官方表态:Jones 称 Kress「深度理解我们的业务、客户、运营与财务状况」,并明确「董事会完全信任 Kress 与领导团队,公司运营、客户承诺与产品路线图将不间断继续」;Kress 称「将继续推进让 NVIDIA 成为加速计算与 AI 领导者的事业」,感谢黄仁勋「过去 33 年奠定的基础」。
关键的一句:Q3 FY2027 财报仍按原定于 11-17(周二)约 13:20 PT 发布,电话会 14:00 PT。这条比人事更重要——它把「治理地震」与「业绩披露」隔开了四天。
【判断】 公告未给辞职原因,这是最需要标注的不确定项。可核的部分是治理结构:CEO 与 CFO 由同一人兼任、且是临时的,加上首次设立董事会主席,这是标准的「过渡期双轨」安排——主席管治理与新 CEO 遴选,临时 CEO 管运营。对供应链的实际影响在 11-17 之前无法判断,但两件事可以确定:一是产品路线图在公告中被明确承诺不变(给客户与代工厂的定心丸);二是黄仁勋是这家公司对外定价叙事本身,他被移出后市场需要重新学习如何给 NVIDIA 定价——这解释了 11-12 期记录的盘后跌幅为何那么大。理性做法是等 11-17 的财报与管理层指引,而不是在公告措辞里找原因。
来源:NVIDIA · https://nvidianews.nvidia.com/news/nvidia-announces-ceo-transition · 2026-11-12
2. Anthropic《支持地区政策》11-12 生效:准入从「人在哪」穿透到「股权被谁控制」
政策页 anthropic.com/legal/supported-regions,Effective Nov 12, 2026,适用所有用户。本期最重要的一条合规变化。
三类不合格,逐层向上穿透:① 人实际身处不受支持地区——原文明确包含「otherwise supported entities 的用户与人员」,即公司合规、人不在合规地区也不行;② 实体在不支持地区注册成立或设有总部——该实体的用户与人员无论本人是否身处支持地区均被禁止;③ 被不支持地区的个人或实体直接或间接多数持股或控制——同样穿透,不因用户个人位置合规而豁免。政策并声明「任何未列出的国家或地区均不受支持」,所列国家的属地与附属地一并视为支持(举例:波多黎各作为美国属地)。
覆盖范围:应用(明确点名 Claude.ai、Claude Code、Cowork)、API 与开发者平台、以及通过云平台与授权经销商提供的 Claude 模型。清单 170 余个国家和地区;乌克兰列入但排除克里米亚、顿涅茨克、赫尔松、卢甘斯克、扎波罗热五个地区。文件提供 PDF 并有版本历史入口。
渠道侧只有一句:授权经销商仅作为交付渠道被纳入适用范围,政策未定义「授权经销商」认定标准,也没有再分销、转售许可、渠道合规义务等独立条款——效果是经第三方渠道买的 Claude 同样受地域限制约束。
【判断】 这是前沿实验室第一次把出口管制的穿透式股权标准写进通用服务条款。以前 ToS 管「你在哪用」,现在管到「谁拥有你用的那家公司」。技术后果很具体:一个新加坡注册、由不合规地区主体多数持股的子公司,即使员工全在合规地区、走的是云平台上的 Claude,也属于违规使用——而云平台的计费与合同关系并不提供豁免(政策把云平台与经销商一起纳入范围)。对做跨境交付的团队,这条比任何模型发布都更需要现在处理:要核的不是自己的办公地点,是自己的股权链。政策没给过渡期与既有合同处理方式,这是当前最大的不确定项。
来源:Anthropic · https://www.anthropic.com/legal/supported-regions · 2026-11-12
3. Infor × Anthropic:MCP 连接器进制造业,Claude 可以直接改产线与下单
11-12 12:02 ET 由 PRNewswire 发布。这是「MCP 从开发者玩具变成企业采购项」的一个明确样本。
产品:Infor Industry AI for Claude,通过新的 plugin 与 connector 交付,面向生产计划员、采购、客服等角色。用户可以在 Infor 里也可以在 Claude 里工作,用自然语言提问、看 Infor 系统的数据与洞察、并执行建议的动作;Infor 的行业逻辑、流程控制与治理护栏一并提供给 Claude。
可执行的动作(需用户逐次批准):创建采购订单、把库存重新分配给紧急订单、在非计划停机后切换产线、发货。典型场景:计划员问「为什么这张生产订单有风险」,看到原因是缺料/产能不足/缺人,并在 Claude 里直接启动纠正;客服查可用量、仓库位置与生产选项,在客户还在线上时催单或确认交期;采购看迟到收货会影响哪些订单、找替代供应商、下补货单。
治理怎么落地:沿用 Infor 现有的 SSO 与基于角色的权限决定每个人能看什么、能做什么;经连接器的动作受授权控制并记录在 Infor 中;每次变更都要用户显式批准(官方 FAQ 明确 Claude 不会未经批准做决定)。行业语义由 Infor 一次性配置给全公司,例如把 item / SKU / product 认作同一件事,连接器识别用户身份因而响应按角色与站点区分。
开放性:连接器构建在开放的 Model Context Protocol 标准上,可与其它兼容工具协同而不必离开 Claude。
可用性:现已面向部分 Infor Velocity Suite 客户;客户需自备 Claude 许可证,管理员需激活 Infor 连接器;Infor 计划逐步增加角色、技能与应用。
【判断】 关键不是「制造业也能用 Claude」,而是权限体系的归属:SSO 与 RBAC 来自 Infor、动作记录留在 Infor、Claude 只是前端。这是企业级 agent 唯一可行的形态——AI 厂商不成为权限的真相来源。但也正因如此,「Claude 能改产线」的实际风险完全落在 Infor 的角色配置上:如果某个计划员在 Infor 里本来就有改产线权限,那么他现在可以用自然语言、在几秒内改完。自然语言把「有权限」和「已行使权限」之间的距离压到了接近零,这是所有企业 agent 落地时最该重新评估的地方,而新闻稿里只有一句「每次变更需批准」。
来源:PRNewswire(Infor) · https://www.prnewswire.com/news-releases/infor-and-anthropic-announce-partnership-that-turns-insights-into-actions-for-manufacturing-operations-302938160.html · 2026-11-12
4. OpenAI 在印度开本地推理:先支持 GPT-6 Luna,区域端点对较新模型加收 10%
11-12 报道。一手 openai.com 在本机 403,故以 The Hindu 报道为出处(含 OpenAI 印度负责人 Nitin Bawankule 的说法)。
变更内容:企业现在可以让 AI 请求在印度境内处理。首批支持的模型是 GPT-6 Luna,经 Responses API 与 Chat Completions 提供;企业在新建 API project 时同时选择印度作为存储与处理区域即可启用。这套机制沿用 OpenAI 此前在日本落地的模式:日本自 11-11 起本地推理需启用零数据保留(ZDR)且仅限按量付费,且区域端点对 2026-03-05 之后发布的模型加收 10%。
【判断】 「数据驻留」正在从大客户定制变成标准 SKU,这是本季度最清晰的一条企业采购趋势(11-12 期已记录 Google、微软的同类动作)。两个细节值得记:一是只对较新模型加收 10%,说明区域部署成本与模型版本绑定,老模型走区域端点不加价——这会扭曲企业的模型升级决策;二是日本要求 ZDR 而印度报道未提,两地条款是否一致目前无法确认,属合规团队必须逐条核对的地方。对做跨境 SaaS 的团队,「区域端点 + 加价 + 附加条款」的组合会直接改变毛利结构,值得在架构里预留「同一模型按区域切换端点」的开关。
来源:The Hindu · https://www.thehindu.com/business/openai-now-allows-enterprises-to-process-ai-requests-within-india/article71692799.ece · 2026-11-12
5. 澳大利亚阿德莱德 1200MW 数据中心暂停:几周内第三个受阻项目
11-12 16:44 财联社报道。这条是「反数据中心」从美国蔓延到全球的可核证据。
事实:澳大利亚数据中心开发商 Quantum DC Pty Ltd 周四表示,已暂停在南澳大利亚州 Tungkillo 的1200 兆瓦超大规模数据中心的规划审批程序,今年不会提交开发申请。公司声明称「部分社区成员对该项目存在重大担忧」,集中在选址、水资源的使用与供应、能源基础设施、以及对农田的影响。这是近几周该国至少第三个受阻的数据中心项目:Nextdc 因民众反对导致墨尔本一个重大项目延期,其 CEO Craig Scroggie 本周承诺把社区利益放在首位;地产开发商 Stockland 在遭遇类似抵制后放弃了悉尼的数据中心计划。
背景:报道同时引述特朗普此前的表态,称反对 AI 基建的社区「最终想要的是落后与贫穷」,并喊出「Let Data Reign」。
【判断】 1200MW 不是小项目——它相当于一座大型机组的装机。把它与「水资源、农田、能源基础设施」这三条具体理由放在一起,可以看出反对焦点已从「噪音与景观」转向资源竞争:在干旱地区,数据中心冷却用水与农业用水是零和的。这对算力供给建模意味着一个新变量:并网许可与社区同意正在成为与芯片供应同等级的约束,而它无法用资本解决。11-12 期趋势三写的「瓶颈从芯片转向电、交付和旧资产」在这里得到具体印证,且时间尺度更短——不是 2027,是「今年不会提交申请」。
来源:财联社 · https://www.cls.cn/detail/2532729 · 2026-11-12
四、论文与开源
口径:本期 9 篇均于 2026-11-10 提交(逐篇回查
arxiv.org/abs/确认Submitted on 10 Nov 2026),与 11-12 期已收录的 8 篇无重叠。cs.AI的 11-11 公告批次已上线但提交日为 11-10,11-12 提交批次尚未进入索引,故第 8 条为两篇短评合并。
1. 2611.13412 前缀缓存的 agent 服务存在「亚稳态」:一次突发能让服务器卡死 70 分钟
标题:Bursts That Outlast Themselves: Persistent Degradation in Prefix-Cached Agent Serving
问题:agent 是闭环会话,上下文每轮增长,经济性完全依赖前缀缓存——命中时只需约 1,000 token 的增量 prefill,未命中则要重算 10–40K token。作者指出这使服务进入亚稳态。
关键结果:同一个基础负载,只多加几分钟的额外到达,一台 vLLM 服务器就会停在退化状态——命中率约 10%、吞吐约减半、积压持续增长 70 分钟;而它的「无突发孪生」保持健康。12 对里 9 对复现,反方向 0 例。这个状态出现在缓存已预热的服务器本可承受的负载上,在不启用前缀缓存时不存在,在 Qwen3-32B + SWE-bench agent trace 形态上、在 SGLang 上也复现(SGLang 能容忍更大的触发)。
机制(作者给的因果链):服务变慢 → 系统里驻留的会话更多 → 工作集超出 KV 池 → 每一轮都变成重算。作者用一个独立标定的一阶负载均衡条件框住了「这个状态何时能自行排空」。
最难的是怎么出来:限制新会话准入只在 7 次匹配的崩塌中救回 1 次;而按容量上限挂起已接纳的会话,7 次全部在数分钟内恢复。CPU offload 层只延后崩塌、不能阻止。作者另提出一个「把活跃会话的常驻 KV 需求限制在预算内」的 budgeter(摘要在此被截断,完整做法需读原文)。
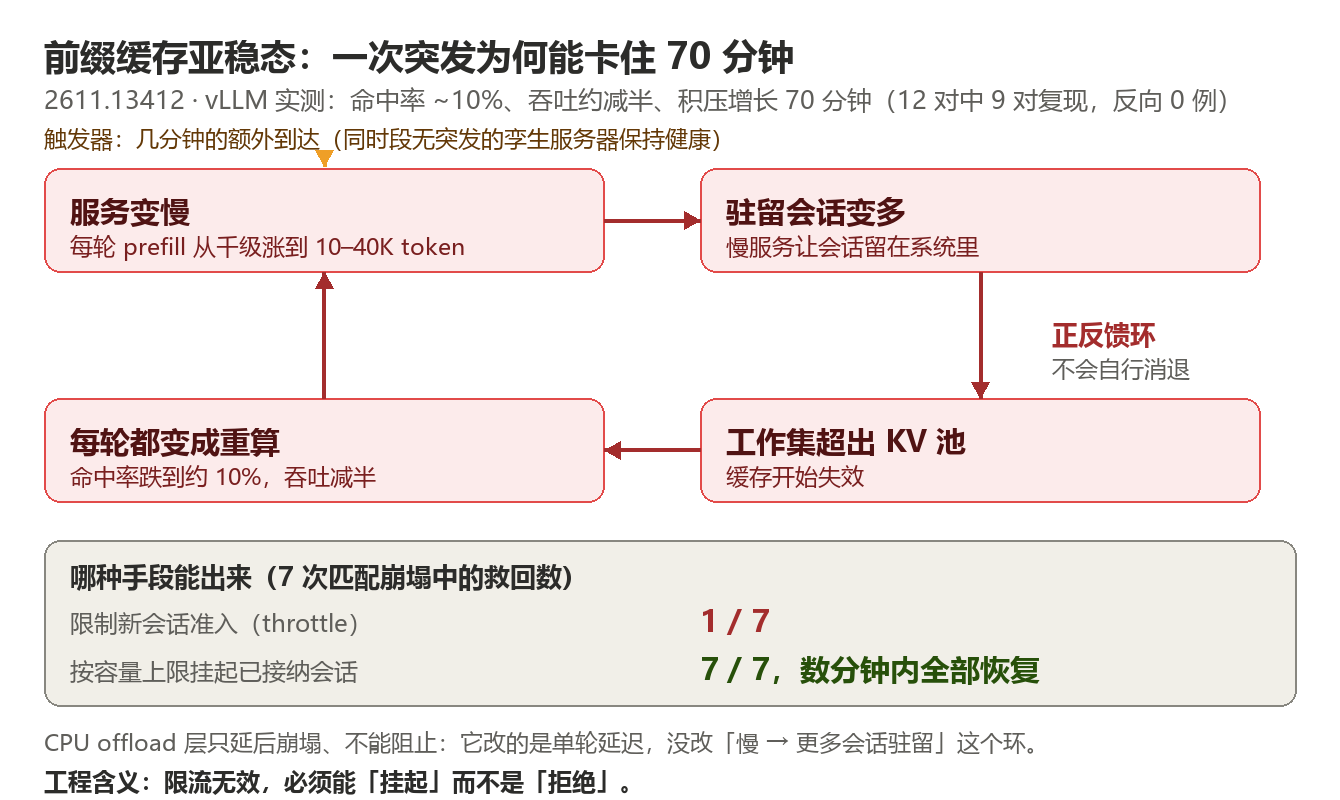
【判断】 这是本期工程价值最高的一篇,因为它解释了一个很多人遇到过但归因错了的现象:agent 服务「突然整体变慢、重启才恢复」通常被归因为内存泄漏或 GC,实际是缓存命中率与并发度之间的正反馈。可操作的两条:① 限流(throttle 新请求)无效,因为问题不在入口而在已接纳会话的常驻量;② 要有能力挂起而非拒绝。这也解释了为什么 CPU offload 救不了——它改的是单轮延迟,没改「慢 → 更多会话驻留」这个环。凡做 agent 平台、且有长会话的团队都该按这篇的复现方法做一次压测。
来源:arXiv · https://arxiv.org/abs/2611.13412 · 2026-11-10
2. 2611.14654 世界还留着错误时,清理 agent 历史反而有害
标题:Cleaning an Agent's History Hurts When the World Still Holds the Error
问题:用工具的语言模型 agent 会积累自己的错误历史;一个做 compact、修复或交接的系统,实际上是在决定「这些错误要不要留在记录里、以什么形式留」——而错误的后果还留在世界里。已有工作都在「世界固定」的前提下清理历史,那时「展示正确的步骤」与「宣布它已完成」是同一件事。本文问:同样的正确内容,会不会因为表述方式和世界状态不同而产生相反效果?
方法:把 agent 冻结在任务中途、连同精确的世界状态,然后编辑历史或世界,让接收模型继续。
结果 1(AgentCE-Bench):在 agent 提交了错误数值后,固定世界不变,用两种自然编辑加入正确值——① 在保留的错误旁边加一条如实备注;② 写成该 agent 自己完成的动作。备注把恢复率从 matched neutral note 的 51% 提到 66%;而**「已完成动作」把它压到 44%,低于未编辑历史的 50%**。也就是说,正确值出现与否不能预测效果,表述形式才是决定项。
结果 2(AppWorld):数据库写入后,改变回执报告「成功/失败」以及效果是否真实存在。效果缺失时,成功回执把整任务成功率从 45% 压到 28%;效果存在时,它把成功率从 38% 提到 49%。两个方向合计差 27 个百分点(两个接收模型汇总)。
【判断】 这篇推翻了一个工程上很常见的直觉:以为「历史里写清楚正确做法」就够了。真正的变量是回执与世界的匹配——一个报成功但世界没变的回执,比不写更糟。对做 agent 记忆压缩、上下文修复、跨 agent 交接的人,这是直接的规格变更:压缩时必须同时记录动作的意图与世界的校验结果,且绝不能把「打算做」写成「已做完」。方法论也很干净——冻结世界、只改一个变量、看接收方行为变化,这类实验以前很少有人做。
来源:arXiv · https://arxiv.org/abs/2611.14654 · 2026-11-10
3. 2611.13541 agent benchmark 的饱和大多是测量造成的,不是任务不够难
问题:数据科学与 ML 工程 agent 的 benchmark(MLE-bench、ALE-Bench、SWE-fficiency、AlgoTune)产出的是一个量(Kaggle 指标、竞赛分数、加速比)。当它不再能区分最好的模型,通常的补救是「做更难的版本」。本文重新打分 8 个 benchmark 已发布的 run(含 SWE-bench Verified 与 Terminal-Bench 以扩展广度),发现饱和的大部分在测量里,不在任务里。
两种失效:① 太粗——多数 agent benchmark 把一次 run 压成一个 pass/fail 位;SWE-bench Verified 上前十名彼此的差距小于其测试本身的误差,修正后重排邻位的幅度不超过随机删掉每个 agent 六分之一通过项。② 被参考值封顶——ALE-Bench 按竞赛分数排的前十,在对着人类中位数评分时全部打平,尽管近一半的 run 其实超过了那个人类中位数。
解:作者推导了一个 clipped log-ratio 分数,配带日期的锚点,并把成本作为独立轴。在 Terminal-Bench 的重跑里,pass/fail 判定打平的模型在「被测试丢掉的那个量」上相差十倍以上。
【判断】 「换个更难的 benchmark」是这半年最常见的回应,而这篇指出那只是把问题往后移——只要打分仍是二值,新 benchmark 也会在半年后同样饱和。真正可操作的是两步:把测试误差算进排名(做一次重排稳定性检验),以及把成本单列。十倍这个数字很有说服力:它意味着现在的榜单在关键维度上是失明的。对评测机构的启示是,报告误差条应成为硬性要求,而不是可选的严谨性加分。
来源:arXiv · https://arxiv.org/abs/2611.13541 · 2026-11-10
4. 2611.13548 巨型激活在干扰稀疏自编码器:把 PC1 摘出来再补回去
问题:SAE 常用两个指标评估——解释方差与消融损伤。作者指出巨型激活(massive activations)同时破坏了这两个指标,并给出修正。
机制:巨型激活使最多 99.9% 的激活方差落在第一主成分(PC1)上。PC1 分量没有唯一的稀疏分解,每次 SAE 训练都从不同的特征集合重建它,而这些特征主导重要性排名:最关键的 50 个特征里平均 47 个在另一次运行中不匹配,而随机取 50 个的基线是约 27 个。同时,一个字典可以报告 99.96% 的方差解释,却把 PC1 之外的 33% 方差留在未解释里。
修正:在去掉 PC1 的激活上训练 SAE,再在重建时把 PC1 加回去。在受影响的模型上,top-50 特征共享率从 4–39.5% 提升到 73–99.5%;同样 TopK 稀疏度下,对模型的退化最多减少 44%,内容重建误差最多降低 33.9%。
【判断】 这不是「又一个 SAE 改进」,而是一个评估方法的系统性缺陷:过去两年大量「SAE 找到了可解释特征」的结论,其稳定性可能主要来自 PC1 这个共享的、无稀疏结构的成分。73–99.5% 的共享率提升意味着修正后不同运行才真的在找同一批特征。对可解释性研究的直接影响是:任何报告 top-k 特征重要性的工作,都应先声明是否处理了 PC1,否则跨研究对比无效。这也间接支持了本期 Hydrogen 那种「20 万审计轮 + CoT 可读性 99.9%」的行为侧验证路线——机制侧的指标本身还没稳。
来源:arXiv · https://arxiv.org/abs/2611.13548 · 2026-11-10
5. 2611.13442 并行投机解码:高负载下 draft 吃掉 40% 的 step 时间,多数被丢弃
问题:并行 drafter 一次前向提出整块 draft token,因此在服务里很有吸引力。近期系统优化的是 goodput(每秒被接受 token 数),因为被拒的 draft 会偷走其它请求的算力。但这些系统只能控制「验证多少 token」,每个请求仍会 draft 满一整块。作者发现高负载下 drafting 占 step 时间最多 40%,其中大部分因从未被验证而被丢弃。而自回归 drafter 那套「按需截断 draft 长度」无法直接搬过来,因为并行 drafter 在单次前向之前就已承诺长度;且 draft 与验证长度在 batch 内耦合,必须为每个请求联合选择,同时保证每步决策足够便宜。
方法(WCS,原型 ForeSpark):① 上下文感知的预草稿估计器——用目标模型的上下文特征预测每个候选长度的接受率;② 轻量联合 draft-verify 调度器——通过一次全局排序同时选出两个长度;③ 后置预算分配——把验证预算花在最值得的地方。
【判断】 这是「投机解码的成本该由谁承担」的一个正确提法:过去把 draft 当免费,实际在饱和负载下 draft 是最贵的那部分(40% 的 step 时间)。全局排序这个设计也务实——它把跨请求的耦合显式化,而不是靠启发式。但要注意这是原型阶段的结果,摘要未给端到端吞吐数字,落地价值取决于估计器的额外开销是否真的「够便宜」。
来源:arXiv · https://arxiv.org/abs/2611.13442 · 2026-11-10
6. 2611.13960 ActiveSecHarness:把智能与权限分开,用 12.7 微秒的确定性守卫替代 LLM 裁判
问题:AI 编码 harness 把模型接到 shell、文件系统与网络套接字上,harness 本身就成了自动化的 Living-off-the-Land 平台——一旦对手把指令注入检索内容,bash、curl、find 这些双用途二进制就是 payload。作者主张:agent 系统的安全是认知架构与权限组合的结构性属性,不是单个模型的涌现属性。静态正则黑名单会漏掉结构性绕过;LLM-as-a-Judge 护栏延迟高、且过度拦截良性工作。
架构(Separation of Intelligence and Authority):① Macaroon 式 HMAC 能力令牌贯穿四个 Trust and Authority Ring;② 二维乘积污点格 L = L_trust × L_sens 加工作区来源账本,防止密钥在磁盘上被「洗白」;③ Ring-0 确定性 OS/工具守卫;④ 字节码证书、分视野审计日志、自愈式安全测试合成、自适应 UserWikiManager。
结果:252 个 fixture(120 攻击 / 120 良性 / 12 kill chain)。一个本地实时 LLM 判定器(qwen3:4b)拒绝 98.3% 的良性工作、延迟 142.3ms;而 Ring 0 达到 ABR = 1.000、FPR = 0.000,延迟 12.7 微秒(快 11,200×)。
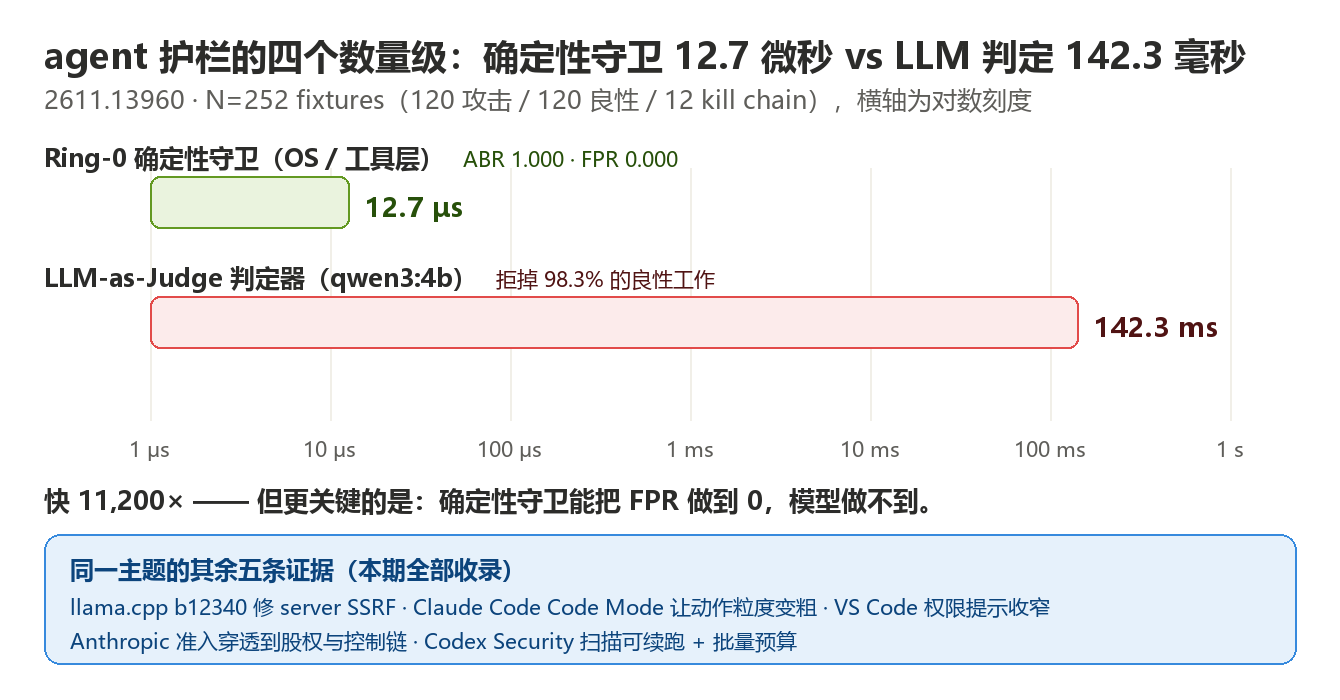
【判断】 这组数字最刺眼的是 98.3%:一个 LLM 判定器把几乎全部正常工作都拒了——这正是「用模型管模型」这条路的根本问题,它把可用性当成了安全的代价,而且代价大到不可用。12.7 微秒对 142.3 毫秒是四个数量级的差距,说明权限检查应该发生在确定性代码里,而不是模型里。这与本期的 VS Code 权限提示收窄、Code Mode 的动作粒度变粗、llama.cpp 的 SSRF 修复是同一个主题:agent 的安全边界必须建在模型之外。局限也要说:252 个 fixture 规模有限,且确定性守卫的能力上限取决于它能表达多少策略——表达能力不足时会退化成白名单。
来源:arXiv · https://arxiv.org/abs/2611.13960 · 2026-11-10
7. 2611.14514 Contrastive Discovery:用一个「竞争解释集合」取代单个假设
问题:LLM agent 越来越多用于开放式、数据驱动的科学发现,但多数 agent 逐点评估假设——只把经验命题 h 与它的补 ¬h 对比。当证据否定了 h,agent 只知道「有一个解释不太可能」,不知道证据支持的是哪个替代解释。
方法:用 contrast set 取代单个假设——一个科学问题配一组互斥且穷尽的竞争解释。每个实验按其证据在集合上重新分配信念的程度打分,当信念集中到某一个解释时问题即被解决。因为 contrast set 只改变 agent 提出与打分的单位,现有 agent 可直接用它重估已收集的证据或指导搜索。
结果(六个领域):89% 的「最大信念位移」点式候选是拒绝;在同一批证据上,contrast set 把其中 73% 定位到具体替代解释。当 contrast set 指导搜索时,同样实验预算下多解决 67% 的问题。盲测中 38 位人类专家在已解决的问题上一致率 78%,在「点式 agent 否定了自己的假设就停下」的那些问题上一致率 82%。
【判断】 这篇的贡献是把科学方法里最容易被工程化忽略的一步——排他性——变成可计算的目标。67% 的解问题数提升是在同样实验预算下取得的,这点很关键:不是靠更多算力,是靠把每次实验的信息量用满。对做 AI for Science 的团队,这是可直接实现的改动(改提出与打分的单位),不需要重训模型。89% 这个数字也值得注意——它说明在点式范式下绝大多数「重大证据」最后只产出否定结论,浪费严重。
来源:arXiv · https://arxiv.org/abs/2611.14514 · 2026-11-10
8. 2611.14704 用「能跑的程序」代替自由文本解释,与 2611.13873 给 CoT 可监控性列披露清单
2611.14704 Code as Explanations:理解 LLM 行为需要在多个输入上观察它,但 CoT 这类自由文本解释是逐实例生成、无法在新输入上验证。作者提出代码解释——一个程序解释模型在一个数据集上的行为,执行即可自动验证。定义 Consistency 指标(程序复现模型输出的输入占比)用于评估与选择候选程序。在三个开源代码能力模型、八个任务上:模型在若干设定下能产出高度一致的代码解释,代码解释比 CoT 短 6×–100×,并在 24 个设定中的 9 个更贴合模型行为。但在语言成分更复杂的任务上一致性显著下降,生成程序复现输出的频率不高于无信息基线,且这些程序常依赖更长的硬编码模式。与 Claude Opus 5.5 的实验里,给模型一致性反馈与代码执行能提升解释一致性,但仍有限。
2611.13873 CoT 可监控性:CoT 监控是监控先进 AI 系统最有价值的工具之一,但它正受威胁。作者主张前沿开发者披露五个指标(对应 CoT 监控依赖的五步链,每步一个):第三方 CoT 访问与基础架构规格(这一项也是其余各项外部验证的基础),以及 CoT 质量(自然性与忠实性)和监控有效性(检测与 uplift)。对 Anthropic、OpenAI、Google DeepMind 现有披露的审计显示:没有任何一家覆盖完整集合,但每个指标都至少有一家披露过。由于当前披露主要依赖开发者自评,作者建议由嵌入式评估者或独立验证组织(IVO)在比公开披露更深的访问权限下重做一次跨开发者审计。
【判断】 两篇合起来说明同一件事:解释性正在从「写得像那么回事」转向「可被机械验证」。代码解释的好处是能被自动检验(Consistency),坏处是遇到语言类任务就退化成硬编码;CoT 指标的好处是能跨厂商对比,坏处是全靠自评。第 8 条那个审计结果——无一家覆盖全集、但每项都有人报过——其实不算坏:联盟式相互补位已经形成,缺的是统一的验证方。这也是本期趋势二「安全边界建在模型之外」在测量层面的对应物。
来源:arXiv · https://arxiv.org/abs/2611.14704 · https://arxiv.org/abs/2611.13873 · 2026-11-10
9. A2UI 1.0:把 UI 当数据而非代码,六个原生渲染器
a2ui.org/specification/v1.0-a2ui/ 已可访问(11-12 实测 200),仓库 a2ui-project/a2ui(17,217★ / 1,394 forks / Apache-2.0 / TypeScript / 2025-09-24 创建 / 11-13 01:35Z 仍在推送)。
是什么:开源生成式 UI 框架——agent 流式输出布局数据,应用用原生组件渲染,覆盖 React、Angular、Lit、Flutter、SwiftUI、Jetpack Compose 六个渲染器。协议以数据而非代码表达 UI,用 strict schema 约束 agent 的能力边界。
版本节奏:cli-v0.3.0(11-11T01:57Z)、a2ui-core 0.6.0 / a2ui-agent-sdk 0.11.0 / a2ui-adk 0.3.0 / a2ui-a2a 0.3.0(均 11-10T22:15Z)。相比 11-02 的 core 0.5.0 / agent-sdk 0.10.0 是一次 minor 跳版。
【判断】 「UI as data」这个选择的价值不在渲染,在安全与可审计:agent 不能往你的应用里塞任意代码,只能提交符合 schema 的布局描述,渲染边界由客户端决定。这与 ActiveSecHarness 的思路完全一致——把授权放在确定性的一侧。四天里五个包连发也说明它在快速收敛;但 0.x 的 SDK 版本号意味着 API 还会动,现在接入要接受重写成本。
来源:A2UI · https://a2ui.org/specification/v1.0-a2ui/ · 2026-11-12
五、值得关注的趋势
1. 「执行模型」与「裁决模型」开始分档定价,中间的差价由编排器吃掉
本期最结构性的一条。Google 在同一天给出三件东西:Hydrogen 以 $1.50/$7.50 提供 1M 上下文与 Terminal-Bench 4.1 的 57%;Carbon/Argon 以 1.33 倍(11-30 后 2.67 倍)的价格提供判断力;Antigravity Orchestrator 在同一会话里动态切换,配额少 24%、完成快 19%、成功率接近 Carbon。
把它与 11-12 期记录的 Gemini Decisions API 放在一起看,脉络很清楚:Google 在一个月内做了两次「把推理拆开卖」的动作——先是把判定从生成里拆出来(输出不计费),现在把执行从推理里拆出来(便宜 25%,11-30 后便宜 62.5%)。两次的共同点是:都不是模型能力提升,是计价单位与调用结构的重新划分。
【判断】 对做 agent 的团队,这意味着「选一个最强模型跑完全程」在成本上已是最差解。可操作顺序是:先按步骤分类(规划/裁决 vs 执行/校验),再给两类配不同价位,最后才考虑具体型号。但要意识到风险:当厂商自己在产品层提供编排器,应用层做同样的事就变成了重复劳动——这是平台方挤压中间层的老剧本,只是这次挤的是 agent 框架的路由逻辑。
2. agent 的安全边界正从「模型对齐」转移到「权限组合与状态」
本期有六条独立证据指向同一方向:
| 证据 | 指向 |
|---|---|
2611.13960 Ring-0 守卫 12.7μs / ABR 1.000 / FPR 0.000,LLM 判定器 142.3ms 且拒掉 98.3% 良性工作 |
权限检查必须确定性执行,不能交给模型 |
| llama.cpp b12340 修 server SSRF(CORS proxy 与媒体 URL) | 模型服务本身是被攻击面 |
| Claude Code Code Mode:一段 JS 里藏多次工具调用 | 动作粒度变粗,按动作设计的控制失效 |
| VS Code 权限提示从会话级收窄到域名/目录级 | 过度授权是主要入口 |
| Anthropic 地区政策穿透到股权与控制链 | 准入的判定对象从「人」变成「实体」 |
| AWS Emulator 不评估 IAM 策略并明示「别用它测安全」 | 授权语义无法用测试表达,agent 维护的软件有明确边界 |
【判断】 这六条没有一条在讲「让模型更安全」,全部在讲把安全搬到模型之外。原因很实际:模型侧的改进(Hydrogen 报的越权 −81%、走捷径 −12×)是概率性的、厂商自测的、无法审计的;而权限、沙箱、签名后的能力令牌是可验证的。下一年的 agent 安全预算会从「对齐研究」更多流向「权限工程」,而目前最缺的不是工具,是规格——Code Mode 的文档还没上线就已发版,就是这种规格缺位的直接体现。
3. 「每一个 AI 基础设施数字都要打折」正在成为共识
三条独立数据:
- VulnCheck 对 Anthropic Glasswing 七个月审计(11-09,Patrick Garrity,窗口前,仅作旁证):442 个 CVE(占全年 93,450 的 0.5%),仅 2 个在野利用(0.45%);37,966 findings / 7,349 公开(19.4%)/ 仅 217 修复;两个月新增 11,813 findings 只多 15 个修复。自报 TPR 从 90.8% 升到 94.2%,但 curl 收到的 45 份报告里,已公开的 34 份中 19 份「不是漏洞」、6 份低危、9 份待评(假阳 55.9%);Claude 自评 91.5% 高危,维护者只认 51.3%。
- Bernstein 的数据中心可信度模型(数据截至 2026-10-11,11-12 经二手媒体扩散,属背景非新闻):北美 8,858 个项目 / 586GW 中仅 199GW(34%) 可信,387GW 是「Bragawatts」;四重过滤为开发阶段 −198GW、租户质量 −113GW、开发商记录 −48GW、州监管 −28GW;超大规模与老牌占可信容量 76%,跨界与 neocloud 宣布过半但落地率 11%。
2611.13541:agent benchmark 的饱和大部分在测量里,pass/fail 打平的模型在丢弃的量上差十倍以上。
【判断】 三件事的共同结构是:官方数字的口径与实际可交付量之间存在系统性偏差,且方向一致(都是高估)。0.5% 的 CVE 占比、34% 的可信容量、十倍的隐藏差距——这些不是「宣传夸大」,而是指标本身选错了对象(findings 不等于漏洞、宣布容量不等于并网容量、pass/fail 不等于能力)。实用做法是把任何 AI 基础设施数字当上界读,并养成追问三个问题的习惯:这个数字是「宣布」还是「并网/合并」?是「发现」还是「修复」?是「厂商自测」还是「独立复现」?
六、有趣的 AI 开源项目
1. rivet-dev/open-orange — 把 Cloudflare Workers 原样搬到 AWS / GCP / Azure / 自有服务器
237★ / Apache-2.0 / TypeScript / 2026-11-12 创建,v1.0.0 于 11-12T12:16Z、v1.0.1 于 11-12T17:06Z 发布。
做什么:让你现有的 Cloudflare Workers 项目不改一行代码跑在 AWS、Google Cloud、Azure 或自己的服务器上,包括 Durable Objects。四个设计目标写得很直白:零重构、零停机迁移(数据在应用继续服务的同时搬离 Cloudflare)、同样的开发体验(wrangler dev 变成 orange dev)、更简单的账单(官方称计算便宜 4.8×、存储便宜 8.7×)、为扩展而建(存储后端是 S3,扩容等于加机器)。需要 Node.js 22+ 与 pnpm,部署需 Docker。
有意思的细节:README 里直接给了一段可粘进编码 agent(Claude Code、Codex、Cursor)的提示词,让 agent 自己加 Rivet MCP、登录、然后按 quickstart 部署——把「安装文档」写成了给 agent 的指令。
【判断】 这不是 AI 项目,但它服务的是 AI 应用最常见的部署路径(很多 agent 后端就跑在 Workers 上)。真正的问题是它把「平台锁定」变成了可逆选择——这对被 egress 与 CPU 时长账单困住的团队是实际出路。但要核两件事:Durable Objects 的一致性语义在 S3 后端上能保到什么程度,以及 4.8×/8.7× 是与哪个档位比的(README 未说明)。v1.0.0 到 v1.0.1 只隔五小时,成熟度还很早期。
来源:GitHub · https://github.com/rivet-dev/open-orange · 2026-11-12
2. alexeyw/lot-map — 在对话框旁边给 Claude Code 画一张「工作地图」
612★ / 72 forks / MIT / TypeScript / 2026-11-09 创建 / 11-12T23:58Z 推送。
做什么:一个 Claude Code 的 mod(/plugin install lot-map --marketplace alexeyw/lot-map 安装),在对话旁边的面板里实时显示 agent 在干什么:每次工具调用、每个模型步、hook、skill,都从中心向对应「站点」发一道脉冲。
站点划分得很讲究:You(你的消息与发给你的文件)、Model(每次模型请求、上下文压缩)、Memory(记忆目录及选项里指定的路径)、Files(Read/Write/Edit/Grep/Glob,以及只对文件操作的 shell 命令:cat、grep、mv、rm、sed、tee、find … -delete)、Shell(其余 shell 命令)、Network(web fetch/search、MCP server,以及已知会联网的 shell 命令 curl、gh、ssh、git push、npm install、docker pull,包括写在 $(…) 里的)、Browser、Agents(subagent 与 workflow,它们自己的调用从该站点出发)、Skills、Hooks(拒绝调用、请求权限、添加上下文或耗时的 settings hook)。
纯本地,支持 7 种语言;终端需至少 144 列,否则用 /lot-map 命令,且默认只画文字、要图片需显式请求。基于 Claude Code 2.1.321 构建与测试。
【判断】 它解决的是一个真实痛点:agent 跑长任务时,终端里滚动的是一串工具调用日志,你看不出它在「读文件」还是「在联网」还是「在等权限」。把这种区分做成空间化站点,比日志更接近人的心智模型。Files / Shell / Network 三分法尤其有价值——它恰好对应三种不同的风险等级,等于给 agent 的每个动作贴了一个风险标签。放在本期语境里,这是 Code Mode 时代最需要的那类工具:动作粒度变粗之后,可视化是恢复可审计性的第一步。
来源:GitHub · https://github.com/alexeyw/lot-map · 2026-11-12
3. agentes-chat/agentes-chat — 开源自托管的 Slack 替代,agent 是频道里的正式成员
1,187★ / 185 forks / AGPL-3.0 / TypeScript / 2026-11-09 创建 / 11-13T01:40Z 推送。
做什么:开源的、可自托管的 Slack 替代品,团队与 AI agent 在频道和私信里一起工作。agent 不是侧边栏机器人,而是工作区成员——有角色、有 owner、有预算,在所有人看得见的地方干活,敏感操作前要先问。
关键设计:① 安全默认——合并、部署、以及任何被连接器标记为敏感的操作,都要在聊天里等一个真人批准;每次模型调用都按 agent 计预算并留记录。② agent 真能干活——有自己的计算机、有可被观看并可接管的真实浏览器、能跑 Claude Code 与 Codex、支持按日程或事件触发的 routine、有会学习的记忆(从纠正与被拒绝的批准中学习,并提议修改自己的指令供人接受)。③ 模型可选——Claude、ChatGPT/Codex、Gemini、Grok 或任意 OpenRouter 模型,也可选 DeepSeek、Kimi、Z.ai、MiniMax。④ MCP 按组织配一次,每个 agent 只拿被授予的 scope;接 Composio key 可连 Drive、Calendar、Sheets、Docs、Slack、Teams、HubSpot、Salesforce、Zendesk、Asana、Figma、Notion、Stripe 等。⑤ 部署极简——Linux 一条命令,依赖只有 Postgres(带 pgvector),私域 HTTPS 走 Tailscale,公网走 Caddy;另有不依赖 Docker 的 agentes-server。
【判断】 最值得看的不是功能清单,是它把**「预算」与「审批」做成了 agent 的一等属性**:每个 agent 有月度预算、每次调用前检查,超出与被拒都会通知 owner。这恰好回应本期趋势二——当权限检查被搬到模型之外,「谁花了多少钱、谁批了什么」就成了必须显式建模的数据。AGPL-3.0 对商业使用是硬约束(SaaS 化要开源),自托管场景不受影响。风险在规模:1,187 星、创建四天,而 Slack 替代品是极难做全的产品(通知、搜索、权限、移动端),README 里标 Beta 的功能已经不少。
来源:GitHub · https://github.com/agentes-chat/agentes-chat · 2026-11-13
⚠️ 待核实
| 项 | 不确定点 |
|---|---|
| Claude Meetings | 二手报道称 11-10 发布 Team/Enterprise beta、仅支持 Google Meet、Claude 以可见参与者身份加入并自我声明、外部访客加入时自动退出。本期复查 anthropic.com/news 列表页,meetings 关键词命中 0 次;claude.com/product/claude-meetings、/news/claude-meetings、support.claude.com 相关页全部 404。连续两期无法回溯,本期不再列为候选 |
| 微软研究院 Lazarus | 二手(ITPro、techtimes、geroundtable、ainewstodays)转述的「复活已废弃模型」研究,一手博文 microsoft.com/en-us/research/blog/lazarus/ 返回 404。缺一手 URL,不入正文 |
| 智谱「启动 IPO」 | 微信公众号 digest 称智谱启动 IPO,与事实冲突:智谱已于 2026-01-08 在港交所上市(2513.HK),索引 L853 已记 11-10 回购公告。可核的新事实只有「11-12 收跌 9.05% 至 HK$454、距 6 月高点 HK$2,980 跌超 84%」,且仅有二手财经源、无港交所披露对应 —— 判为误传,不入正文 |
| NVIDIA CEO 辞职原因 | 官方公告未给任何原因,也未提 11-11《华尔街日报》所报道的董事会行动细节。缺公司声明中对该背景的确认;正文只写人事与治理,不推断原因 |
| Gemini 4 Hydrogen 的基准图表 | 官方博客的详细基准表以 GIF 图片呈现(gemini-4-hydrogen_benchmarks_table.gif 等),逐项数值无法从文本读取;正文只采用正文段落明确给出的数字(TB 4.1 57%、AAII 51/54、HLE-D 58.8%、Tax 52.3%、Legal 55.8%、MKA 53.4%、ALE 71.6%)。全部厂商自测、无独立复现 |
| Claude Code Code Mode 机制 | release note 给出的文档链接 code.claude.com/docs/en/code-mode(含 .md 变体)本期实测均 404;启用/关闭的具体开关名、沙箱边界、是否限制可用 API 均无法确认。正文仅按变更描述写「写 JavaScript 调工具」 |
| OpenAI 印度本地推理的条款 | 一手 openai.com/index/india-data-residency 返回 403,thehindu.com 直连 fetch failed(仅 WebFetch 通道可读)。日本侧「ZDR + 仅按量付费 + 对 2026-03-05 后模型加收 10%」来自此前记录,印度是否同样适用无法确认 |
| ERNIE 5.5 Flash 的基准数字 | 官方页面「附录:评测结果」在正文结尾但表格内容本期未能抓取,正文只给定性「具有竞争力」;无参数量以外的架构细节、无定价、无模型卡。开源承诺为「11-25 前」,截至发稿未兑现 |
| Bernstein 数据中心可信度模型 | 数据截至 2026-10-11,11-12 经二手媒体扩散。586GW / 199GW / 387GW Bragawatts 与四重过滤减量均为模型推算、非实测;仅作趋势旁证 |
| VulnCheck Glasswing 审计 | 一手博文日期 11-09,早于本期窗口起点,故只在趋势中作旁证;442 个 CVE、217 个修复、假阳 55.9% 等均为 VulnCheck 自述口径,Anthropic 未回应 |
本期淘汰记录
| 类型 | 条数 | 明细 |
|---|---|---|
| 脚本判 DUP | 3 | 三条均为强键精确命中、本期无新事实:KKKKhazix/agent-autoloop(L730,11-06 已记 3,262★ 与决策卡片机制,URL 完全相等)、shanselman/gputaskman(L758,11-03 已记 595★ 与 KV cache 分解,URL 完全相等)、Anthropic IPO 估值 1.02 万亿 / 摊薄 1.4 万亿(强键命中 L744 / L771 / L795 / L826 四行,11-07→11-11 已记全下修轨迹与路演价格区间 $70–78,本次二手稿无增量) |
| REVIEW 复核后淘汰 | 0 | 第二轮 18 条 REVIEW 全部收录。逐条读过 related_rows 后确认均为独立事件而非旧事件增量:最强的一组对照是NVIDIA CEO 变更——11-12 期趋势四已记录市场侧(盘后 −9%、未发公告),本期为公司正式公告,故按「更新(首报 11-12)」写增量而非复述;另一组是 huawei-csl/MACaQ 与 L685 的华为 HBM——同一实体、完全不同主题(量化工具 vs 供应外推),按新事件处理 |
| 语义兜底淘汰 | 5 | ① 智谱 11-12 收跌 9.05%——仅二手财经源、无港交所披露对应,且「启动 IPO」与已上市事实冲突(见待核实);② Bernstein 586GW 模型——数据截至 2026-10-11,属背景而非窗口内新闻,降级为趋势三旁证;③ VulnCheck Glasswing 审计——一手博文 11-09,早于窗口起点,同样降级为旁证;④ 澳大利亚 1200MW 暂停的「全球反数据中心」框架——报道主体已收,但「特朗普表态」为旧言论重引,不重复计入;⑤ 豆包工作接入 Kimi/GLM/DeepSeek——仅有腾讯新闻与火山引擎文档站的间接证据,无字节官方发布页,模型清单与计费口径无法确认 |
| 语义兜底降级合并 | 2 | 2611.13873 CoT 可监控性并入论文第 8 条短评(与 2611.14704 同属「解释的可验证性」);**2611.13541 的「成本作为独立轴」**并入趋势三,不单列 |
| 人工剔除(板块容量) | 1 | apex-compute/ANR(983★ / 11-11 创建 / 11-12 推送)——Apex Neural Rendering 的帧生成(ANR FG)以安装器方式替游戏换上自家 FG,对标 DLSS-G / FSR / XeSS,支持 RTX 20–50、GTX 16、RX 5000–9000、Arc A/B。但源码「coming soon」、仓库当前只有 nr-record 录制对比工具,属闭源产品分发而非开源项目,故不入第六节;其「跨厂商 FRAME GEN」的意义留待源码开放后再评 |
| 第一轮 DUP 但一手源确认是新事件 | 1 | Gemini 4 Hydrogen——第一轮被弱键命中 Google 实体(related 全是 Carbon / Argon / 3.8 Live),回溯一手博文后确认这是家族第三个成员、全新定价档位,且与 L815 的 Carbon GA($4/$20 自 11-30)形成明确对照,翻案收录 |
| 白名单检索但窗口内无内容 | 4 | vLLM(最新 v0.33.0rc3,11-02)、SGLang(v0.5.23,11-02)、Transformers(v5.22.2,11-06)、Ollama(v0.40.17-rc0,11-10,11-11 期已收)——窗口内均无新正式版,不做凑数条目 |
| 独立发现通道(不在候选清单内) | 3 | 第六节三个项目由 GitHub Search API 按「2026-11-10 后创建 + 120★ 以上」检索(该窗口共 17 个仓库达门槛)。open-orange(11-12 创建,严格窗口内)、lot-map(11-09 创建、11-12T23:58Z 推送)、agentes-chat(11-09 创建、11-13T01:40Z 推送)——后两者创建日早于窗口起点但窗口内有实质推送,按「窗口内活跃 + 首次被本日报发现」收录,创建日期已在正文标注;其余 14 个与本日报主题无关(NAS 渲染、Tauri 练习项目、Hyperliquid 交易机器人、Blender 材质、QQ 客户端、马里奥反编译、Sega Rally 移植、GA100 电压毛刺、YouTube SEO 等) |
token 账:全量索引 858 条数据行 / 243,337 字符 ≈ 90,125 token(--audit 报问题 2 处——L77、L87 列数为 7,为摘要内含未转义 |,容错解析可读,未超 10 行门槛,未阻塞)。第一轮 32 条候选 → DUP 3 / REVIEW 17 / NEW 12;回溯一手源后重建第二轮 33 条(一手 URL 替换 12 条、论文补 1 条与项目补 2 条)→ DUP 3 / REVIEW 18 / NEW 12,以第二轮为准。预筛后需读 23,471 字符 ≈ 8,693 token,压缩 10.4×(NEW 12 条无需读索引)。回写后索引 886 条数据行 / 259,120 字符 ≈ 95,970 token(回写前 858 + 本期 28,--append 全部写入、零跳过;28 行均为新事件、URL 与旧行不重合,故未触发「同实体补『更新至』」分支,标注仍为 62 行)。回写后 --audit 问题数仍为 2 处(L77、L87),未新增。
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止 |
|---|---|---|---|---|---|---|
| 1 | 一 | Introducing Gemini 4 Hydrogen | Google(Koray Kavukcuoglu) | https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ | 2026-11-12 | 2026-11-12(基准图表为 GIF、逐项数值不可读;全部厂商自测) |
| 2 | 一 | Gemini 4 Hydrogen in Search | Google(Robby Stein) | https://blog.google/products-and-platforms/products/search/gemini-4-hydrogen-search-upgrade/ | 2026-11-12 | 2026-11-12(全文无任何量化指标;语音时长占位符未填充) |
| 3 | 一 | Google Intelligent Eyewear collections — pre-order | Google(Shahram Izadi) | https://blog.google/innovation-and-ai/technology/xr-ar/google-intelligent-eyewear-collections-pre-order/ | 2026-11-12 | 2026-11-12(预售日;开售 2026-12-10;仅美/韩,18+) |
| 4 | 一 | ERNIE 5.5 Flash Preview 发布 | 百度文心 | https://ernie.baidu.com/release/ernie-5-5-flash-preview/ | 2026-11-11 | 2026-11-11(权重开源承诺「11-25 前」;评测附录未能抓取) |
| 5 | 一 | Claude Code v2.1.323 | Anthropic(GitHub) | https://github.com/anthropics/claude-code/releases/tag/v2.1.323 | 2026-11-12 | 2026-11-12T22:12:13Z(Code Mode 为实验性、需 opt-in;文档链接 404) |
| 6 | 二 | llama.cpp b12340 | ggml-org | https://github.com/ggml-org/llama.cpp/releases/tag/b12340 | 2026-11-13 | 2026-11-13T01:13:58Z(b12308–b12340 共 24 个构建) |
| 7 | 二 | Visual Studio Code 1.146 | Microsoft | https://code.visualstudio.com/updates/v1_146 | 2026-11-11 | 2026-11-11(Local harness 移除日 2027-02;Copilot harness 自 1.143 为默认) |
| 8 | 二 | Test your applications against AWS locally with AWS Emulator | AWS(Daniel Abib) | https://aws.amazon.com/blogs/aws/test-your-applications-against-aws-locally-with-aws-emulator/ | 2026-11-11 | 2026-11-11(正文 11-12 补链;仓库 5,470★,CC0-1.0) |
| 9 | 二 | Codex Security npm-v0.10.0 | OpenAI(GitHub) | https://github.com/openai/codex-security/releases/tag/npm-v0.10.0 | 2026-11-12 | 2026-11-12T02:18:52Z(--max-total-cost 为估算值,进行中可超出) |
| 10 | 二 | huawei-csl/MACaQ | 华为(GitHub) | https://github.com/huawei-csl/MACaQ | 2026-11-12 | 2026-11-12T09:57Z(仓库 210★;122B/64 分钟/32.5GB 为官方口径,论文 2611.10649) |
| 11 | 三 | NVIDIA Announces CEO Transition | NVIDIA Newsroom | https://nvidianews.nvidia.com/news/nvidia-announces-ceo-transition | 2026-11-12 | 2026-11-12(即刻生效;Q3 FY2027 财报仍定 11-17;未给辞职原因) |
| 12 | 三 | Supported Regions(Effective Nov 12, 2026) | Anthropic | https://www.anthropic.com/legal/supported-regions | 2026-11-12 | 2026-11-12(170 余国家/地区;未定义「授权经销商」;无过渡期条款) |
| 13 | 三 | Infor and Anthropic Announce Partnership… | Infor(PRNewswire) | https://www.prnewswire.com/news-releases/infor-and-anthropic-announce-partnership-that-turns-insights-into-actions-for-manufacturing-operations-302938160.html | 2026-11-12 | 2026-11-12 12:02 ET(仅部分 Velocity Suite 客户;未公布定价) |
| 14 | 三 | OpenAI now allows enterprises to process AI requests within India | The Hindu | https://www.thehindu.com/business/openai-now-allows-enterprises-to-process-ai-requests-within-india/article71692799.ece | 2026-11-12 | 2026-11-12(一手 openai.com 403;区域端点加收 10% 为日本侧口径) |
| 15 | 三 | 「反数据中心」声浪蔓延全球:澳大利亚至少三个项目受阻 | 财联社(卞纯) | https://www.cls.cn/detail/2532729 | 2026-11-12 | 2026-11-12 16:44(Quantum DC 声明当日;1200MW 为拟建规模) |
| 16 | 四 | Bursts That Outlast Themselves(2611.13412) | arXiv | https://arxiv.org/abs/2611.13412 | 2026-11-10 | 2026-11-10(预印本;vLLM + SGLang 双栈复现,12 对中 9 对) |
| 17 | 四 | Cleaning an Agent's History Hurts…(2611.14654) | arXiv | https://arxiv.org/abs/2611.14654 | 2026-11-10 | 2026-11-10(预印本;AgentCE-Bench + AppWorld,两个接收模型) |
| 18 | 四 | Agent benchmark 饱和在测量(2611.13541) | arXiv | https://arxiv.org/abs/2611.13541 | 2026-11-10 | 2026-11-10(预印本;8 个 benchmark 已发布 run 重打分) |
| 19 | 四 | Massive activations 与 SAE 评估(2611.13548) | arXiv | https://arxiv.org/abs/2611.13548 | 2026-11-10 | 2026-11-10(预印本;PC1 最多占 99.9% 方差) |
| 20 | 四 | Work-conserving speculation / ForeSpark(2611.13442) | arXiv | https://arxiv.org/abs/2611.13442 | 2026-11-10 | 2026-11-10(预印本;draft 占 step 时间至 40%;摘要未给端到端吞吐) |
| 21 | 四 | ActiveSecHarness(2611.13960) | arXiv | https://arxiv.org/abs/2611.13960 | 2026-11-10 | 2026-11-10(预印本;N=252 fixtures,qwen3:4b 判定器,作者自测) |
| 22 | 四 | Contrastive Discovery(2611.14514) | arXiv | https://arxiv.org/abs/2611.14514 | 2026-11-10 | 2026-11-10(预印本;六领域;38 位专家盲测) |
| 23 | 四 | Code as Explanations(2611.14704) | arXiv | https://arxiv.org/abs/2611.14704 | 2026-11-10 | 2026-11-10(预印本;3 个开源模型 × 8 任务 × 24 设定) |
| 24 | 四 | CoT 可监控性披露指标(2611.13873) | arXiv | https://arxiv.org/abs/2611.13873 | 2026-11-10 | 2026-11-10(预印本;对 Anthropic/OpenAI/GDM 公开披露的审计) |
| 25 | 四 | A2UI v1.0 specification | A2UI Project | https://a2ui.org/specification/v1.0-a2ui/ | 2026-11-12 | 2026-11-12(仓库 17,217★;releases 11-10 与 11-11;SDK 仍为 0.x) |
| 26 | 六 | rivet-dev/open-orange | GitHub | https://github.com/rivet-dev/open-orange | 2026-11-12 | 2026-11-12(v1.0.0 12:16Z / v1.0.1 17:06Z;4.8×/8.7× 未注明对比基准) |
| 27 | 六 | alexeyw/lot-map | GitHub | https://github.com/alexeyw/lot-map | 2026-11-12 | 2026-11-12T23:58Z(Claude Code 2.1.321 构建与测试;终端需 144 列) |
| 28 | 六 | agentes-chat/agentes-chat | GitHub | https://github.com/agentes-chat/agentes-chat | 2026-11-13 | 2026-11-13T01:40Z(AGPL-3.0;多项功能标 Beta) |
引用提醒:本期所有厂商自测 benchmark 均已在正文与上表标注「厂商自测、无独立复现」;三张配图为依据上述来源自绘,非原文插图。凡一手源不可达者已列入「⚠️ 待核实」,不进入正文结论。