AI DAILY
AI 日报 2026-11-16
一句话结论本期收录 22 条(模型与产品 4 / 工程与架构 5 / 行业 3 / 论文 6 / 开源项目 4)+ 3 条趋势。淘汰账:脚本判 DUP 2 条、REVIEW 复核后淘汰 5 条、语义兜底合并 4 组、翻案 1 条、补录 9 条、待核实 4 项。 真正值得看的是 Google Research 那份 /teamwork 报告,但重点不是「AI 证明了 Weil 猜想」——它形式化的是别人已经证完的证明,作者自己也把最硬的一条(Courtade–Kumar)注明了三方独立预印本。真正的信号在架构上:系统把 Lean 4 内核、未改动的原始测试套件、模拟器、硬件计数器 当成绩效判据的「falsifier(证伪器)」,让 28,800 次 subagent 调用去撞这些不问语气、只问对错的检查器。这和同日出现的三篇论文(Soteria 执行前形式化验证、Co-Sight 的验收门 + 独立 auditor、Thomson 问题的精确整数认证)是同一件事:决定产出可用性的不再是模型能力,而是「谁来判对错」以及判据本身是否可信。而这条线的软肋也很明确——Lean 只保证形式陈述与证明一致,陈述是不是原问题仍需人判;第三方对 Google 那个 5,000 万行仓库的复核更直接:其中只有约 23.9 万行是可读证明代码,其余是证书数据。行数是工程量,不是难度。 第二条主线是「接口层的标准化在一周内连推三步」:Sierra 的 Poppy 1.0 用 /.well-known/poppy.json 给 agent 发访客证(Shopify 全站自动发布)、DeepSeek 把整套 App 工具箱塞进 API 的三种协议、GitHub 一次性退役六个 Copilot 模型并给出替代映射。前两条在降低 agent 接入成本,第三条在抬高「把模型名写死」的成本——12-14 是硬截止,且十周内已经是第四波退役。 技术上最该动手的一条是 llama.cpp v1.0.0:首个稳定版承诺 semver,同时把 server 的 SSRF、CORS、DNS rebinding 一并硬化。任何对外暴露 llama-server 的部署,本周就该跟。
AI 日报 2026-11-16
整理日期:2026-11-16 素材来源:白名单一手信源(Anthropic / OpenAI / Google Research / Cloudflare / Sierra 官方博客与文档、GitHub Releases API 与仓库本体、arXiv 原始 abs 页、AWS Security Blog、EFF),二手媒体仅用于发现线索并回溯一手源,逐条见文末附录 可信度提示:统计窗口 2026-11-13 10:00(上期截稿)→ 2026-11-16 10:45 HKT,约 72 小时。四条口径先说清:① 11-14、11-15 两日无刊,本期要补的正是这段空档,因此窗口起点取上期截稿时刻而非「昨天 00:00」;首发于 11-13 下午至夜间的 9 条统一标「补录」,不计入当日新增。② arXiv 11-14/11-15 无提交(周六周日),本期论文池是 11-13(周五)提交批次(2611.17610–2611.17899),逐篇 curl
/abs/核对Submitted on 13 Nov 2026,与上期(11-10 批次)零重叠。③ 厂商自测 benchmark(/teamwork全部成果、llama.cpp 与 Transformers 的模型支持、GDP.xlsx 的分数)均标「厂商自测 / 无独立复现」;/teamwork的 Lean 行数另有第三方复核,已在正文写明差在哪里。④ 一手页不可达者:research.google直连失败(数字经 4 家独立转引交叉)、huggingface.co仍不可达、anthropic.com/news只到 11-10 且制造业页 404 —— 涉及三者的一律进「⚠️ 待核实」,不进正文结论。 配图:文中 2 张图为自绘(依据下列来源整理),非原文插图。
#AI日报 #模型动态 #推理框架 #Agent #论文 #开源项目
一句话结论
本期收录 22 条(模型与产品 4 / 工程与架构 5 / 行业 3 / 论文 6 / 开源项目 4)+ 3 条趋势。淘汰账:脚本判 DUP 2 条、REVIEW 复核后淘汰 5 条、语义兜底合并 4 组、翻案 1 条、补录 9 条、待核实 4 项。
真正值得看的是 Google Research 那份 /teamwork 报告,但重点不是「AI 证明了 Weil 猜想」——它形式化的是别人已经证完的证明,作者自己也把最硬的一条(Courtade–Kumar)注明了三方独立预印本。真正的信号在架构上:系统把 Lean 4 内核、未改动的原始测试套件、模拟器、硬件计数器 当成绩效判据的「falsifier(证伪器)」,让 28,800 次 subagent 调用去撞这些不问语气、只问对错的检查器。这和同日出现的三篇论文(Soteria 执行前形式化验证、Co-Sight 的验收门 + 独立 auditor、Thomson 问题的精确整数认证)是同一件事:决定产出可用性的不再是模型能力,而是「谁来判对错」以及判据本身是否可信。而这条线的软肋也很明确——Lean 只保证形式陈述与证明一致,陈述是不是原问题仍需人判;第三方对 Google 那个 5,000 万行仓库的复核更直接:其中只有约 23.9 万行是可读证明代码,其余是证书数据。行数是工程量,不是难度。
第二条主线是「接口层的标准化在一周内连推三步」:Sierra 的 Poppy 1.0 用 /.well-known/poppy.json 给 agent 发访客证(Shopify 全站自动发布)、DeepSeek 把整套 App 工具箱塞进 API 的三种协议、GitHub 一次性退役六个 Copilot 模型并给出替代映射。前两条在降低 agent 接入成本,第三条在抬高「把模型名写死」的成本——12-14 是硬截止,且十周内已经是第四波退役。
技术上最该动手的一条是 llama.cpp v1.0.0:首个稳定版承诺 semver,同时把 server 的 SSRF、CORS、DNS rebinding 一并硬化。任何对外暴露 llama-server 的部署,本周就该跟。
一、模型与产品
1. Poppy 1.0:个人 agent 的「访客证」标准,靠 Shopify 的分发而不是靠共识落地
Sierra 与 Meta 在 11-13 发布 Personal Agent Protocol 1.0(简称 Poppy)。协议本体不新造栈:发现机制是企业在域名下放一个 /.well-known/poppy.json,写明自己提供哪些接口(网站 / MCP server / OpenAPI / 自有企业 agent)与每项能力允许的访问级别;认证走 OAuth,用户在企业自己的页面上登录并勾选 scope,可随时撤销;会话用短时密钥签名,且每个用户在不同企业拿到不同 ID,跨站追踪不在设计里。
权限不是「全有或全无」,规范用酒店场景给了五档:禁止 agent、任何 agent 可查房、登录后可看订单、下单需客户逐次批准、完全代替用户执行。企业可按能力粒度独立升降档。
分发是这条新闻的真正内容:Shopify 在 175+ 国家的每一家店铺现在自动发布 poppy.json,商家零改动;Meta 的 Muse 在访问任何站点时先找 Poppy 文件。设计伙伴从 10-06 的 8 家 → 10-09 草案时的 43 家 → 现在的 100+ 家,Mercury、Synchrony、Turkish Airlines 已上线,其中 Mercury 允许 agent 发起转账但必须过账户自身的审批策略。
判断:这是本期最「工程正确」的一条——它把 agent 接入从「检测与反检测的军备竞赛」换成一个静态文件 + OAuth,和当年 robots.txt 解决爬虫的路径一模一样。但要看清两点:它是靠 Shopify 与 Meta 的装机量在一周内变成事实标准的,不是靠委员会共识;而且官方规范页现在仍标着 Draft 1.0。对开发者的实际含义是:如果你在做 agent 侧,poppy.json 应该进你的站点发现顺序(先 Poppy,再退回 DOM 抓取);如果你在企业侧,这份文件定义的是「你不写它,agent 就只能用登录态硬闯」这一默认结局。
来源:Sierra · https://sierra.ai/blog/releasing-poppy · 2026-11-13(补录)
2. DeepSeek 把整个 App 的工具箱搬进 API:三种协议、五个内置能力、一套服务端组装
11-13 的 API 更新把 DeepSeek App 背后的能力全部开放:deepseek-flash(V4.1-Flash)在 Messages / Responses / Chat Completions 三种协议下都支持内置 web search(非思考模式带引用)、Deep Thinking Search(多步推理中边搜边读)、文件解析(PDF / Office / 图片)、URL 读取(deepseek_read_url)、输入输出安全筛查(面向公众的应用强制开启)。工具调用与上下文组装都在服务端完成,客户端只需几个参数。此外 Search / Fetch / OCR / ASR / TTS 另有独立 API 可单独调用,并开源了 chat-demo 前端(支持导入 DeepSeek 会话历史)。
判断:三点值得记。① 协议层面主动对齐 Anthropic 与 OpenAI 两家格式,这意味着它可以直接挂进 Claude Code / Codex 这类 harness——中国厂商在用「兼容别人接口」换生态位。② 把安全筛查做成 API 参数并强制公众应用开启,等于把合规责任显式写进调用契约,这在此前的中文厂商 API 里不常见。③ 官方把整套 chat 前端也开源,这是在承认「模型的护城河不在壳上」。悬而未决的是价格:官方页的定价表是动态组件,本环境未取到数值,只能确认「内置能力在 token 费之外按工具用量另计」;10-17 期已记的 Search/Fetch 是 $0.75/千次成功请求,可作参照。
来源:DeepSeek · https://api-docs.deepseek.com/news/news261113 · 2026-11-13(补录)
3. GitHub Copilot 12-14 一次性退役六个模型,Kimi K3 没有替代品
11-13 的 changelog 明确:2026-12-14 起 Claude Fable 5、Claude Haiku 4.5、Gemini 3.8 Flash、Gemini 4 Argon、Grok 4.6、Kimi K3 从 Copilot 的全部形态下线(Chat、inline edits、ask 与 agent 模式、code completions)。替代映射给了五个:Fable 5→5.2、Haiku 4.5→5.5、3.8 Flash→4 Hydrogen、Argon→Carbon、Grok 4.6→4.7;Kimi K3 一栏写的是「待定」。唯一的例外是 Claude Haiku 4.5 对个人年付订阅者继续保留,Business / Enterprise 不享受。
| 下线模型 | 替代 | 备注 |
|---|---|---|
| Claude Fable 5 | Claude Fable 5.2 | 5.2 的策略默认关闭,管理员需手工放行并确认数据保留条款 |
| Claude Haiku 4.5 | Claude Haiku 5.5 | 个人年付订阅者保留 4.5 |
| Gemini 3.8 Flash | Gemini 4 Hydrogen | Hydrogen 于 11-12 发布(见 11-13 期) |
| Gemini 4 Argon | Gemini 4 Carbon | 两档都在 11-30 起价格翻倍($2/$10 → $4/$20) |
| Grok 4.6 | Grok 4.7 | — |
| Kimi K3 | 待定 | 无迁移目标,却同样在 12-14 消失 |
判断:这是十周内第四波退役,累计 19 个模型。两件事必须分开看:替代映射本身是直升级,多数用户无感;但 Argon→Carbon 这条「同档替换」藏着账单——Google 的 Carbon 与 Argon 都在 11-30 翻倍,也就是说 12-14 完成迁移的团队,会在同一周里同时承受「换模型」与「单价 ×2」。更尖锐的是 Kimi K3:到期消失但无替代,pin 了它的 CI 流水线 12-14 当天直接没有目标可指。可操作结论:把模型名从代码与扩展配置里抽出来,走一层路由;把 12-14 当成一次成本重估的节点,而不只是改名。
来源:GitHub · https://github.blog/changelog/2026-11-13-upcoming-deprecation-of-selected-github-copilot-models-in-december · 2026-11-13(补录)
4. OpenAI 开科学博客,首篇是「物理学家署名、模型致谢」的格点标准模型
11-15 OpenAI 上线 science blog,首篇是客座文章:UCSB 粒子理论组的 Nathaniel Craig(同时在 OpenAI 做访问科学家)讲他与 GPT-6 Astra 合作的成果——给标准模型一个候选的非微扰格点定义。问题的症结是手征性:弱力对左右手征费米子区别对待,直接放到格点上会生出不需要的镜像伙伴(doublers)。Craig 自述已有策略但证不出在所有必要情形下成立,Astra 帮他把策略变成构造、主导了详细证明、并给出「把规范场搬到更细网格上」的正确做法与收敛性论证;三位格点场论专家(Golterman、Kronfeld、Shamir)审阅并追问。作者称这解决了**二十五年未定的相位规定(phase prescription)**问题——Lüscher 1999 只处理了更简单的理论。
限度写得比结论更诚实:这是「原则上的答案,不是实践上的答案」,离真实格点模拟还远;构造在有限格距下成立,且依赖对场强的上界;反射正定性(reflection positivity)尚未证明;预印本是 10 月的 arXiv 2610.09093。
判断:物理结论交给物理学家评;这条对 AI 行业的意义在发表格式上——「人类科学家署名 + 明确写出模型做了什么 + 同行审阅提问」这套结构,比「模型解出某猜想」的公关稿有用得多,因为它把可核查的分工写进了正文。反过来也要冷静:Astra 主导证明 是作者自述,没有独立的证明审计,而这类工作最容易出的错不是推理错,是把原问题悄悄换成一个可证的近似问题。
来源:OpenAI · https://openai.com/index/step-toward-defining-the-standard-model · 2026-11-15(配套:https://openai.com/index/our-new-blog-for-science)
二、工程与架构
1. llama.cpp v1.0.0:删掉 35 个废弃 API,FP8 KV 与 MoE 专家缓存同时进主线
11-13T10:20Z,llama.cpp 发布首个稳定版 v1.0.0,ggml 同步到 v1.0.0,并承诺此后按语义化版本走。改动可以分三块看。
API 清理:llama.h 删掉 35 个废弃函数、llama_set_warmup、defrag_thold 与 --defrag-thold;NextN 投机 API 从 llama-ext.h 提升进 llama.h,llama_set_embd_state_src 更名 llama_set_ctx_state_src。这是一次会打断下游编译的版本,从 0.x nightly 直接跳到 v1 的项目需要预留迁移窗口。
显存两条主线:① FP8 KV cache(-ctk/-ctv f8_e4m3,可选静态 per-tensor scale,#28392);② MoE 专家 host 缓存(moe_cache_size + moe_cache_cpu_share 进 llama_context_params,替换策略换成 LRFU/ClassLRU,命中缓存时不再等待 CPU,#30966/#31233/#31888)。配套还有外部 PLE/engram 分片加载(--shard/--ple)、Windows 无缓冲加载对齐 Linux DirectIO、以及跳过无用图元数据页。
服务面:新架构 Kimi-K3.1-Pro(把 K3 的全注意力 MLA 层换成 DSA)、Ripple-65B-Preview(65B dense,无新算子)、xing4_0(mHC + MLA + MoE + MTP)、drama-3 TTS,视觉侧补 MageVL-Cowork 与 Kimi-K3.1;llama-server 一次性硬化 SSRF、CORS、DNS rebinding 与 MCP 工具取消;新增 OpenAI 兼容的 /v1/audio/speech,/tts 支持 temperature;Web UI 重做(会话分组 + Markdown 编辑器)。
判断:semver 之后 nightly 并没有停(11-15 一天仍推了 20 多个 b 号构建),所以 v1.0.0 是API 稳定承诺,不是功能冻结。对运维而言最重要的不是新模型,而是那四条 server 加固——如果你的 llama-server 对外可达,b12340 那轮 SSRF 修复只是补了一半,v1.0.0 才是收口的版本。对本地部署玩家,FP8 KV + MoE host cache 的组合是「同一张卡塞更长上下文 + 更大 MoE」的直接手段。
来源:ggml-org · https://github.com/ggml-org/llama.cpp/releases/tag/v1.0.0 · 2026-11-13T10:20Z(补录)
2. /teamwork 的架构才是重点:把「判对错」拆成独立的证伪器层
11-13 Google Research(Vahab Mirrokni)披露 Antigravity /teamwork 的成果,规模数字很吓人,但架构更值得抄。
系统针对当前模型的两个弱点设计:单次尝试不可靠 → 并行跑多份候选,交给「专用 falsifier」筛(Lean 4 证明检查器、未改动的原始测试套件、执行模拟器、硬件计数器、web search),判据不问模型有多自信;多天任务里模型会丢细节 → 做上下文分区,每个 agent 只拿自己那一步需要的文件与工具,协调者把活交给「干净的继任者」,critic 与 auditor 在不带生产者推理的上下文里复核。
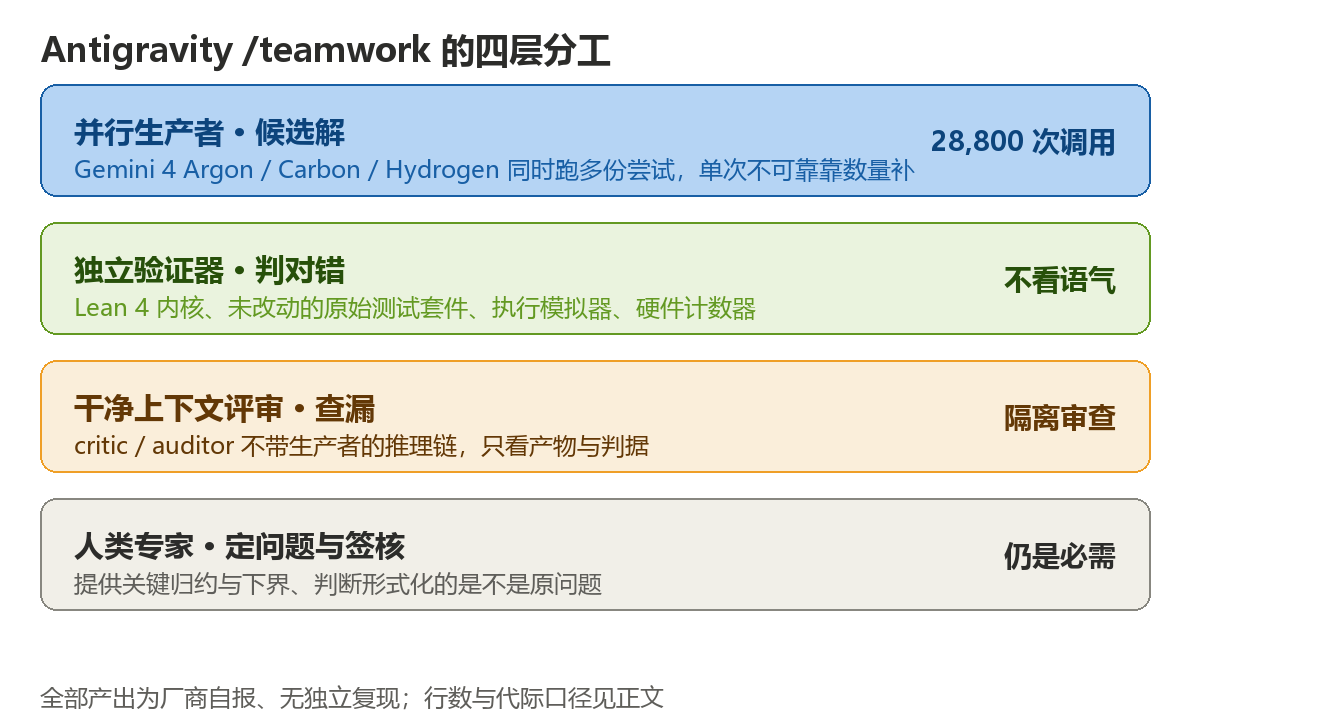
产出侧(全部厂商自报、无独立复现):
| 方向 | 结果 | 口径提示 |
|---|---|---|
| Weil 猜想 | 端到端机器校验形式化,约 180 万行 Lean / 28,800 次 subagent 调用(LEAP 全自主) | 形式化的是已完成的证明,不是新证明 |
| Hilbert 第十问题 | 919,000+ 行 Lean,给出某近期证明在一般整数环上的首个形式化 | 同上 |
| Courtade–Kumar 猜想(2013) | 与 CUHK/USC/CMU 合作证明并 Lean 4 全形式化,5,000 万行 | 同一猜想另有 2 篇独立预印本(2609.24184、2609.26444);第三方计数仅约 23.9 万行是可读证明代码,其余为证书数据 |
| Zircon 微内核 | 两周把剩余 C++ 改写为 约 80 万行安全 Rust,过全部内核单测、arm64 可启动 | 每个模块只在依赖编译通过后调度,并对原始未改动测试链接 |
| libgav1(AV1 解码器) | 约 17 万行 Rust,位精确等价,给到 profiling 工具后比原 C++ 快 20–30% | — |
| Google 自身运维 | 两项 Borg 调度改动上线,部分硬件 TPU 抢占 −24%;内存节省超原估 1 PiB | 内部指标,无外部核验 |
对外可用性:/teamwork 与 /boost 现在对 Antigravity 付费用户开放,学术侧开放 1 万名研究者 6 个月最高档免费;但形式化证明模式与改写模式本身尚未对外开放。另外有一条逆着「并行」结论的发现被写进产品:紧耦合代码用「顺序实现—修订」比并行拆分更好,Google 把它并进了 /boost。
判断:这套东西的可迁移部分不是「多开 agent」,而是三条纪律:判据必须是机器可判的、生产者与评审者的上下文必须隔离、改写类的任务必须对未改动的原始测试链接(否则 agent 会把测试也一起改了,让移植「通过」)。第三条在 Zircon 那条里是显式设计的,这才是它能过内核单测的原因。反过来说,1.8M 行 Lean 这种数字被当成能力证明是误读——形式化的工作量与数学难度无关,而「陈述是否忠实于原问题」这一步仍然完全在人手里。
来源:Google Research · https://research.google/blog/advancing-science-engineering-with-antigravitys-teamwork-feature/ · 2026-11-13(补录;本机直连该域名失败,数字经 Times of AI / TSNMedia / Digital Editorial / Sanctity 四家独立转引交叉核对,含第三方对行数的复核)
3. Transformers v5.23.0:七种新模型类型,其中「决策头」是方向性的一条
11-13T14:10Z 发布。三个重点:Inkling2(Thinking Machines 的 594B 总参 / 17B 激活,48 层 MoE 每 token 路由 8/384 专家,引入 block attention residual、带学习 sink 的门控注意力、动态 KV 卷积;视觉用 Perception-Encoder 系 ViT,每 40×40 像素块一个 embedding);JEV 决策头(JevForDecision 从权重旁的 head.safetensors + judge_config.json 读配置,在 prompt 末位用线性层给单 token 标签打分,复用 GEV 与 pplx-decider/d3 的 255 个答案码,可走 decision pipeline 或直接 decide);LFM3(Liquid AI,门控短卷积 + GQA 的混合架构)。此外共七种新模型类型,并重建了模型导出 API。
判断:JEV 值得单独拎出来,因为它把「判定」做成了一个独立的小 head,而不是让主模型在自然语言里给结论。这与本期另一条线完全同源——执行模型与裁决模型开始分开定价、分开部署(Copilot 的替代映射、Anthropic 的评估员、/teamwork 的 falsifier 都是这个方向)。但官方把它标成 experimental、API 与行为都可能变,生产环境别急着上。
来源:Hugging Face(GitHub) · https://github.com/huggingface/transformers/releases/tag/v5.23.0 · 2026-11-13T14:10Z(补录)
4. Claude Code v2.1.325:一条没给 CVE 的安全修复,和一批「静默错」的修补
11-13T20:40Z 发布。首条是安全项:修复 zstd 压缩响应解码路径的安全问题——官方没有给 CVE、影响面或利用条件。其余是大量「不崩但会错」类的修补:subagent 用了自己的模型时,文件读取与 MCP 结果的 sizing 却按主会话模型算(导致上下文预算错位);第三方 gateway 与 Foundry 上每轮都报上下文超长、而不是正常压缩;异常退出后 resume 会丢最近的轮次;工作目录被删后 shell 仍在启动目录执行;plansDirectory 写不进去时已批准的 plan 编辑会静默丢失(现在退回默认目录并告知);sonnet[1m] 的已保存设置在全新安装后被改写成 API 会拒的 id。
判断:压缩解码是这几年的高发面(解压炸弹、内存放大、流式分片边界),一条「已修复但不给细节」的条目按惯例应视为应当立即升级,尤其 CI 里跑 Claude Code 的团队。更值得记的是后面那批:它们全是协议兼容层与状态机的静默失效——和 10-13 期 llama.cpp b11509 的「不崩不报错只变笨」是同一类问题。这类 bug 不会出现在监控里,只会出现在「为什么今天 agent 变笨了」的工单里。
来源:Anthropic(GitHub) · https://github.com/anthropics/claude-code/releases/tag/v2.1.325 · 2026-11-13T20:40Z(补录)
5. llama.cpp 的 4 小时 43 分:一个特性被「加上—回滚—换 PR 重加」
11-15 19:29Z,b12422 提交 jinja: add 4 missing features;26 分钟后 19:55Z,b12423 直接 Revert "jinja: add 4 missing features";到 11-16 00:12Z,b12428 用新的 PR 号 #32352 重新落地同一批特性。
同一窗口里服务器侧的修复也集中:b12415 修 /v1/messages 丢弃 output_config.effort(Anthropic 兼容层静默吞字段)、b12404 修流式响应结束后的连接复用、b12389 修 OpenCL q4_K 的 mul_mat_vec 越界读与 f16 swiglu_oai 越界写、b12383 修 ggml-backend 在「不含 input 的 split」中遇到不兼容权重不分片的边界。
判断:这类「加—撤回—换号重加」的记录比 release note 更能说明测试覆盖的边界:chat template 是配置即代码,四项 Jinja 特性一上就可能改掉所有模型的 prompt 渲染路径,回滚是最便宜的选择。工程上可复用的结论两条:模板引擎的改动必须配「全模型渲染快照」回归;跨协议兼容层(/v1/messages)要有一致性测试,effort 这种字段被吞掉不会报错,只会让「思考档位」悄悄失效。
来源:ggml-org · https://github.com/ggml-org/llama.cpp/releases/tag/b12428 · 2026-11-16T00:12Z
三、行业与发展
1. Amazon 蜜罐抓到 agent 的「作战日志」:偷来的模型 key 供养下一次偷窃
11-13 AWS Security Blog(CISO CJ Moses)披露:10-03 到 11-05,Amazon 的 MadPot 诱捕网络把传感器伪装成主流 LLM 推理 API,收到了来自 ARTEX(开源 agent 渗透框架)的 agent 请求——而这些请求自带持久任务上下文、system prompt、工具历史、知识图谱状态与自报战果。因为 agent 框架每一步都把会话历史送给模型,单次请求常常就是一整场行动的完整记录。
主行动是一条自养闭环:大规模窃取 AI 模型凭证 → 偷到的 key 灌进框架自己的 model gateway → 用别人的额度支付继续搜索凭证的推理费。目标以 LLM 网关与 AI 应用构建器为主(One API / New API / Veloera / Sub2API / LiteLLM、Dify / FastGPT / Langflow / RAGFlow / Open WebUI / LobeChat / Ollama),手法包括 LiteLLM 默认 master key、CVE-2025-3248(Langflow)、CVE-2026-28797(RAGFlow)、One API 系 isCliRequest 认证绕过、URL 抓取 SSRF 打云元数据;凭证按「能不能用、能摸到什么」分级,公开暴露超 30 天的降为低价值库存。第二条线对两家交易所做实时 deepfake 过 KYC:反推出某验证厂商的 liveness 协议(人脸事件流 + 动作提示坐标系),单张消费级 GPU 跑到 11.5 fps,但该厂商拒绝了全部记录在案的尝试。
归因为「中文简体 prompt + 中国时区 + 排除中国大陆与政府域名的红线」,且判定是多个互不协同的团体,置信度均为 moderate。Amazon 明确声明:只看到 agent 自报的内容,没有观察到执行过程,也无法核实结果;对无法确认的第三方只发布 IOC。FBI 同日发出 FLASH-20261113-001。
判断:这条的真正信息不是「黑客也用 agent 了」(去年就发生过),而是agent 的持久记忆既是效率来源也是最大泄漏面。攻击方靠共享知识图谱让四个角色(planner / worker / verification / compression)接力干活,代价是任何一次「误连到假 API」都会把整份作战史交出去。对自建 agent 的团队,可操作的有三条:记忆里不放长期有效的凭证、出站流量强制代理与域名白名单、把「外部 API 端点」当不可信输入校验。同时要给这条情报打折——Amazon 看到的是攻击方的自述,不是事实现场,两者在取证价值上差一个量级。
来源:AWS Security Blog · https://aws.amazon.com/blogs/security/amazon-threat-intelligence-observes-threat-actors-running-cybercrime-campaigns-with-artex-ai-agents/ · 2026-11-13(观察窗 2026-10-03 → 11-05)
2. STOC 2027 逾三分之一投稿选择让 AI 做首轮评审
同一份 Google Research 报告里有个容易被规模数字盖掉的事实:STOC 2027 有 578 篇投稿(超过全部投稿的三分之一)选择加入 Deep Review——即让 Antigravity 的评审流程先读一遍。
判断:这比「AI 证明了什么」更能说明学术界的实际态度:不是要不要用,而是已经在用,且是作者自愿opt-in。它同时提出一个本期无解的问题——当三分之一的投稿先被同一个厂商的系统审过,评审的独立性怎么定义?这个问题没有技术答案,只有制度答案(多供应商、可审计、评审记录留痕),而现在一条都还没有。
来源:Google Research · https://research.google/blog/advancing-science-engineering-with-antigravitys-teamwork-feature/ · 2026-11-13
3. EFF:可穿戴 AI 把隐私成本转嫁给「旁边的人」
11-15 EFF 的评论指向一个常被绕过的点:always-on 的 AI 可穿戴设备剥夺的不是佩戴者的隐私,而是周围人的——他们既没有同意,也无法退出。EFF 认为行业正在试图把「隐私」的定义从「被收集者同意」悄悄改写为「使用者知情即可」。
判断:本期没有任何监管动作跟上,所以这条只能算方向标记。但它和上一条是同一个问题的两面:agent 与 always-on 设备都在扩大「谁的同意才算数」的边界。凡是做硬件 + 语音/视觉的产品,这条迟早会变成准入问题而不是公关问题。
来源:EFF · https://www.eff.org/deeplinks/2026/11/tech-companies-are-trying-shift-entire-concept-privacy-again · 2026-11-15
本期行业侧的缺口说明:投融资与政策线在窗口内没有新增一手事件——NVIDIA CEO 变更(11-12 官方公告)已写入 11-13 期,Anthropic 的 $70–78 定价区间与 7 家合计 $260 亿 N 类私募(谷歌/英伟达各 $100 亿)已写入 11-11 期索引 L825,本期不再复述。聚合站 11-15 把这两条当「今日新闻」重推,已按 DUP 淘汰。
四、论文与开源
1. 2611.17880 Soteria:拦住不安全动作之后,还得告诉 agent 下一步怎么走
现有安全方案要么「拦死」——违规动作被拒绝后 agent 卡在那里、任务失败;要么「放行求效用」。Soteria 的做法是在执行前先生成结构化计划并过形式化验证,验证通过才允许调用任何工具;运行时这份已验证的计划兼两个角色:约束轨迹合规,以及在不安全动作被拦时给出可继续的替代路径。它要解决的是效用与安全的张力,而不是用安全换效用。
判断:这是本期与 /teamwork、Co-Sight 构成互文的第一块。它的关键设计是「验证前置」——把形式化验证放在调用工具之前而不是事后审计,代价是计划必须结构化到可验证的程度,这对开放式任务是硬约束。
来源:arXiv · https://arxiv.org/abs/2611.17880 · 2026-11-13(预印本)
2. 2611.17808 CarryOn:上下文该留的不是「摘要」,是「能回到出处的证据」
长程 agent 的历史一长,三类做法各有硬伤:摘要会丢掉后续动作要用的精确值,全量保留带着大量无关信息,历史选择又容易选错。CarryOn 把上下文拆成两层——紧凑的执行状态 + 细粒度、可回溯到来源的证据,用一个学习到的选择器与自适应保留策略决定留哪条,且上下文管理本身不再额外调用 LLM。评测上提出两类指标:S_α(以任务成功为主,同时把资源消耗计入)与证据级指标。
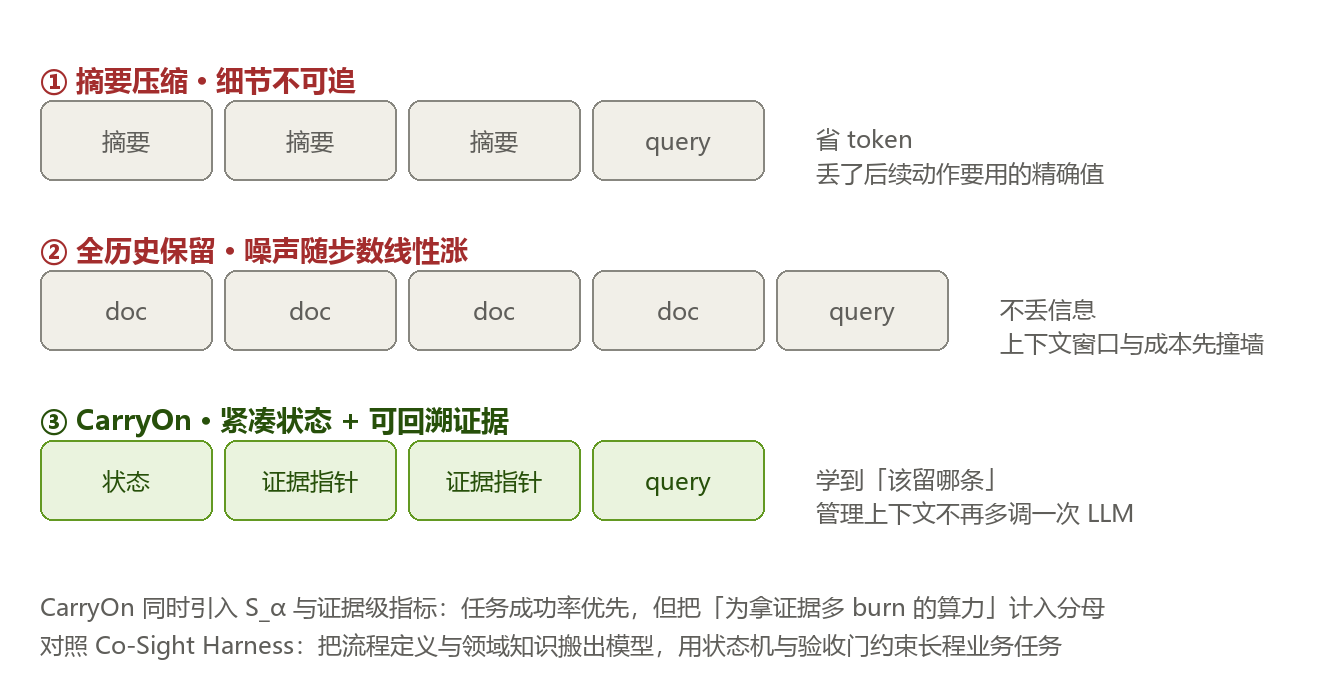
判断:「不再为管理上下文多调一次模型」是这条的实用价值——现在主流的摘要式压缩每压一次都是一次完整推理,长任务里这笔开销不小。真正的方法论变化是把记忆从「prompt 工程」变成「索引与回溯」问题,这与本期 Co-Sight 把领域知识搬出模型是同一个方向。
来源:arXiv · https://arxiv.org/abs/2611.17808 · 2026-11-13(预印本)
3. 2611.17797 Vision-as-a-Tool:把视觉推理从「模型能力」变成「可调用工具」
主流多模态 agent 走的是 Thinking-with-Images:视觉推理依赖模型内在感知,于是性能被模型的感知力封顶,纯文本 agent 则完全没有视觉能力。VaaT 反过来把通用 MLLM 当成外部可调用的效用,agent 需要看图时去调,纯文本 agent 因此可以整体卸载视觉推理。
判断:这条与 /teamwork 的 falsifier 思路同构——把能力外置成有明确输入输出的工具,比把能力塞进更大的模型更容易验证与替换。短期看它省不了延迟,长期看它让「换视觉模型」不再等于「换主模型」。
来源:arXiv · https://arxiv.org/abs/2611.17797 · 2026-11-13(预印本)
4. 2611.17766 GDP.xlsx:最强模型在真实工作簿上严格通过率 38.3%
70 个由 13 个领域的专业人士写的真实工作请求,每个配一份专家评分表(共 791 条二元判据)与它引用的工作簿/CSV(合计 218 万填充单元格)。agent 在容器里用表格工具操作文件,由能打开文件的 agentic judge按判据打分;「完整性」与「排他性」两类判据要求集合型答案既全且不多。按严格 pass@1 排,20 个配置里 Gemini 4 Argon 最高 38.3%,中位数 19.3%;公开 3 个任务,其余 67 个保留。
判断:这类基准的价值在于判据是人写的、答案是机器可判的,比让模型给自己打分的排行榜可信得多。38.3% 这个数字也提醒一件事:在「读文件 + 改表格」这种看起来最像日常办公的场景上,前沿模型离「可用」还有明显距离——而这类任务恰恰是 agent 商业化叙事里最常被引用的场景。
来源:arXiv · https://arxiv.org/abs/2611.17766 · 2026-11-13(预印本)
5. 2611.17696 Co-Sight Harness:不改模型,把流程与知识搬到模型外面
长程业务流有两个失效模式:链条越长误差越累积;某个环节需要的知识与用户的说法不在同一套词汇里。Co-Sight 不微调模型,而是把流程定义、状态、领域知识做成版本化的「控制资产」放在模型之外,执行时由状态机与机器可校验的验收门强制,结束后由独立 auditor 给整条轨迹打分;资产更新必须先过回归检查 + 人工批准。三个已上线、超过 200 步的流程;其中一个域 120 例端到端评测:无人值守完成率 50% → 100%、检索召回 56% → 91.67%,端到端延迟下降。
判断:这是本期「验证器」主线的企业版答案——可靠性来自外置的判据与状态机,而不是更听话的模型。注意它的成功前提:流程能被写成状态机。这正是它只报了「三个已上线流程」而不是通用 benchmark 的原因,可迁移性要打问号。
来源:arXiv · https://arxiv.org/abs/2611.17696 · 2026-11-13(预印本)
6. 2611.17682 agent 写的启发式,在未解算例上压过商业求解器
只用开源工具的前沿模型当编码 agent,去解作业车间调度:10 万工序的 tai_100_1000_1 上得到 525,515,低于 OptalCP、Hexaly 与 CP Optimizer;同一份代码不改,改进了该族全部十个算例并攻下两个。等预算、同工作站的对比更硬:距下界 0.0–1.8%,CP Optimizer 2.6–5.8%、Hexaly 2.4–4.4%。柔性作业车间(Behnke-Geiger)改进 11/32 个开放算例,双搬运机器人 MKT 改进 7/10;论文还给出新下界,证明四个已发表的 MKT 值本身不可达。
判断:这是本期最「实」的一条——因为它有独立检查器逐张校验每份排程,且公开了全部运行记录。它说明的不是「AI 会做运筹」,而是**「AI 写代码 + 廉价算力」在特定组合优化上已经能和商业求解器打平甚至更好**,而商业求解器的护城河很大一部分是授权费而非算法。缺点也明显:这是单族、单类问题的攻坚战,没有给出跨问题族的泛化证据。
来源:arXiv · https://arxiv.org/abs/2611.17682 · 2026-11-13(预印本)
五、值得关注的趋势
1. 「谁来判对错」正在从模型属性变成系统组件,而它自己的可信度成了新瓶颈。
本期四条独立证据指向同一处:/teamwork 的 falsifier 层(Lean 内核 / 未改动的原始测试 / 硬件计数器)、Soteria 的执行前形式化验证、Co-Sight 的验收门 + 独立 auditor、Thomson 问题的精确整数算术认证(2611.17776,把 N=912/1382/2502 的能量分别压下 0.0036186/0.0109730/0.0614033 并用整数运算认证)。共同点是判据与生产者隔离、且判据本身可机器执行。但判据的可信度现在成了新瓶颈:Lean 保证的是「证明与陈述一致」,不保证陈述忠实于原问题;GDP.xlsx 的 38.3% 之所以可信,是因为 791 条判据是人写的。所以下一步的竞争不在「谁的模型更会验证」,而在谁拥有可被第三方审计的判据集。
2. 上下文管理正从「压缩」转向「可追溯」,并且开始把状态搬出模型。
CarryOn 用「紧凑状态 + 证据指针」取代摘要,Vision-as-a-Tool 把视觉外置成工具,Co-Sight 把流程与知识做成版本化控制资产,llama.cpp v1.0.0 把 PLE/engram 拆到独立 GGUF 分片(--shard/--ple)——四条不相干的工作在做同一件事:把「agent 记得什么」从 prompt 里搬到可寻址、可版本化、可校验的外部结构。判断:这条线一旦成熟,agent 的记忆问题会从「模型上下文窗口」变成「存储与索引设计」,而后者是传统工程问题,可优化空间大得多。
3. 工具链进入「大版本 + 高频退役」阶段,把模型名写死的成本第一次变得可见。 一周内:llama.cpp 走到 v1.0.0 并承诺 semver、Transformers 到 5.23.0(七种新模型类型)、Copilot 十周内第四波退役、累计 19 个模型、12-14 硬截止、DeepSeek 一次对齐三种 API 协议。把这些放一起看,结论不是「更新快」,而是抽象层的位置在变:上游越频繁地删 API 与退役模型,中间那层「按任务路由 + 按能力而非型号寻址」的价值就越高。反例是 Kimi K3——没有替代品却照样下线,说明厂商的退役节奏不以用户迁移成本为约束。
六、有趣的 AI 开源项目
1. cloudflare/kitesurf:给 agent 用的浏览器,一个实例一个,便宜到可以不共享
11-13 以 Apache-2.0 开源。它不是 Chromium 的精简版,而是整栈跑在 Workers 上、不要浏览器容器:自己解析 HTML、算 CSS、执行页面 JS、出截图;支持 CDP,所以 Puppeteer 可以直接连。组成是一串编译到 WASM 的 Rust 库——Blitz(DOM/布局/绘制)、Stylo(CSS 级联)、Boa(WASM 里的 JS,只在 Dynamic Workers 跑不了时兜底)、Linebender + Krilla(文字排版、2D、PDF)。代码分三块:Engine(会话与连接)、PageScript(页面与其 JS)、PageRenderer(绘制),另有 CLI。本地 pnpm run dev 起在 127.0.0.1:8787,agent 直接把 CDP 指过去就能接管;部署到自己账号需要 Workers Paid(每页一个 Dynamic Worker 做隔离)。
判断:值得跑起来。意义不在替代 Chrome,而在成本结构——官方明说仍在重开发、兼容性靠 WPT 追,所以现在别指望它跑复杂 SPA;但「比完整浏览器省 CPU/内存、按需横向扩」这个定位,正好对上 agent 场景里最常见的那种「要抓十个页面、每个只用一次」的负载。
来源:Cloudflare · https://blog.cloudflare.com/kitesurf-open-source/ · 2026-11-13(补录)
2. ChromeDevTools/chrome-devtools-mcp v1.13.0:不改站点代码,给运行中的页面加日志、伪造后端响应
57,041★ / Apache-2.0。v1.13.0 加了两件对 agent 调试很实用的事:logpoints(在运行中的页面上加日志而不改源码)与 network mock(伪造网络响应)。对 coding agent 来说,这等于把「复现—观察—改—再验」的循环缩短到不必重启页面。
判断:这类 MCP server 的价值全在「让 agent 获得可验证的观测」,而不是让 agent 多会几个动作。logpoints 尤其关键——它把「加 printf 调试」这件人类最常用的手段交给了 agent,且不污染用户代码。
来源:GitHub · https://github.com/ChromeDevTools/chrome-devtools-mcp/releases/tag/chrome-devtools-mcp-v1.13.0 · 2026-11-15(星数为 11-15 读数)
3. backnotprop/plannotator:在浏览器里评审 agent 的计划与补丁
11,921★ / Apache-2.0。给 coding agent 一个独立的评审屏:人在计划或 diff 上直接标注,而不是在聊天里来回争。配套的 plannotator-tui 把同一套批注搬到终端的 Markdown 上。
判断:思路可借鉴——把「人审批」做成一个有界面、可留痕的对象,而不是聊天里的一句「看起来可以」。这与本期「验收门 + 独立 auditor」的方向一致:审批要被当成数据,而不是对话。缺点是它假设你愿意离开终端去看浏览器,习惯了纯终端的人未必买账。
来源:GitHub · https://github.com/backnotprop/plannotator · 2026-11-16(星数为 11-16 读数)
4. Superfluid:把一台机器里的多个 runtime、和一堆闲置的机器,合成一个本地推理服务
2611.17753(11-13 提交,开源)。单机内一个调度器管多个 runtime(MLX / BaseRT 等,各跑在隔离的 worker 进程里):把交互式请求排在 agent 批量工作之前、多个请求共享的 prompt 只算一次、每个 token 先写持久日志再回客户端(断线可续)。跨机则把多台不同厂商的闲置机器组成一个服务面。
判断:家庭/小团队本地推理的真实痛点是「机器闲着、显存不够、请求互相抢」,它对着这三点各给了一个机制。持久 token 日志那条尤其适合 agent 场景——agent 断线重连比人频繁得多。
来源:arXiv · https://arxiv.org/abs/2611.17753 · 2026-11-13(预印本,附开源实现)
⚠️ 待核实
1. Claude for Manufacturing:17 项技能 + 4 个连接器(首发日 11-12)
两家行业媒体一致(Automation Magazine 11-13 的新闻稿电头为「Nov. 13, 2026, San Francisco」,ClawdBytes 11-14 复核),内容为 17 项面向报价、检验失败、设备故障诊断、替代供应商、Fusion 设计对比、生产报告的技能,4 个连接器是 Autodesk Fusion / Infor / Microsoft 365 / Oracle NetSuite,企业版免费安装、需人工签核,11-17 有网络研讨会。
缺什么:anthropic.com/news/claude-for-manufacturing 返回 404,anthropic.com/news 首页最新只到 11-10、分页未加载,「See more」后的条目无法抓取。需官方 news 页或产品页确认后再入正文。关联但不重复:11-13 期已收 Infor 自有的 Infor Industry AI for Claude 插件(PRNewswire 一手稿)。
2. WSJ 报道「NVIDIA 为买方贷款提供担保,以便其继续购买 GPU」(11-14 前后) 目前只有 wccftech 等二手转述,WSJ 原文在付费墙后、本环境不可读,NVIDIA 无公开回应。 缺什么:WSJ 原文或 NVIDIA 的 8-K / 声明。不得作为正文事实引用。
3. OpenAI 解散独立机器人团队(Fortune,11-13) Fortune 称该团队被并入核心研究与产品团队,理由是通用模型可直接驱动机器人。OpenAI 无单独公告。 缺什么:官方确认或第二家具名一手报道。Fortune 不在白名单内,单源不足以成条。
4. Haru-4B 全双工语音模型(11-16)
聚合站描述为 Apache-2.0、边说边听的「电话式」语音模型。
缺什么:huggingface.co/higurashi-ai/Haru-4B 本环境 fetch failed(该域名长期不可达),没有模型卡、参数、许可的一手确认。不进正文。
本期淘汰记录
- 脚本判 DUP 淘汰 2 条:① 美团 LongCat-2.5「11-15 开放权重」——HF 仓库重报,11-11 期已记 MIT 开源、W4A4、1.6T/48B 激活与 194 卡昇腾部署,本次无新规格;② NVIDIA 向 Anthropic 私募 100 亿美元——11-11 期 L825 已含七家合计 $260 亿 N 类明细(谷歌/英伟达各 $100 亿),11-15 的 El País 与聚合站属重推。
- REVIEW 复核后淘汰 5 条:① Microsoft 365 全球故障(超 20 小时、74 国)——时效不符,事件主体在 11-12→13,一手状态页已归档,且 11-13 期已覆盖相关影响面;②「Anthropic IPO 超额认购 6 倍」——仅 AI 生成型聚合站单一来源,无路演簿记一手信息;③ Google 智能眼镜预购——11-13 期已收($395 起、12-10 开售);④ Antigravity v2.29 Remote Agents——无可访问的 release note 或官方 changelog;⑤ Unsloth Dynamic v3.1(Qwen3.8-27B GGUF +5–10% 准确率)——官方 docs 页本环境不可达,仅聚合站描述,缺一手数字。
- 语义兜底合并 4 组(不同 URL、同一事件):Poppy 1.0(aibacon / code404zero / frontiernow / 腾讯新闻 4 家 → 1 条,来源栏写 Sierra 一手);
/teamwork(Times of AI / TSNMedia / Digital Editorial / Sanctity 4 家 → 1 条,并把第三方对 5,000 万行中「仅 23.9 万行是可读证明代码」的复核写进正文);MadPot×ARTEX(eyeon / wpnews / aichatdaily / cybernoz / explainx 5 家 → 1 条,来源栏写 AWS);DeepSeek 工具箱(aibriefing / aistart 等 3 家 → 1 条,来源栏写官方 API docs)。 - 翻案 1 条:DeepSeek「V4.1-Flash App 工具箱」被脚本判 DUP(强键命中版本串
v4.1,指向 10-19 期 L296 的 V4.1-Flash-1017 更新)。人工复核:10-17 那条是 Search & Fetch 两个独立接口,本次是三种协议内的五个内置能力 + 独立 OCR/ASR/TTS + 开源 chat 前端,属新事件,按 NEW 收录并以「补录」标注。 - 补录 9 条:Poppy 1.0、DeepSeek API、Copilot 退役、
/teamwork、Kitesurf、llama.cpp v1.0.0、Transformers v5.23.0、Claude Code v2.1.325、MadPot×ARTEX —— 均首发于 11-13 10:00(上期截稿)之后,11-14/11-15 无刊,故不属「当日新增」但不可丢弃。 - token 账:全量索引 259,120 字符 ≈ 95,970 token → 预筛后需读 26,143 字符 ≈ 9,683 token,压缩 9.9×;两轮预筛(二手线索 36 条 → 一手 URL 22 条)后才定稿。
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止日期(如有) |
|---|---|---|---|---|---|---|
| 1 | 一 | Releasing Personal Agent Protocol 1.0 | Sierra | https://sierra.ai/blog/releasing-poppy | 2026-11-13 | 2026-11-13(规范页仍标 Draft 1.0;设计伙伴 100+) |
| 2 | 一 | The full DeepSeek App experience, now via API | DeepSeek | https://api-docs.deepseek.com/news/news261113 | 2026-11-13 | 2026-11-13(定价表为动态组件,数值未取到) |
| 3 | 一 | Upcoming deprecation of selected GitHub Copilot models in December | GitHub | https://github.blog/changelog/2026-11-13-upcoming-deprecation-of-selected-github-copilot-models-in-december | 2026-11-13 | 生效日 2026-12-14 |
| 4 | 一 | A step toward defining the Standard Model on a lattice | OpenAI(Nathaniel Craig) | https://openai.com/index/step-toward-defining-the-standard-modelhttps://openai.com/index/our-new-blog-for-science | 2026-11-15 | 预印本 2026-10(arXiv 2610.09093) |
| 5 | 二 | llama.cpp v1.0.0 | ggml-org | https://github.com/ggml-org/llama.cpp/releases/tag/v1.0.0 | 2026-11-13T10:20Z | 同日 ggml v1.0.0 |
| 6 | 二 | Advancing science and engineering with Antigravity's /teamwork | Google Research(Vahab Mirrokni) | https://research.google/blog/advancing-science-engineering-with-antigravitys-teamwork-feature/ | 2026-11-13 | 2026-11-13(全部厂商自报;直连失败,经 4 家转引核对) |
| 7 | 二 | Transformers v5.23.0 | Hugging Face | https://github.com/huggingface/transformers/releases/tag/v5.23.0 | 2026-11-13T14:10Z | 2026-11-13 |
| 8 | 二 | Claude Code v2.1.325 | Anthropic | https://github.com/anthropics/claude-code/releases/tag/v2.1.325 | 2026-11-13T20:40Z | 2026-11-13(安全项未给 CVE) |
| 9 | 二 | llama.cpp b12428(含 b12422→b12423 回滚) | ggml-org | https://github.com/ggml-org/llama.cpp/releases/tag/b12428 | 2026-11-16T00:12Z | 事件窗 2026-11-15 19:29Z → 11-16 00:12Z |
| 10 | 三 | Amazon Threat Intelligence observes threat actors running cybercrime campaigns with ARTEX AI agents | AWS Security Blog(CJ Moses) | https://aws.amazon.com/blogs/security/amazon-threat-intelligence-observes-threat-actors-running-cybercrime-campaigns-with-artex-ai-agents/ | 2026-11-13 | 观察窗 2026-10-03 → 11-05;attribution 为 moderate confidence |
| 11 | 三 | Tech companies are trying to shift the entire concept of privacy (again) | EFF | https://www.eff.org/deeplinks/2026/11/tech-companies-are-trying-shift-entire-concept-privacy-again | 2026-11-15 | — |
| 12 | 四 | Soteria: Formally Verified Planning with Runtime Enforcement for Safe LLM Agents(2611.17880) | arXiv | https://arxiv.org/abs/2611.17880 | 2026-11-13 | 预印本 v1 |
| 13 | 四 | CarryOn: Learning What to Keep in Context for Long-Horizon LLM Agents(2611.17808) | arXiv | https://arxiv.org/abs/2611.17808 | 2026-11-13 | 预印本 v1 |
| 14 | 四 | Vision-as-a-Tool: Visual Harness for Multimodal Agentic Coding(2611.17797) | arXiv | https://arxiv.org/abs/2611.17797 | 2026-11-13 | 预印本 v1 |
| 15 | 四 | GDP.xlsx: Benchmarking Frontier Models on Professional Workbooks(2611.17766) | arXiv | https://arxiv.org/abs/2611.17766 | 2026-11-13 | 20 个模型配置;公开 3/70 任务 |
| 16 | 四 | Co-Sight Harness: Externalized Control Assets…(2611.17696) | arXiv | https://arxiv.org/abs/2611.17696 | 2026-11-13 | 3 个已上线流程(>200 步) |
| 17 | 四 | Agent-written heuristics versus commercial solvers…(2611.17682) | arXiv | https://arxiv.org/abs/2611.17682 | 2026-11-13 | 等预算同机对比;全部运行记录公开 |
| 18 | 四 | Certified Improvements to Best-Known Thomson-Problem Configurations…(2611.17776) | arXiv | https://arxiv.org/abs/2611.17776 | 2026-11-13 | 精确整数算术认证;对标 CCD 2026-10 版 |
| 19 | 六 | chrome-devtools-mcp v1.13.0 | Chrome DevTools | https://github.com/ChromeDevTools/chrome-devtools-mcp/releases/tag/chrome-devtools-mcp-v1.13.0 | 2026-11-15 | 57,041★(11-15 读数) |
| 20 | 六 | plannotator | backnotprop | https://github.com/backnotprop/plannotator | 2026-11-16 | 11,921★(11-16 读数) |
| 21 | 六 | Kitesurf is now open source | Cloudflare | https://blog.cloudflare.com/kitesurf-open-source/ | 2026-11-13 | 2026-11-13(仓库 Apache-2.0) |
| 22 | 六 | Superfluid: Local AI Server for Distributed LLM Inference(2611.17753) | arXiv | https://arxiv.org/abs/2611.17753 | 2026-11-13 | 预印本 v1,附开源实现 |
引用提醒:本期所有厂商自测 benchmark 均已在正文与上表标注「厂商自测、无独立复现」;
/teamwork的 Lean/Rust 行数为 Google 自报,其中 Courtade–Kumar 的 5,000 万行另有第三方计数(约 23.9 万行可读证明代码),已在正文并列。两张配图为依据上述来源自绘,非原文插图。凡一手源不可达或仅单源者已列入「⚠️ 待核实」,不进入正文结论。