AI DAILY
AI 日报 2026-11-21
一句话结论同一天里三条曲线朝相反方向走:模型侧把「推理深度」压进 26.4B 的本地权重(Inkling 2 Mini 用三层循环换 1.51–1.91× 计算等效),资本侧用纳指 -5.3%、英伟达 -14% 给「算力换增长」重新定价,而那份宣称证明黎曼猜想的 1737 万行 Lean 代码提醒所有人——能力已经跑在验证前面,作者自己写的也是「I believe」,不是「I proved」。
AI 日报 2026-11-21
整理日期:2026-11-21 素材来源:白名单一手信源优先(厂商官方博客 / release notes / arXiv abs 页 / GitHub release / 个人研究者原始声明),逐条见文末附录;二手媒体只用于发现线索,命中后回溯一手源 可信度提示:统计窗口 2026-11-20 00:00 → 11-21 09:56 HKT(约 34 小时)。窗口内收录 20 条,无补录。arXiv 口径:11-20(周五)提交批次在周六运行时尚未公告(arXiv 周五提交于周日 20:00 ET 公告,本环境查询返回 0 条),故论文取 11-19 提交批次(cs.AI 202 篇,ID 段 2611.26407–26624),均为本期首次收录,正文日期写提交日。厂商自测数据一律标注「厂商自测、无独立复现」;黎曼猜想一节的性质是「个人声明 + 代码公开」,截至发稿无独立方完成复核,已在节内与会末分别说明。市场类条目的「发布时间」与「数据截止时间」分开标注。 配图:文中 3 张图为自绘,非原文插图
#AI日报 #模型动态 #推理优化 #AI资本市场 #去重
一句话结论
同一天里三条曲线朝相反方向走:模型侧把「推理深度」压进 26.4B 的本地权重(Inkling 2 Mini 用三层循环换 1.51–1.91× 计算等效),资本侧用纳指 -5.3%、英伟达 -14% 给「算力换增长」重新定价,而那份宣称证明黎曼猜想的 1737 万行 Lean 代码提醒所有人——能力已经跑在验证前面,作者自己写的也是「I believe」,不是「I proved」。
一、模型与产品
1. Thinking Machines 发布 Inkling 2 Mini:26.4B 循环 MoE,20GB 跑在笔记本上
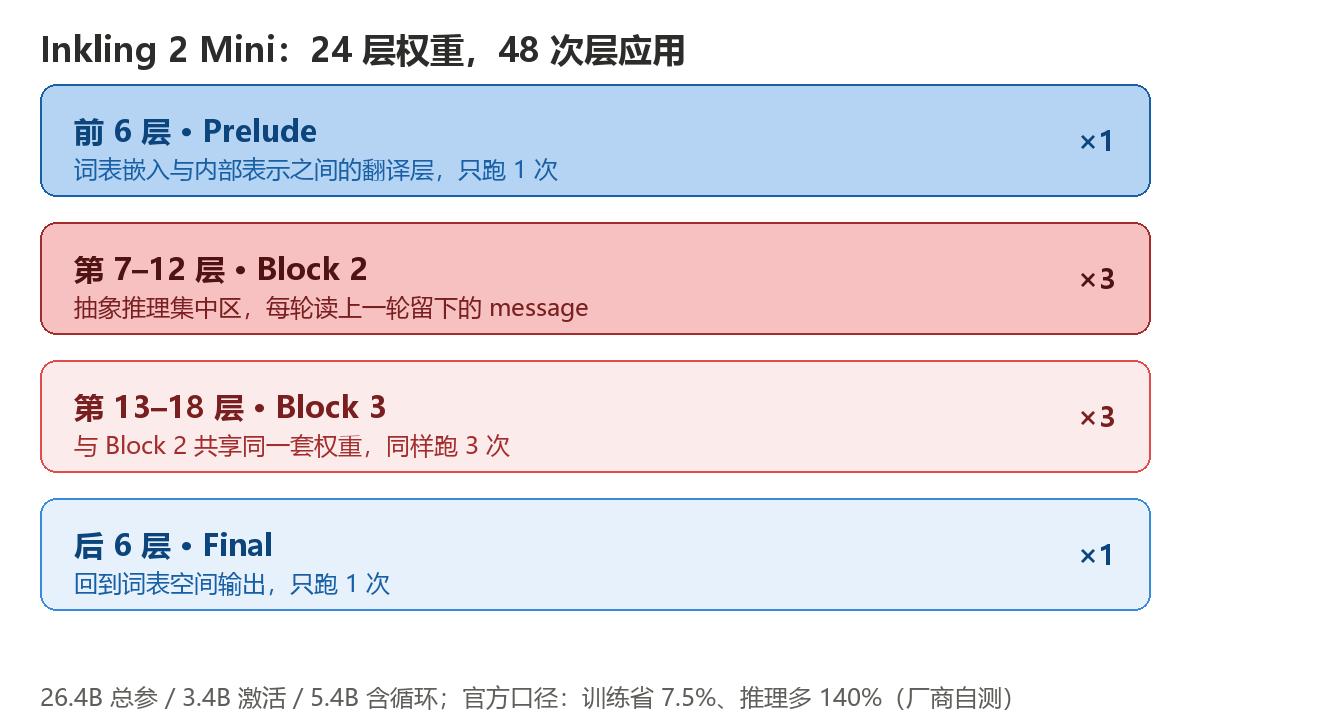
Inkling 2 Mini 是 24 层 MoE,切成 4 个 6 层块:前 6 层与后 6 层各跑 1 次,中间两个块(第 7–18 层)共享权重跑 3 次,于是 24 层权重产生 48 次层应用。总量 26.4B 参数 / 3.4B 激活 / 5.4B 含循环的权重激活,专家从 384 剪到 128(剪掉三分之二),大部分权重以 NVFP4 训练并部署、最后 4 层用 MXFP8,官方给出的内存占用约 20GB——足以在消费级笔记本与桌面 AI 计算机上跑。
官方口径的分数只给了两项:DeepSWE v1.1 48.2%、Vals Index v2.2 46.5%,称在 100B 以下开放权重模型里领先;并强调「比同等表现的模型更快」。更有价值的是三组工程数字:中间层循环在 28 项评测中的 27 项优于末尾层循环;训练第 2,000 步时,不做循环的基线要 1.51–1.91× 算力才能追平中间循环的 loss,末尾循环只要 1.24–1.36×;不做循环的模型训练省 7.5% 算力,但在 512K token 的 agentic 轨迹上要 多 140% 推理算力才能追平。
随模型一起放出的还有一个变循环(variable-loop)研究检查点,用来量「循环对可监控性的影响」:不做 CoT 的时间跨度从 1 轮的 16 秒升到 3 轮的 37 秒,串行推理基准一直涨到 10 轮(训练时只用了 3 轮),CoT 变短但保持可读,agentic sabotage 测试没有随循环上升。
批判性判断:这是今天最有含量的一条,因为它不是一个更高的分数,而是一个成本位置的迁移——训练省 7.5%,推理多付 140%。官方也没有藏短板:MultiChallenge 50.0%、ComplexConstraints v1.1 33.4%,两项都落后 Qwen3.8-27B,CritPt v2 与 HLE-Diamond 也不如更大模型;并明确写「循环增加的是串行计算深度,不是知识容量」,事实性问答只能靠搜索与工具补。真正需要留意的是那句「reasoning effort 调到最低也关不掉中间层的三次循环」——这类架构把推理预算从「可调参数」变成了「结构常数」。
来源:Thinking Machines Lab 官方博客 · https://thinkingmachines.ai/news/inkling-2-mini/ · 2026-11-20
2. ChatGPT 把 Library 换成 Space:页面和幻灯片变成可多人协作的画布
OpenAI 面向全球 Plus(18 岁以上) 推送 ChatGPT Space:在其中创建可交互的页面与演示文稿,邀请同样有 Space 权限的人一起编辑,页面能被设定为随已连接的应用与工具自动更新(官方举例:自动刷新的待办清单、带 3D 模型的学习指南、跟着 Slack 决策走项目计划)。评论区 @ChatGPT 即可提改动;有 dot 的用户还能把 dot 拉进来协作。Space 取代侧边栏里的 Library,成为页面、幻灯片、图片与上传文件的新家;Web、桌面、iOS、Android 都可创建与编辑。
限制同样明确:打开共享页面需登录 Plus / Pro / Business / Enterprise,Free 用户打不开,且没有公开链接。
批判性判断:这不是新模型,是把「生成物」升级成「有状态的协作对象」——从一次性输出变成挂在账号上、能被别人改、能被外部数据源推动的活文档。它真正的竞争对手不是文档工具,而是「你还需不需要把结果导出」。风险点在权限模型:能读已连接应用、又能被他人邀请协作,一旦分享粒度设计不当,泄漏面会从「一份文件」扩大到「一个持续同步的数据视图」。
来源:OpenAI Help Center · ChatGPT release notes · https://help.openai.com/en/articles/6825453-chatgpt-release-notes · 2026-11-20
3. Claude 的 computer use 开给 Team 与 Enterprise:默认关闭,Owner 手动开
Anthropic 在 11-20 的 release notes 里把 computer use 的 beta 扩到 Team 与 Enterprise:Claude 能看屏幕、在用户授权的桌面应用里操作,入口是「新版 Claude 体验」中的 Claude Desktop,网页版与移动端在开启 Computer access 后也可调用(需有已连接的电脑)。功能默认关闭,正按组织逐步推出。
批判性判断:企业侧真正被卖的不是「能点应用」,而是开关在谁手里——默认关、Owner 开、按组织灰度,这三个设定决定了它能不能过 IT 审批。但 release notes 依旧没有给任务成功率,也没有给「误操作后的回滚/审计」细节;对 Team/Enterprise 而言,后者比能不能点更关键。
来源:Anthropic 官方 release notes · https://support.claude.com/en/articles/12138966-release-notes · 2026-11-20
4. Google 把 Connected Apps 接进搜索与 Gemini:在美国直接下单、查信用、算税
Google 通过 Search 与 Gemini 应用推出 Connected Apps,底层是 Universal Commerce Protocol:接入 Albertsons / Safeway / Shaw's / Target 可生成购物清单并在搜索内结账;Experian 从 Gemini 扩到 Search,可查信用分、挑选个人贷款;H&R Block 可在 Search 内算税与估算退税;本地服务 Angi / Thumbtack 将在未来几周上线。仅限美国,且仅覆盖已接入的合作方。
批判性判断:这是「入口即交易」的一步——把搜索从信息检索变成事务执行,代价是把商业关系写进结果排序。它与 10-28 那版「第三方 MCP 应用可提交进 AI Mode」是同一策略的两层:底层开放提交,表层由 Google 亲自签合作方。真正的问题是披露:当结账发生在搜索结果页内,用户还能不能分辨「这是推荐」还是「这是货架」。
来源:Google 官方博客 · https://blog.google/products-and-platforms/products/search/connected-apps-holiday-errands/ · 2026-11-20
二、工程与架构
1. litellm 一夜三连发:为两家厂商的「静默行为变更」打补丁
11-20 凌晨 3 小时内 litellm 连发三版:v1.109.3(03:59Z,6 PR)修 GPT-6.2 的系统提示在 /v1/chat/completions 与 /v1/messages 上不命中 prompt cache(除非带 store: false);v1.110.2(04:06Z,11 PR)修 temperature=1 在「已移除采样参数的 Claude 模型」上返回 400(自 v1.110.0-rc.2 起坏)以及 Responses API 流在输出达上限后仍重试;v1.111.0-rc.3(05:55Z,15 PR)继续跟进。
批判性判断:一条网关在一夜之间为两家厂商各打一个补丁,暴露的是同一个趋势——模型侧行为不再跟版本号走,而是服务端灰度下发。缓存是否命中、采样参数是否还被接受,这些都不在 SDK 的语义里,只能靠网关方从 400 与账单里反推。对自建推理栈的团队,这意味着「锁定版本」已不足以锁定行为,必须自己埋账单级回归。
来源:litellm GitHub Releases · https://github.com/BerriAI/litellm/releases/tag/v1.109.3 / https://github.com/BerriAI/litellm/releases/tag/v1.110.2 · 2026-11-20
2. llama.cpp b12600 同日接住 Inkling 2 Mini:图里开始出现「循环」
Inkling 2 Mini 发布当天,llama.cpp 的 b12600 构建合入对应支持(PR #32694):转换脚本、独立 model_type、构建期从 metadata 取 gate_rank,以及两个新概念——Loop graph 与 is_varloop 属性,变量循环版本也一并纳入命名体系。
批判性判断:这条的价值不在「又支持一个模型」,而在推理框架的图结构第一次需要表达「同一份权重跑多次」。过去 llama.cpp 的图是前向 DAG,权重按层号寻址;循环架构要求同一段图被复用、且每次复用要带上一轮的中间态(message)。这类改动会外溢到 KV cache 管理与投机解码的假设,值得盯后续几个构建。
来源:llama.cpp GitHub Releases · https://github.com/ggml-org/llama.cpp/releases/tag/b12600 · 2026-11-20
3. TRQ:视频 DiT 的 KV-Cache 压到 2 bit,靠「按视频在线拟合旋转」
视频扩散 Transformer 在去噪步之间复用 KV cache,长视频时成为瓶颈。作者的观察是:时间上相距很远的 cache 向量取值范围大、量化误差高,但时间相邻的 token 在 KV cache 里存在稳定的逐通道模式,且该模式随视频变化。TRQ 因此对时间相邻的 cache 块在线拟合一个正交变换(把逐通道均值压向常值),再用「2×2 平面旋转树 + 共享 Hadamard」参数化,每个旋转只存 2 bit、不需梯度也不改模型权重,并证明贪心拟合在「均值压平」目标下全局最优;配套放出融合 Triton kernel。2 bit 同压缩率下,VBench 主体一致性从 QVG 的 90.38 升到 92.02(LongCat-Video-13B)、86.33 升到 87.61(HY-WorldPlay-8B)。
批判性判断:这是「量化粒度从通道挪到时间」的一个漂亮切口——它利用的是视频数据本身的时间冗余,而不是换更聪明的量化器。可借鉴的点是「每个输入单独拟合、但拟合结果小到能塞进 2 bit/旋转」,这条思路对任何带时序冗余的 cache 都成立。要小心的是它只报了同一压缩率下的画质分,没报端到端延迟增益。
来源:arXiv 2611.26334 · https://arxiv.org/abs/2611.26334 · 2026-11-19(提交)
4. ClonAct:把「上下文」当资源做虚拟化,真冲突合并从 33.3% 提到 63.3%
多任务并行的 agent 把多个对话塞进一条线性会话,会出现跨主题约束串味与队头阻塞;改用「路由 + 工单」的层级结构,又会在合并时丢信息:真冲突场景的三次运行均值只有 33.3%,尽管各分支单独跑通过率很高。ClonAct 改为无路由架构,直接虚拟化上下文块:可插拔的单趟非生成式 Context MMU、原地 Context Cells、带隔离试合并闸门的 Synaptic Bus、以及波次冲刷的 Shared Trunk。结果:试合并闸门把真冲突合并提到 63.3%,ClonAct 以 少 45.9% 的 prompt token 达到同一上限,并在连续突发流下取得 95.0% 的最高完成率与最低中位等待。
批判性判断:「routerless + 上下文虚拟化」这个方向比再加一层调度器更接近操作系统该做的事——把上下文当页表管,而不是当消息队列管。局限也清楚:基准是三个程序化多流任务,不是真实混合负载;43% 的真冲突仍未解开,说明「隔离试合并」只是把错误率从灾难级降到可用级。
来源:arXiv 2611.26346 · https://arxiv.org/abs/2611.26346 · 2026-11-19(提交)
三、行业与发展
1. 11-20 美股:AI 交易单日重定价,纳指跌 5.3%、英伟达跌 14%
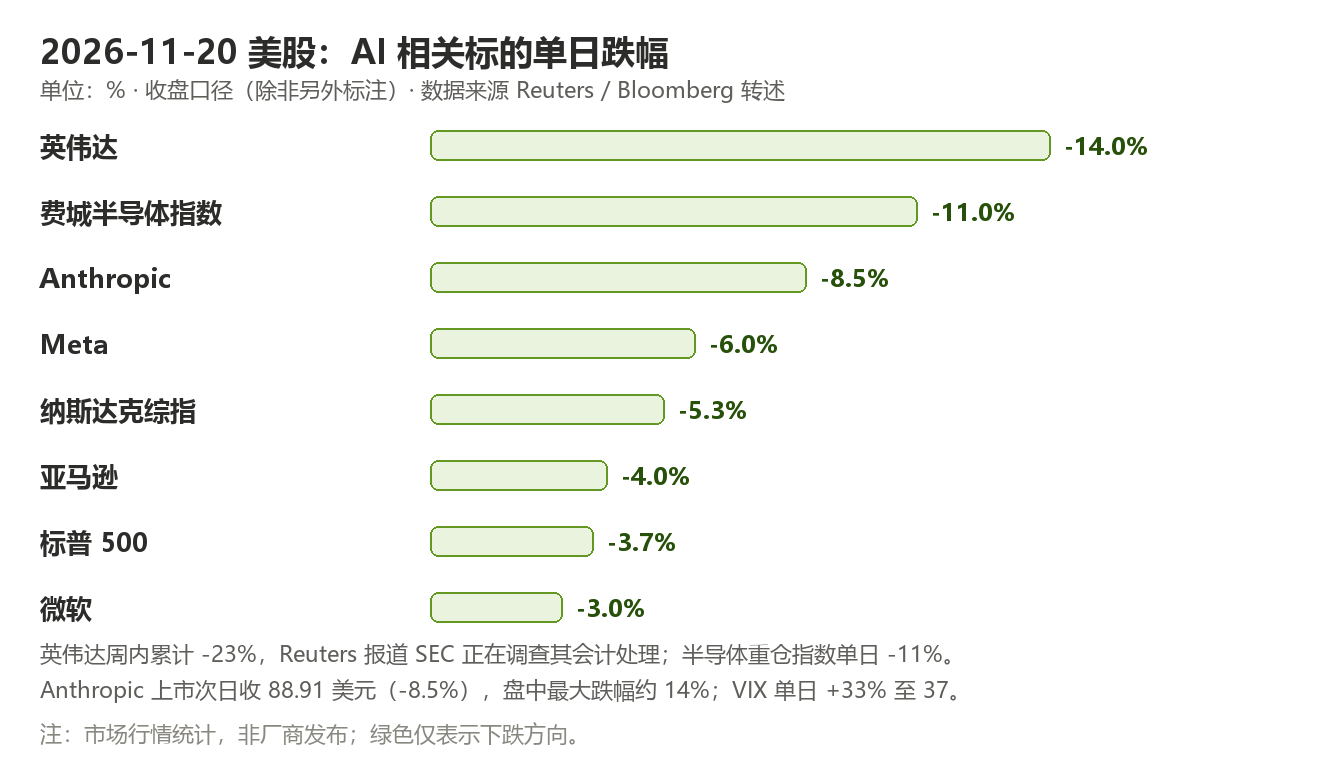
周五美股在 AI 板块领跌下大幅收低:纳斯达克综指 -5.3%(周跌 10%,2020 年 3 月以来最差单周)、标普 500 -3.7%(七连阴)、半导体权重指数 -11%、VIX 单日 +33% 至 37、10 年期美债收益率下行 12bp 至 4.93%。英伟达单日 -14%、周内 -23%,Reuters 报道美国监管机构正在调查其会计处理;Anthropic 盘中最大跌幅约 14%。多家机构的共同说法是:市场不再只要求「AI 需求被证明」,而是要求「生态里的巨额开支能产生可持续回报」。
批判性判断:把这条和本期的 Inkling 2 Mini 放在一起看才有意义——单位智能的成本在下降,资本的回报预期也在下降,两者并不矛盾。真正被重定价的不是「模型还能不能变强」,而是「谁替这轮算力付账、多久能收回」。对工程团队的可执行含义:算力预算的审批会变严,而「同效果更低成本」的证明会比「更高分」更值钱。
来源:Reuters(Yahoo Finance 转载全文)· https://finance.yahoo.com/markets/stocks/articles/nasdaq-plunges-5-day-anthropic-211724232.html · 2026-11-20(数据截止 2026-11-20 美股收盘)
2. Anthropic 完成 IPO 交割:11.27 亿股、募资约 935 亿美元;次日收跌 8.5%(更新)
Anthropic 11-20 公告完成 IPO 交割,含承销商全额行使超额配售权:共发行 11.27 亿股 A 类普通股(其中超额配售 1.47 亿股),发行价维持 $83,同时完成同步私募配售的交割;按含超额配售口径,总募资约 935 亿美元,超过 SpaceX 成为史上最大 IPO。
同日盘面给出的是另一个答案:股价收 88.91 美元(-8.5%),距发行价仅 6 美元;Reuters 引 Vanda Research 称散户在上市首日成交逾 7.5 亿美元、为 2012 年有记录以来最大首日成交额,但净买入低于 SpaceX;承销商摩根士丹利已结束用于稳价的仓位;按最新价计市值约 1.2 万亿美元(完全稀释约 1.6 万亿),约为过去 12 个月销售额的 40 倍。
更新(首报 11-19 定价、11-19 首日行情):这次新增的是「交割完成 + 超额配售全额行使」这个确定事实(发行股数从 9.8 亿变为 11.27 亿),以及首日之后的第二个交易日表现。规模与股价分开看:募资规模创纪录,不等于定价被认可。
来源:Anthropic 官方公告 · https://www.anthropic.com/news · 2026-11-20;Reuters(Yahoo Finance 转载)· https://finance.yahoo.com/markets/stocks/articles/anthropic-retail-traders-face-losses-181550095.html · 2026-11-20(数据截止 2026-11-20 收盘)
3. Oracle:OpenAI 的基建合同「资金已到位」,Abilene 园区接近完工
在 AI 交易最难看的一天,Oracle 出来给了一条反向信息:与 OpenAI 的基础设施合同资金已全部到位(本月完成的最后一轮融资之后),投资者日公布的融资方案包含供应商融资,均已落地;双方计划在美国新增 4.5 吉瓦数据中心容量,在 Abilene(GPT-6 Astra 的训练地)之外再建;Abilene 园区接近完工,位于 Shackelford County 的下一个吉瓦级园区已获全部许可,英伟达下一代 Vera Rubin 机柜将在未来几周交付。消息后 Oracle 盘后一度涨 3.3%。此前公司已宣布 200 亿美元融资(约 100 亿股 + 100 亿债)。
批判性判断:「资金已到位」是对「OpenAI 付不付得起」这个疑问的直接回答,但它只回答融资侧,不回答回报侧;而市场当天卖的是回报侧。值得记录的是时间点:在英伟达被查会计、AI 板块单日暴跌的同一天,供应链方主动出面稳预期——这类「供应商替客户背书」的表态,本身就是风险集中度的证据。
来源:Reuters(The Star 转载全文)· https://www.thestar.com.my/tech/tech-news/2026/11/21/oracle-says-openai-infrastructure-deal-is-fully-funded-after-final-capital-raise · 2026-11-20
4. 网信办:9–10 月新增 133 款生成式 AI 服务完成备案,累计 1245 款
国家网信办 11-20 发布备案信息公告:2026 年 9 月至 10 月新增 133 款生成式人工智能服务完成备案,其中含 3 款手机端侧服务、1 款拟人化互动服务;1 款备案信息变更。通过 API 等方式直接调用已备案模型的应用/功能新增登记 224 款。截至 2026-10-31,累计 1245 款服务完成备案、955 款应用或功能完成登记。
批判性判断:这组数字的信息量在结构而非总量——首次把「端侧」与「拟人化互动」单列,说明监管口径正在跟随产品形态细化;而「备案 1245 / 登记 955」的比例说明大量应用仍是套壳调用。注意口径:公告发布于 11-20,数据截止 10-31,不能当作 11 月的实时规模。
来源:央视网(云南网转载)· https://news.yunnan.cn/system/2026/11/20/034199569.shtml · 2026-11-20(数据截止 2026-10-31)
四、论文与开源
1. Anthropic 数学家宣称与 Claude 合作证明黎曼猜想:4 页声明 + 1737 万行 Lean
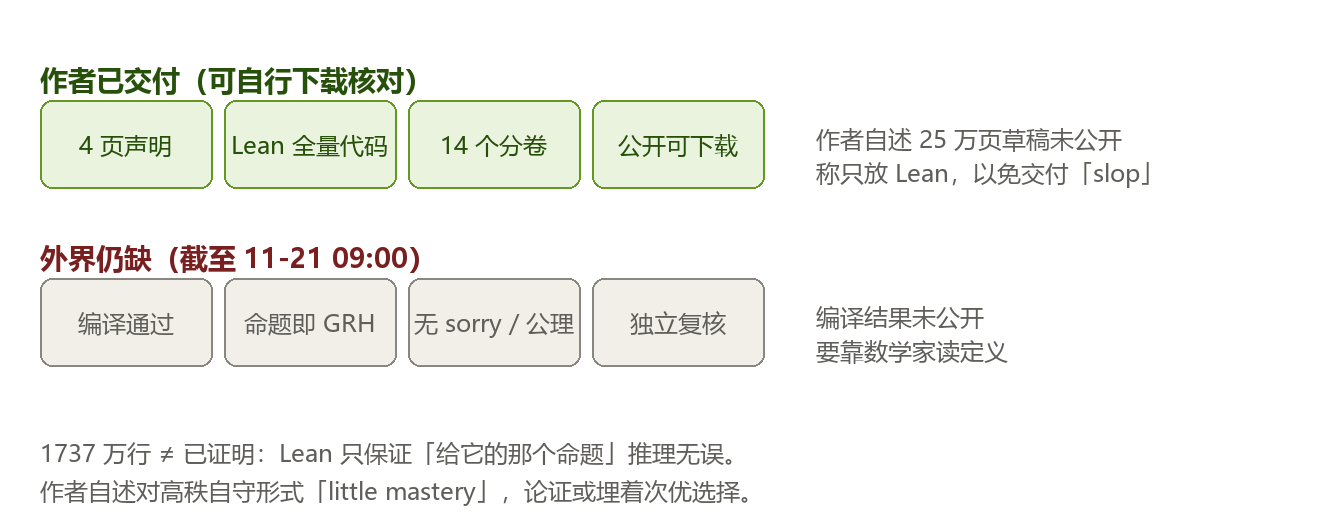
Anthropic 数学家 Levent Alpöge 11-20 在个人网站发布 4 页声明,原话是「I believe I have, working with Claude, discovered a proof of the Riemann Hypothesis」,并称方法可推广到广义黎曼猜想(GRH)、有望进一步处理 ERH,且「Claude and I have also formalized the arguments without assumptions」。交付物是一份 4 页说明 + 14 个分卷的 Lean 代码(alpo.ge/lean.tar.gz.part01…part14);脚注自述草稿「 amused myself, and hit 250,000+ pages」,但认为放一份「massive unreadable travesty of slop」不合适,决定只公开 Lean。时间线由 Claude 整理:10-06 Stepanov 行列式起,到 11-16 只剩「GRH」一行。文中直接回应了「赶在 IPO 次日发布」的质疑,称完成于 IPO 前的周日深夜,并写「There is an obvious cynical view, to do with the timing, but it is false」。
批判性判断:这条必须按「声明」而不是「结果」记录,理由在原文里就能找到三条。其一,Lean 只保证「给它的那个命题」推理无误,不保证该命题就是黎曼猜想——命题定义由作者写,零点、临界线的定义只要与标准数学不符,证出来的就是另一个东西。其二,作者自述并未掌握全貌:对高秩群上的自守形式「little mastery」,并承认可能「baked lots of strange suboptimal choices」;时间线里 Claude 是专家的部分,他自己说是在转述一份可能「make zero sense」的 slop 总结。其三,截至 11-21 09:00 HKT,没有独立方公开确认编译通过与命题一致,Anthropic 官方也未发声明。所以正确读法是:这是一次「交付物公开可查、结论待验」的事件;比起「AI 证明了黎曼猜想」,更该记住的是「证明的规模已经超过人类可读的极限,验证流程本身需要重建」。
来源:Levent Alpöge 个人声明(PDF)· https://alpo.ge/remark.pdf · 2026-11-20
2. MedChemBench:99 道药物化学题,GPT-6.2 Astra 拿到 84.5%
OpenAI 发布药物化学推理基准 MedChemBench,取材 117 篇论文与专利、761 个分子结构,构造 99 道题,模拟研究进行到某一时点时可获得的信息(靶点、研究目标、已测化合物、部分实验结果)。四个评分维度:分子结构还原(原子连接与立体化学)、科学推理(解释必须有证据支撑)、排序与选择、性质预测(与实测/计算值的接近程度,按接近度给部分分)。最高推理档(xhigh)下:GPT-6.2 Astra 84.5%、GPT-6 Astra 83.3%、GPT-6.1 Sol 82.0%、GPT-5.6 Sol 58.2%;GPT-6 Astra 强在结构还原与证据解释,弱在选化合物与数值性质预测。示例题是 PRMT5 抑制剂:要同时预测细胞活性、透膜性、肝酶降解速度,而后续实验显示化合物 23 活性更强、24 透膜更好且降解更慢——考的正是「多个性质互相打架时怎么权衡」。
批判性判断:这类基准的价值在评分粒度而非榜首分数——「按接近实测值的程度给部分分」比二元对错更能区分模型是否真的在做化学推理。但它是厂商自测、题目来自自家构造、无独立复现;且 xhigh 档才 84.5%,说明剩余 15% 集中在最像真实研发的部分(多性质权衡、数值预测),这恰好也是最难被 benchmark 化掉的部分。
来源:OpenAI 官方 · https://openai.com/index/introducing-medchembench/ · 2026-11-20
3. 「该记多少」是模型的属性,不是记忆库的属性
IBM 团队把 agent 的自我学习做成流水线:先从自身轨迹里挖 1–3 条教训(lessons),再合并成少量指南(guidelines),每条指南记录合并了几条教训;推理时给 agent 全量或选中的子集。在 AppWorld(基线完成率 40–92% 的多模型)上的核心发现是:最优记忆量取决于模型。DeepSeek-V3.2 加满 191 条指南后任务完成 +9.5 点、场景完成 +16.1 点;而 gpt-oss-120b 从 39.9% 起,全量 199 条只到 51.2%,换成约 29 条的选中子集反而到 55.4%(两次均值)。作者还老实列了翻车现场:一条高支持度的指南反而拖累、合并时 provenance 被静默丢弃。流水线已开源为 altk-evolve,部署在 IBM CUGA 与 watsonx Orchestrate。
批判性判断:这是「agent 记忆」讨论里少见的负结果优先写法——它没说「越多越好」,而是给出饱和点与反例。对工程的含义很直接:记忆条数应该跟着模型能力调,而不是跟着经验条数涨;弱模型更需要「精选」而不是「全量」。
来源:arXiv 2611.26361 · https://arxiv.org/abs/2611.26361 · 2026-11-19(提交)
4. Seer:给小模型配一个「后果预测器」,GAIA 从 13.6% 到 41.7%
端侧 deep-research agent 用不起大模型,而推理时引导又有三个坑:真跑候选动作会多花工具调用、让 agent 自评受限于它自己的判断、为每个模型单独适配成本高。Seer 把「动作提议」与「后果预测 + 价值估计」拆开:用一批真实研究轨迹离线训练工具响应模拟器(学 call–response 对)与价值估计器(学打了折扣的最终正确率标签),两个模型跨 agent 复用、不再训练;推理时只执行被选中的动作,被丢弃的候选不产生真实工具调用。GAIA 上 Qwen3.5-4B 从 13.6% 升到 41.7%、Qwen3.5-9B 从 22.3% 升到 50.5%。
批判性判断:这是「把探索成本搬到离线」的典型做法——模拟器承担了本该由工具调用支付的代价。但它同时也把风险搬了过去:模拟器一旦对某类工具的响应建模失真,价值估计会在错误的世界里做最优选择,偏差不会在指标上显形。跨 agent 复用是卖点也是隐患(分布漂移)。可借鉴的是只用真实 response 写历史这条工程纪律。
来源:arXiv 2611.26423 · https://arxiv.org/abs/2611.26423 · 2026-11-19(提交)
5. ClosureBench:总体准确率 71%–99%,但「缺信息该当未知还是当假」的切换只有 18%
agent 常在信息不全的记录上答题,而「缺失」到底算未知还是算假,取决于数据源是否完备。现有评测把这件事和其他推理要求混在一起。ClosureBench 把每个基础场景分别放到 OWA / CWA / LCWA 三种封闭假设下,只改变对缺失信息的处理规则;只有三种变体都答对才算基础场景正确。960 个实例上,模型总体准确率 71.18%–99.86%,但在「金标随契约改变」的核心切换题上,核心切换准确率只有 18.23%–99.31%;LCWA 下差异最大——有 agent 在提示明确要求「缺失按假处理」时仍答「未知」。
批判性判断:这是本期最该被工程团队读的一篇。它证明高分可以完全掩盖契约错误:模型把题做对了,但对「数据库里没有这条记录意味着什么」的理解是错的。这类错误在真实系统里不会表现为答错,而表现为静默给出一个自信的错误结论。建议把「缺信息假设」写进 agent 的显式契约,而不是留给模型猜。
来源:arXiv 2611.26335 · https://arxiv.org/abs/2611.26335 · 2026-11-19(提交)
6. 自一致性认证的相关性陷阱:重复采样救不了「整体行为」的结论
把多次采样当成序列证据、用 anytime-valid 的 e-process 在过阈值时停止,是自一致性认证的标准做法;前提是各次 rollout 条件独立。本文指出这个前提在实践里不成立:推理流会通过共享前缀、跨 prompt 异质性正相关,相关系数记为 ρ。后果有四条:(i)标准 betting e-process 只对**「这一次抽样所体现的信念」(realized null)有效,不对「模型的平均行为」(population null)有效;(ii)当作 population 检验读时,交叉概率至少为 π=P(μ(Z)>0),可能超过名义 ε;(iii)组内均值的有效样本量封顶在 1/ρ**,加多少次 rollout 都补不回 population 有效性;(iv)改用 prompt 级 e-process 可恢复有效性,且在纯 rollout 预算下最优分配是每个 prompt 只跑一次。模拟与 Claude Haiku 4.5 的 rollout 都验证了这个区间依赖。
批判性判断:结论很反直觉——在预算固定时,「同一个问题多采几次」可能不如「多问几个问题」。这条对任何用 self-consistency 投票做上线决策的团队都是直接的统计纠偏:你以为在增加证据,其实在重复同一个 latent state。它也给「模型自评很稳」这类结论划了边界。
来源:arXiv 2611.26592 · https://arxiv.org/abs/2611.26592 · 2026-11-19(提交)
五、值得关注的趋势
1)循环架构把成本从训练搬到了推理,而这一天的三条工程工作都在回答「推理这笔账怎么付」。 Inkling 2 Mini 用三次循环换 1.51–1.91× 计算等效,代价是推理多 140%;TRQ 把视频 KV cache 压到 2 bit 换显存;ClonAct 用上下文虚拟化省 45.9% prompt token。三者方向不同,但都在做同一件事:在不增加权重的前提下,把「想得更久」变成可支付的工程参数。判断:下一轮模型竞争的指标会从「多少参数」转向「每 token 的有效层数 / 有效记忆 / 有效上下文」。
2)资本侧与工程侧在同一天朝相反方向走,这不是矛盾,是分工。 纳指 -5.3%、英伟达 -14%、Anthropic 上市次日 -8.5%,卖的是「回报周期」;26.4B 跑在 20GB 内存里、开源权重、DeepSWE 48.2%,买的是「单位成本」。判断:接下来 1–2 个季度的分化会体现在采购上——训练侧预算收紧、推理侧预算向「本地/私有」倾斜,Inkling 这类模型的商业窗口正在这里。
3)验证已经成为比能力更稀缺的资源。 黎曼那份 1737 万行代码的问题不在代码,而在「Lean 证的是不是那个命题」;ClosureBench 显示模型在缺信息假设上的核心切换准确率能低到 18%;自一致性那篇说明我们对「重复采样=更多证据」的统计直觉是错的。三件事的共同点是:我们缺少判定真假的仪器,而不是缺少能力。判断:2027 年真正稀缺的岗位不是「会调模型的人」,而是「能设计验收口径的人」。
4)厂商开始主动写自己的短板,而这是一种新的可信度资产。 Thinking Machines 在发布页直接写 MultiChallenge 50.0%、ComplexConstraints 33.4% 落后 Qwen3.8-27B,并写明「循环加的是串行深度不是知识」;OpenAI 的 MedChemBench 标清 xhigh 档与部分分规则。判断:在自测分数普遍通胀的环境里,愿意标注分母与失败模式的发布方会获得更高的引用权重;但这仍然替代不了独立复现——今天没有任何一条厂商自测被第三方复现。
六、有趣的 AI 开源项目
1. 黎曼 Lean 证明的两个第三方镜像:把「可核对」变成「可复现」
声明发布当天,GitHub 上出现两份第三方镜像:CocoSgt/riemann-hypothesis-lean(291★,Lean,声明为 Alpöge Lean 证明的镜像,署名归原作者)与 Deicyde/riemann-hypothesis(176★,Lean,自述为字节级镜像 + 独立 Comparator 复现环境)。价值不在代码本身——1737 万行没人读得完——而在于把「下载 14 个分卷、校验、在 Lean 里比对命题」这套流程固化成可重跑的环境。Comparator 的作用正是回答那个关键问题:Lean 里被证明的命题,与标准数学定义的黎曼猜想是否一致。
批判性判断:这类仓是「验证基建」的雏形,比任何解读文章都有用;但镜像仓的可信度取决于哈希是否与作者原始分卷一致,目前两个仓都未公开校验和,拿它当证据前必须自己核。星数增长快也可能只是事件热度,不代表质量。
来源:GitHub · https://github.com/CocoSgt/riemann-hypothesis-lean / https://github.com/Deicyde/riemann-hypothesis · 2026-11-20(建仓日)
2. DIYgod/pinky:让任意 MCP agent 操作你的手机,人在环里
Pinky 把手机变成 agent 的执行端:macOS / Windows / Linux 上的 MCP agent(Claude Code、Codex、Cursor 等,或 Pinky 自己)可以操作 iPhone / Android,关键动作由人确认。提供桌面客户端(brew cask / dmg / exe / deb)、可装进 Claude Desktop 的 .mcpb 扩展,设置里的 Agents 一键连接;仓库 2592★,仍在每日发版。本期窗口内两个版本 v2026.1120.1(11-20 06:46Z)与 v2026.1121.1(11-21 01:32Z)都是小修:Safari 网页投屏卡在「正在连接」、带 Touch ID 的设备解锁时改为先点「使用密码」再输入锁屏密码。
批判性判断:它补的是「agent 只有浏览器、没有手机」这个现实缺口,而 human-in-the-loop 的设计让它比纯自动化更适合真实账号环境。风险同样明显:把手机屏幕与输入交给桌面端,等于把第二因素(短信、验证码、支付确认)暴露给 agent 链路——用之前先想清楚这台手机上还登着什么。
来源:GitHub Releases · https://github.com/DIYgod/pinky/releases/tag/v2026.1120.1 · 2026-11-20
⚠️ 待核实
| 条目 | 已知 | 缺什么 |
|---|---|---|
| OpenAI 向开发者开放 GPT-Live-1.1 语音模型 API(11-20) | 多家中文媒体一致报道:全双工、可把复杂任务委托给后端模型且不中断语音对话,10-15 起已是 ChatGPT Plus/Pro 默认语音模型 | 一手页打不开:openai.com/index 下无对应页面,developers.openai.com 与 platform.openai.com 在本环境返回 403。缺官方模型页/定价/限流;缺「哪些区域可调用」 |
| Anthropic 12-01 起把 Team 计划默认切到 chat 与 Cowork 统一体验 | 二手站点称 12-01 默认开启、2027-02-01 下线独立 Cowork、零数据保留组织除外 | 无一手源:11-20 的官方 release notes 只有 computer use 一条;Team setup guide 未取得。缺官方公告链接 |
| 黎曼猜想的独立复核进展 | 作者声明与代码已公开;未见 Anthropic 官方声明 | 缺任何独立方公开的编译结果、命题一致性核对、sorry/额外公理扫描结论。在此之前不应写作「已证明」 |
本期淘汰记录
脚本判 DUP 4 条
- 翻案 2 条:Anthropic「收跌 8.5%」与「纳指跌 5.3%」被判 DUP,原因是百分比里的
8.5/5.3被身份键当成版本号v8.5/v5.3,命中了 10-16 一条「8.5% 次级债」旧行。二者均为窗口内新事件,已保留。 - 真淘汰 2 条:
deepseek-ai/chat-demo(11-19 已收录,本期只是 push)、NVIDIA Vera Rubin MLPerf Endpoints(11-16 已收录,且 11-17 期已翻案过一次)。
REVIEW 12 条:全部是「实体弱键」命中(命中 Google / OpenAI / Anthropic / llama.cpp 这类高频实体,而非同一事件)。逐条读 related_rows 后三选一:保留 7 条(无同事件冲突)、淘汰 2 条——dots 扩量属 11-19 官方公告,在窗口起点之前且上期窗口内已覆盖;Qwen3.8-Max 的百炼文档「更新时间 2026-11-20」只是文档更新,模型本身发布于 2026-08-02,聚合站与部分中文稿把它当成 11-20 新模型,属典型时效误判;转「待核实」2 条(GPT-Live-1.1 API、Anthropic 12-01 切换);合并 1 条(llama.cpp b12600 与 Inkling 2 Mini 合并叙述,避免同一事件写两遍)。
语义兜底 3 条
- 「AI 板块大跌」与「Anthropic 个股 -8.5%」拆成市场 / 个股两条,但共用同一 Reuters 源,附录只列一次全文链接、一次个股链接,避免把同一段落引用两遍。
- 两份黎曼镜像仓合并为一条(同一事件的两个实现)。
- 窗口外或凑数淘汰:NVIDIA Dynamo 的 RL rollout 优化(11-19,窗口外);
bookwjitchieni1986/blender-ai-mcp-addon(建仓与最后一次 push 相差 61 秒、无代码演进,疑似刷星,不进正文)。
token 账:索引全量 299,070 字符 ≈ 110,767 token → 预筛后需读 18,135 字符 ≈ 6,717 token,压缩 16.5×;25 条候选中 9 条 NEW 无需读索引。本期两次跑脚本(初筛 + 回溯一手源后复筛),复筛结论与初筛一致,未产生新的翻案。
附录:来源
| 序号 | 板块 | 标题 | 发布方 | 链接 | 发布日期 | 数据截止日期 |
|---|---|---|---|---|---|---|
| 1 | 一 | Introducing Inkling 2 Mini | Thinking Machines Lab | https://thinkingmachines.ai/news/inkling-2-mini/ | 2026-11-20 | — |
| 2 | 一 | ChatGPT release notes(ChatGPT Space rolling out to Plus) | OpenAI | https://help.openai.com/en/articles/6825453-chatgpt-release-notes | 2026-11-20 | — |
| 3 | 一 | Release notes(Computer use beta for Team and Enterprise) | Anthropic | https://support.claude.com/en/articles/12138966-release-notes | 2026-11-20 | — |
| 4 | 一 | Get your year-end tasks done with new Connected Apps | https://blog.google/products-and-platforms/products/search/connected-apps-holiday-errands/ | 2026-11-20 | — | |
| 5 | 二 | litellm v1.109.3 | BerriAI | https://github.com/BerriAI/litellm/releases/tag/v1.109.3 | 2026-11-20 | — |
| 6 | 二 | litellm v1.110.2 | BerriAI | https://github.com/BerriAI/litellm/releases/tag/v1.110.2 | 2026-11-20 | — |
| 7 | 二 | llama.cpp b12600(Inkling 2 Mini 支持,PR #32694) | ggml-org | https://github.com/ggml-org/llama.cpp/releases/tag/b12600 | 2026-11-20 | — |
| 8 | 二 | Online Temporal Rotations for 2 Bit KV-Cache Quantization in Video Diffusion Transformers | arXiv | https://arxiv.org/abs/2611.26334 | 2026-11-19(提交) | — |
| 9 | 二 | Context as a Resource(ClonAct) | arXiv | https://arxiv.org/abs/2611.26346 | 2026-11-19(提交) | — |
| 10 | 三 | Nasdaq plunges 5% a day after Anthropic debut, but investors still believe in AI | Reuters | https://finance.yahoo.com/markets/stocks/articles/nasdaq-plunges-5-day-anthropic-211724232.html | 2026-11-20 | 2026-11-20 收盘 |
| 11 | 三 | Anthropic retail traders face losses as shares dive 13% the day after debut | Reuters | https://finance.yahoo.com/markets/stocks/articles/anthropic-retail-traders-face-losses-181550095.html | 2026-11-20 | 2026-11-20 收盘 |
| 12 | 三 | Anthropic announces closing of initial public offering… | Anthropic | https://www.anthropic.com/news | 2026-11-20 | — |
| 13 | 三 | Oracle says OpenAI infrastructure deal is fully funded after final capital raise | Reuters | https://www.thestar.com.my/tech/tech-news/2026/11/21/oracle-says-openai-infrastructure-deal-is-fully-funded-after-final-capital-raise | 2026-11-20 | — |
| 14 | 三 | 9—10 月新增 133 款生成式人工智能服务完成备案 | 央视网(国家网信办公告) | https://news.yunnan.cn/system/2026/11/20/034199569.shtml | 2026-11-20 | 2026-10-31 |
| 15 | 四 | Remark on the Riemann Hypothesis(4 页声明) | Levent Alpöge | https://alpo.ge/remark.pdf | 2026-11-20 | — |
| 16 | 四 | Can AI help scientists identify promising drug candidates?(MedChemBench) | OpenAI | https://openai.com/index/introducing-medchembench/ | 2026-11-20 | — |
| 17 | 四 | How Much Should an Agent Remember? Deployment Lessons from Self-Distilled Memory for LLM Agents | arXiv | https://arxiv.org/abs/2611.26361 | 2026-11-19(提交) | — |
| 18 | 四 | Seer: Guiding Small Deep-Research Agents with Shared Decision Models | arXiv | https://arxiv.org/abs/2611.26423 | 2026-11-19(提交) | — |
| 19 | 四 | ClosureBench: A Benchmark for Reasoning under Closure Assumptions | arXiv | https://arxiv.org/abs/2611.26335 | 2026-11-19(提交) | — |
| 20 | 四 | Realized versus Population Reliability: Anytime-Valid Self-Consistency Certification under Correlated Reasoning | arXiv | https://arxiv.org/abs/2611.26592 | 2026-11-19(提交) | — |
| 21 | 六 | riemann-hypothesis-lean(第三方镜像) | GitHub | https://github.com/CocoSgt/riemann-hypothesis-lean | 2026-11-20(建仓) | 2026-11-21 星数快照 |
| 22 | 六 | riemann-hypothesis(镜像 + Comparator 复现环境) | GitHub | https://github.com/Deicyde/riemann-hypothesis | 2026-11-20(建仓) | 2026-11-21 星数快照 |
| 23 | 六 | DIYgod/pinky v2026.1120.1 / v2026.1121.1 | GitHub | https://github.com/DIYgod/pinky/releases/tag/v2026.1120.1 | 2026-11-20 / 11-21 | 2026-11-21 星数快照 |
引用提醒:正文与附录中的数字均取自上述一手页面正文;厂商自测项已在正文标注「厂商自测、无独立复现」。arXiv 条目日期为 v1 提交日(2026-11-19),不是公告日——11-20 提交批次在本次运行时尚不可得。市场类数据为 2026-11-20 美股收盘口径,与公告发布日期同一天但含义不同。黎曼猜想一节截至 2026-11-21 09:56 HKT 只到「个人声明 + 代码公开」,无独立复核。三张配图为自绘示意图,非原文插图。